 IVGraph
問題所在:為什麼 Notion 會淪為筆記墳場
我的 Notion 裡有超過 1800 個頁面,包含專案、會議筆記、閱讀清單、聯絡人資料庫、計畫和文章草稿。
聽起來是個井然有序的系統。但實際上,我卻找不到自己寫過的內容。我經常發現自己前後相隔三個月建立了內容重複的筆記。我忘了自己已經研究過某個主題,又從零開始研究。
問題不在 Notion。我們寫作時是線性的(一個頁面接著一個頁面),思考時卻是聯想式的(一個想法連結到另一個想法)。Notion 以資料夾的階層結構儲存資料。但知識不是階層結構,而是網絡。
你的 Notion「死了」的三個徵兆:
- 重複筆記。 你建立了一則筆記,卻不知道另一個頁面上已經有類似的筆記。
- 遺漏的關聯。 兩個專案有所重疊,但因為放在不同資料夾裡,你看不出它們的關聯。
- 手動搜尋。 每次需要資訊時,你都希望自己能想起正確的關鍵字。
如果你在 Notion 裡有超過 200 個頁面,很可能至少遇過其中一種情況。我一步步解決了這個問題。先用大型語言模型(LLM),再用圖譜。
為什麼 Claude + Notion 能打造最好的第二大腦
大多數第二大腦系統都只停留在記筆記。加入能讀取你 Notion 內容的 LLM,就能隨時找回所需資訊——Claude 能依語意找出相關頁面,而不是靠標籤。這就是 Notion 儲存庫與真正的 Notion 上的 LLM 維基之間的差別:維基能回答問題,儲存庫只是儲存內容。
實際上,Claude Notion 第二大腦包含三項功能:大型語言模型能透過 MCP 即時存取你的工作空間、能將內容寫回工作空間,還能跨工作階段記住先前的脈絡。一般的 ChatGPT 自訂 GPT 不具備其中任何一項功能。
2026 年的第二大腦:大型語言模型帶來了哪些改變
第二大腦的概念早在大型語言模型出現前數年就已存在。Tiago Forte 提出了 CODE 方法:蒐集、整理、提煉、表達。
直到 2025 年,這套流程在提煉階段之前都能順利運作。蒐集與整理——很簡單。從數百則筆記中提煉重點——就沒那麼容易了。總是沒有足夠的時間做這件事。
大型語言模型解決了這個瓶頸:
| 階段 | 以前 | 現在(搭配 LLM) |
|---|---|---|
| 蒐集 | 複製到 Notion | 照舊,另外由 LLM 自動蒐集 |
| 整理 | 手動歸入資料夾 | LLM 建議標籤與關聯 |
| 提煉 | 自己閱讀並標記重點 | LLM 產生摘要與維基頁面 |
| 表達 | 從零開始撰寫 | LLM 掌握你的整個知識庫,協助撰寫 |
大型語言模型(LLM)能讀遍你的整個知識庫,找出你會忽略的規律。不是因為它比較聰明,而是因為它不會累。
三個層次:來源、維基、圖譜
2026 年四月,曾任 Tesla AI 負責人、也是 OpenAI 創辦人之一的 Andrej Karpathy,公開了一套他稱為 LLM Wiki 的模式。概念很簡單:與其讓 LLM 每次都重新讀取原始文件,不如請它將你的資料預先編譯成結構化的維基。這套做法很快就在 AI 社群中獲得廣泛採用,而我自己的系統也是以此為基礎打造的。
┌─────────────────────────────────┐
│  1. RAW SOURCES (immutable)     │  PDFs, articles, transcripts
│     You only add                │  LLM only reads
├─────────────────────────────────┤
│  2. WIKI (LLM writes & maintains)│  Summaries, concepts,
│     You read and ask            │  timelines, crosslinks
│     questions                   │
├─────────────────────────────────┤
│  3. GRAPH (visualization)       │  Nodes = pages
│     You explore visually        │  Edges = connections
└─────────────────────────────────┘
實際操作時,你把一份 PDF 報告放進資料夾。Claude Code 會讀取報告、擷取關鍵概念,建立包含摘要的維基頁面,並加入連往現有相關頁面的連結。
為什麼這比一般搜尋更好
標準做法(RAG)是在每次查詢時搜尋相關文字片段,將它們放入上下文,再產生回應。每次查詢都從零開始,不會累積任何資訊。
維基式的做法則不同。LLM 會將資訊整合一次,並儲存結果。下一次查詢會以已整合的內容為基礎。知識因此產生複利效應——就像複利,只不過累積的是資訊。
LLM 第二大腦與傳統個人知識管理(PKM)的比較
傳統的 PKM(個人知識管理)架構透過資料夾、標籤和 MOC 頁面來整理筆記。第二大腦 LLM 則更進一步,根據這些筆記回答問題。建構於其上的 3D 知識圖譜就是橋梁:它呈現 LLM 所看到的結構,讓你發現只靠肉眼會忽略的群集與缺口。
如果你搜尋 「llm 第二大腦」或 「第二大腦 llm」,期待找到比靜態範本更好的選擇——差別就在這裡。你的第二大腦終於有了推理迴路。
我的工具組合:Notion + Claude Code + IVGraph
我用自己的筆記嘗試這個方法時,整套工具是這樣搭配的:
| 組成項目 | 工具 | 用途 |
|---|---|---|
| 儲存 | Notion | 筆記、資料庫、文件 |
| 整合 | Claude Code | 閱讀、分析、產生維基 |
| 視覺化 | IVGraph | 呈現頁面之間連結的 3D 圖譜 |
Notion——因為我的 1800+ 個頁面都已經在這裡了。遷移到 Obsidian 得花上好幾個月的時間。
Claude Code — 直接在終端機中運作,原生支援讀取檔案,並能跨工作階段記住脈絡。它不是聊天機器人,而是能運用你的資料的工具。
IVGraph — Notion 不像 Obsidian,沒有內建圖譜。IVGraph 將你的工作空間轉換成互動式 3D 圖譜,並提供語意搜尋功能。
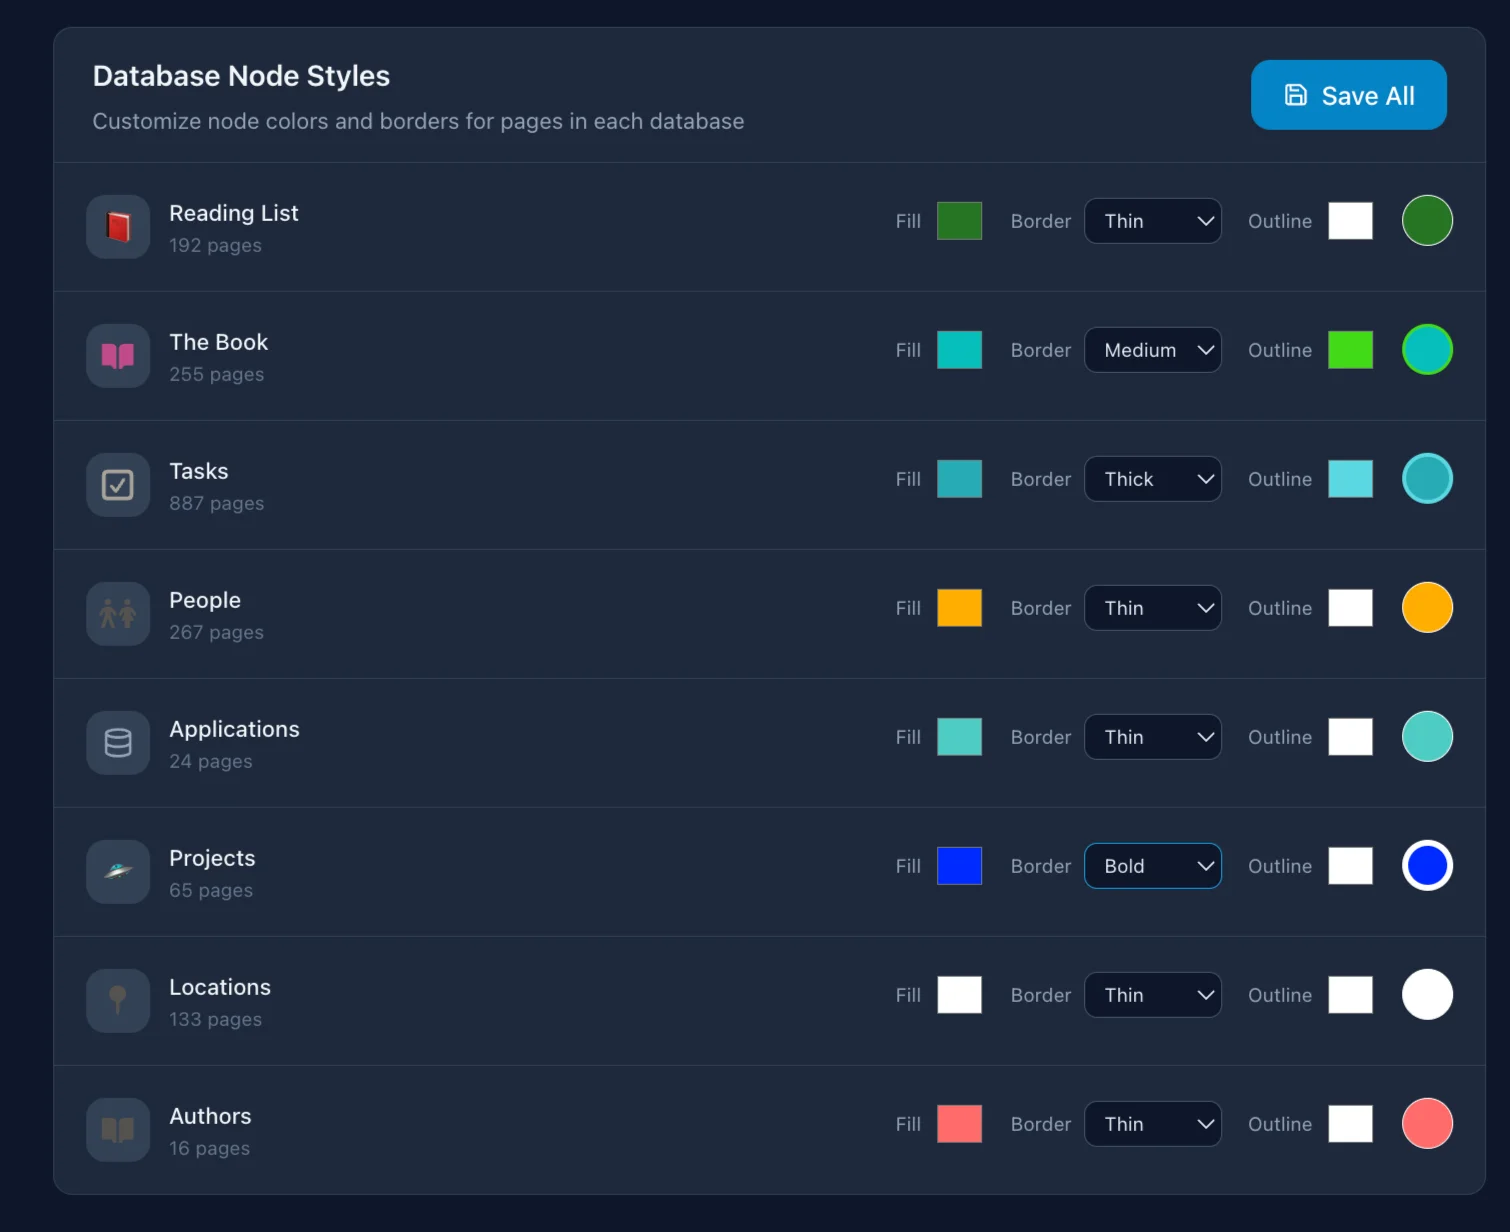
以 Notion 作為原始資料層
在這套系統中,Notion 是儲存層。你仍然照常在 Notion 中工作。唯一值得調整的做法,就是有意識地將頁面彼此連結。
| 連結類型 | 建立方式 | 範例 |
|---|---|---|
| 提及 | 在文字中輸入 @page_name | 「在 @團隊會議 中討論過」 |
| 關聯 | 資料庫屬性 | 專案 → 任務 |
| 上層頁面 | 巢狀頁面 | 資料夾 → 頁面 |
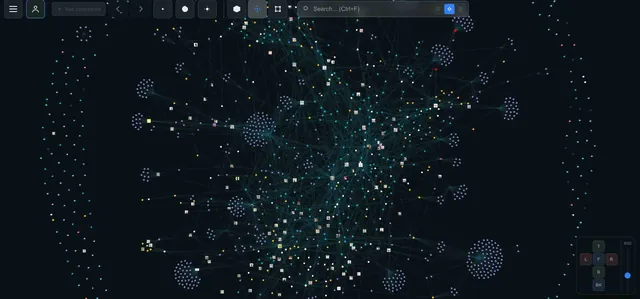
我有一個「專案」資料庫,裡面有 40+ 個專案。每個專案都透過關聯連結到「任務」資料庫。IVGraph 根據這些資料建立圖譜後,我發現其中 6 個專案形成了緊密的群集,儘管它們位於不同的資料夾中。這些資訊原本埋藏在關聯屬性裡,而我從未整體檢視過這些屬性。
你不需要特殊的架構或標籤,也不必把內容整理得井然有序。大型語言模型即使面對雜亂的內容,也能處理得很好。
Claude Code:整合資訊與找出關聯
Claude Code 在我的工作流程中扮演什麼角色
摘要與統整。 我上傳一份長篇文件 → Claude 產生摘要,並將摘要連結到現有筆記。上週我上傳了一份 40 頁的報告,只花 2 分鐘就得到一個頁面,包含 8 項重點,以及 4 個連到我筆記的連結,這些筆記的內容與報告中的發現有所重疊。
缺口分析。「我對分散式系統了解哪些內容?」→ Claude 檢視我的筆記,顯示哪些主題已涵蓋、哪些尚未涵蓋。
每週摘要。一週內的所有變動:新增的筆記、更新的專案、逾期任務。
交叉連結。 Claude 會找出應該互相連結、卻尚未連結的頁面。有一次,它找到了我已經忘記的兩篇 SEO 分析筆記,兩篇的撰寫時間相隔 4 個月。將它們連結起來後,我對整體有了更完整的了解。
如何將 LLM 整合至 Notion(透過 MCP)
透過 MCP(模型上下文協定),只需一個指令:
claude mcp add --transport http notion https://mcp.notion.com/mcp完成後,Claude Code 就能讀取頁面、建立新頁面、更新資料庫屬性,以及搜尋內容。如需了解所有連線選項,包括 Claude Desktop、Cursor、自行架設的伺服器與權限,請參閱我們的完整 Notion MCP 指南。
CLAUDE.md — 不必重複交代背景
放在專案根目錄的檔案,Claude Code 每次啟動時都會讀取:
# My Notion workspace
- Always cite the source when creating summaries
- Link new notes via @mentions
- Projects DB: 40+ projects, linked to Tasks via Relation
不必每次都說明背景。記憶檔案也能在不同工作階段之間保留洞見,讓每個工作階段都能在前一個的基礎上持續累積。
圖譜——缺少的那塊拼圖
文字是線性的,資料庫呈表格形式,但知識是一張網。
圖譜帶給我的收穫
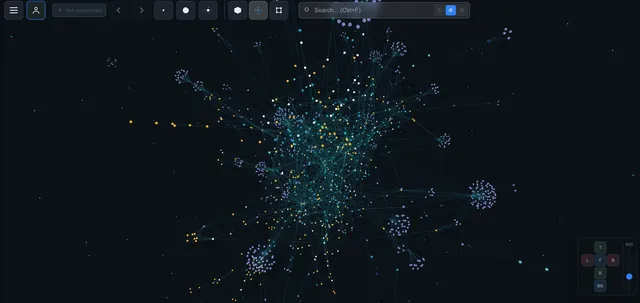
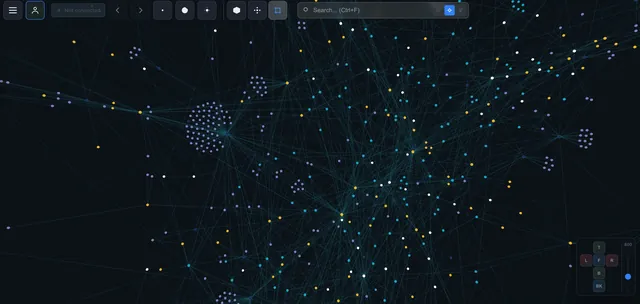
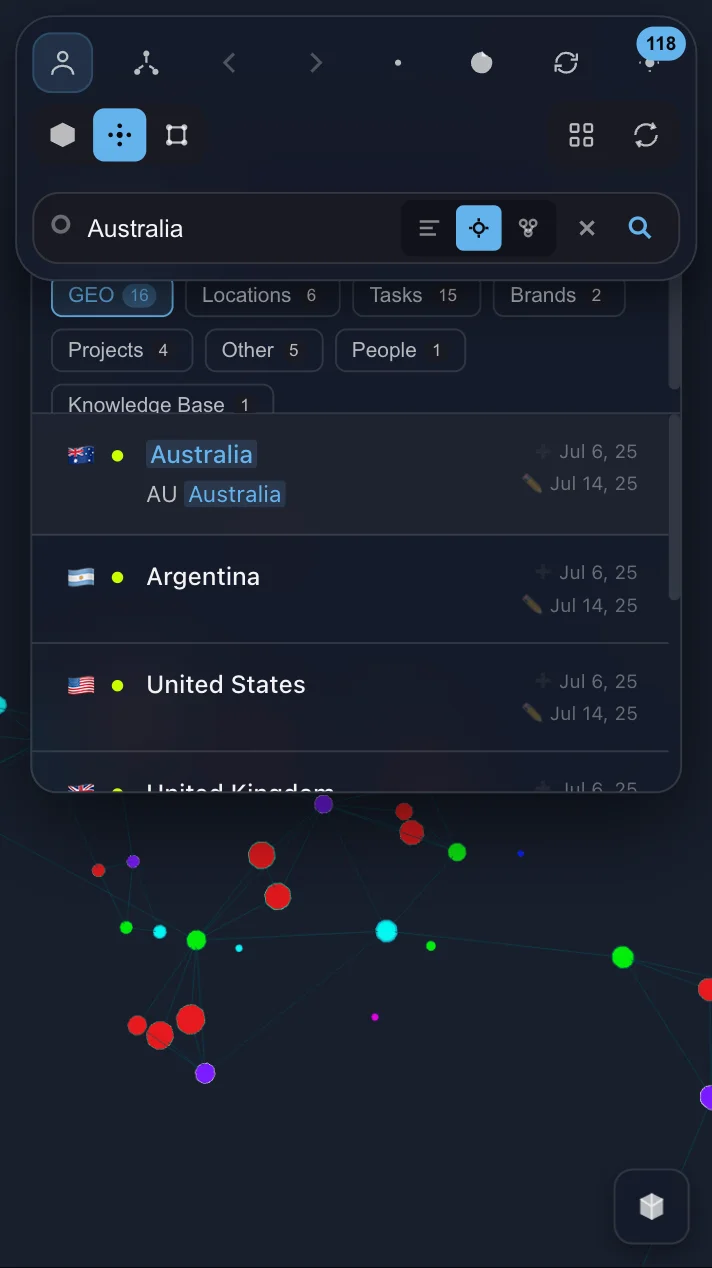
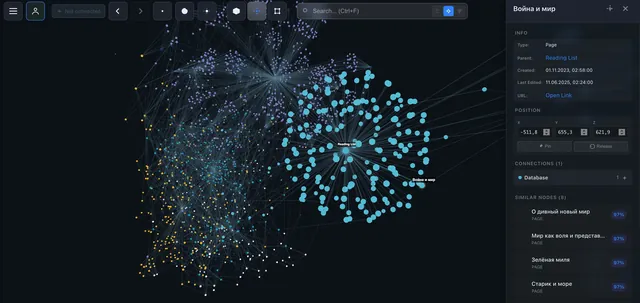
群集。1800 個頁面呈現在 3D 圖譜中,哪些群組連結緊密,一眼就看得出來。我的「行銷」和「資料分析」筆記形成了兩個獨立的群集,彼此之間只有一條連結。我幾秒內就發現了這一點;沒有圖譜的話,我可能好幾個月都不會注意到。
知識缺口。 如果兩個群集距離很近,彼此卻鮮少連結,那就是知識缺口。圖譜不只呈現你已知的內容,也讓你看見自己還不知道的部分。
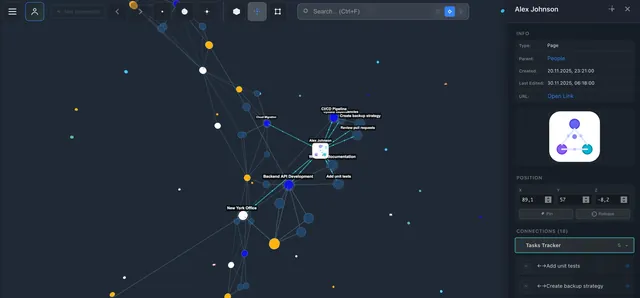
意外的收穫。在 Notion 裡,你搜尋;在圖譜裡,你漫遊。我點了某個專案中的一個節點,注意到一個通往某篇早已忘記的筆記的連結——就這樣找到了讓我卡關一週的問題的解法。
運作方式
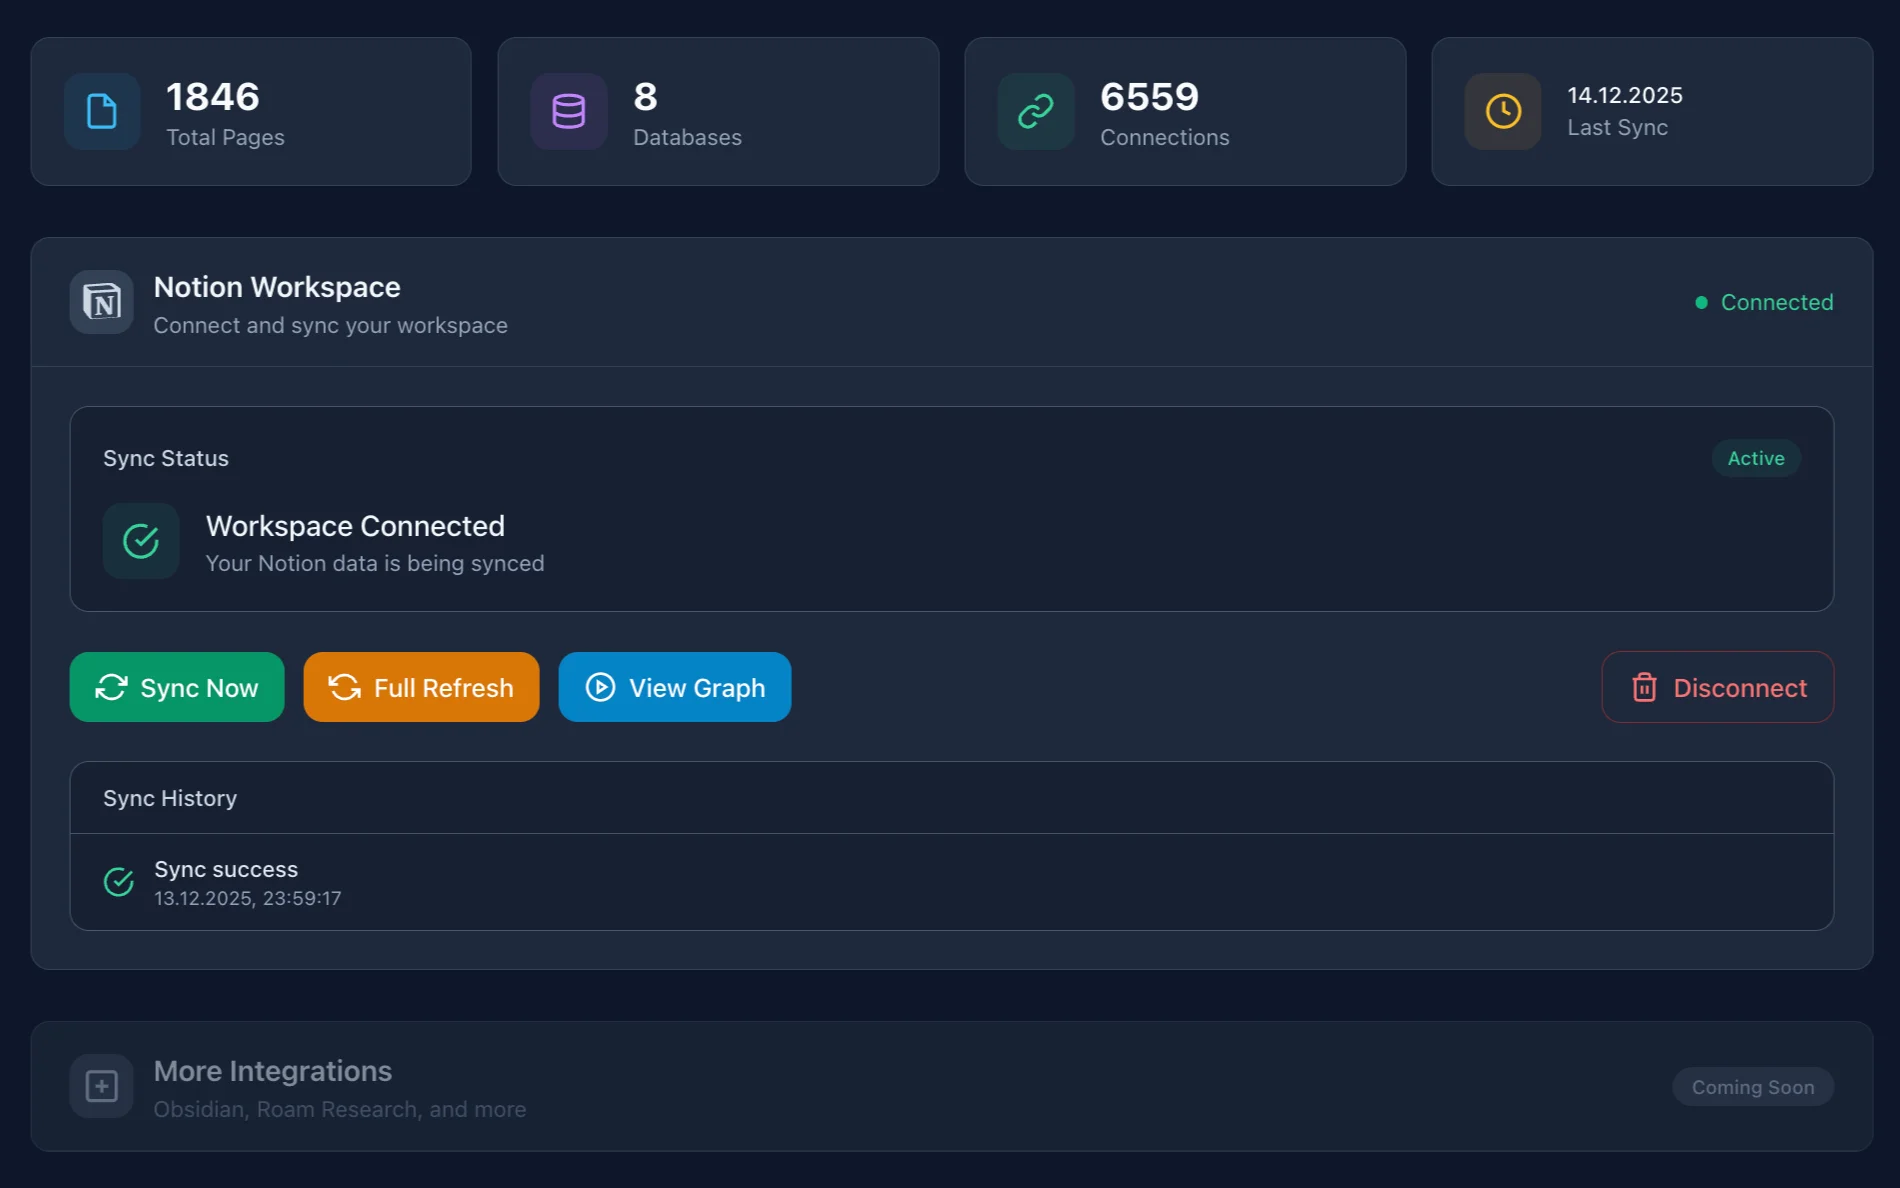
- 透過 OAuth 連接 Notion
- IVGraph 同步資料(頁面、資料庫、屬性、連結)
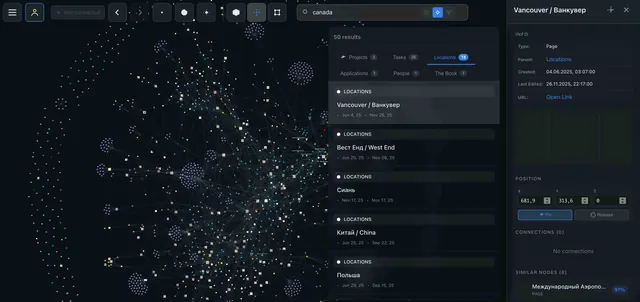
- 建立圖譜:節點 = 頁面,連線 = 提及/關聯/父子關係
- 以互動式 3D 呈現
同步採用增量方式。首次匯入 1800 個頁面約需 5 分鐘,之後只會更新有變更的內容。
我的日常工作流程
早晨(5 分鐘)
我打開 IVGraph,馬上就能看到哪些筆記更新了,再查看目前專案的群集。如果有內容吸引我的注意,就點開來讀。早上花 5 分鐘,之後就能省下一小時的搜尋時間。
主題研究(15-30 分鐘)
為討論 SEO 策略做準備:
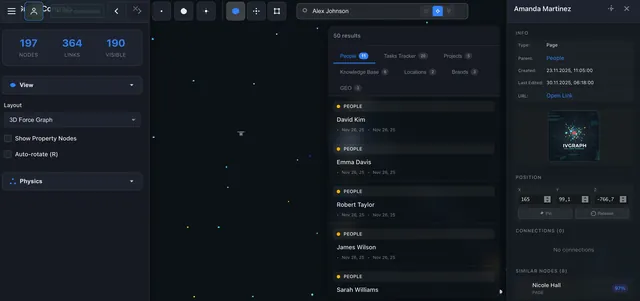
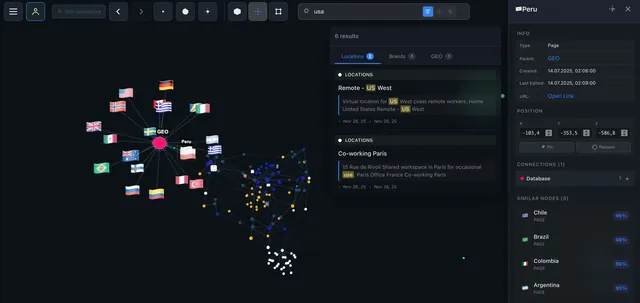
- 在 IVGraph 搜尋「SEO」——語意搜尋不只會找到含有這個詞的頁面,也會找出語意相關的頁面
- 從圖中找出群集——看看哪些主題彼此接近、哪些相距較遠
- 問 Claude Code:「從這 12 個頁面整理出我對 SEO 的所有知識,指出其中的缺口」
- Claude 回覆:「你沒有任何針對 SPAs 的技術 SEO 內容」
- 現在我清楚知道該研究什麼了
週日回顧(30 分鐘)
- Claude Code 分析這週新增的筆記(通常有 5-15 個頁面)
- 建議交叉連結——經常能找出 3-5 個我沒想到的連結
- 更新有變動的主題摘要
- 我檢閱並確認
真正的價值不在於連結本身,而在於我會定期從整體的視角檢視自己的知識庫。
Notion 與 Obsidian:該怎麼選?
| 比較項目 | Obsidian | Notion |
|---|---|---|
| 檔案 | Markdown(本機) | 雲端(API) |
| LLM 存取 | 直接存取 | 透過 MCP |
| 圖譜 | 2D(內建) | 3D(透過 IVGraph) |
| 協作 | Git / Sync | 內建 |
| 資料庫 | 無 | 原生支援 |
Obsidian——適合獨自工作、想要完全掌控的人。它有 Smart Connections(語意搜尋)、Copilot(RAG 對話)、claude-obsidian(維基+自動研究)。如果我從零開始,大概會選它。
Notion — 如果你有團隊、真正的資料庫,而且資料已經在 Notion 裡。
我試著混合使用了三個月,後來又回到只用 Notion——兩套儲存系統造成的問題比解決的問題還多。
使用限制與入門指南
哪些方法行不通
LLM 會出錯。 Claude 曾把「Python 裝飾器」和「室內裝潢」連在一起,因為兩者都包含「decorator」這個字。請務必確認自動建立的交叉連結是否正確。
上下文容量有限。Claude 無法一次讀取全部 1800 個頁面。解決方式是查詢某個節點在 1-3 次跳轉內可達的鄰近節點,而非整個知識庫。
首次設定需要 15-30 分鐘。雖然無法立即完成,但只需設定一次。
前幾次使用時,3D 圖譜會讓你迷失方向。之後,你就能快速瀏覽。
我最大的心得是:別怕筆記雜亂。LLM 和圖譜能從看似混亂的內容中梳理出結構。
15 分鐘,三步驟
1. 將 Claude Code 連接至 Notion(5 分鐘)
claude mcp add --transport http notion https://mcp.notion.com/mcp2. 試著進行第一次查詢(5 分鐘)
「讀取我的 Notion 工作空間。找出 5 個語意相關、但彼此沒有連結的頁面。」
3. 將連結視覺化(5 分鐘)
前往 ivgraph.com,連結你的工作空間。
找出孤立的節點——那些就是被遺忘的筆記。點選最大的節點——那就是你的知識「樞紐」。從那裡開始,動手試試看。
先從圖譜開始,再搭配大型語言模型(LLM),兩週左右,你就會發現自己運用筆記的方式已經截然不同。
把 Notion 當作原始輸入資料、Claude Code 當作撰寫者,圖譜則作為索引。這套組合——一套適用於 Notion 的 LLM 維基,再加上 3D 知識圖譜——正是本文從頭到尾完整記錄的架構。同樣的配置也說明了為什麼人們會搜尋 「知識圖譜 Claude」:圖譜是 Claude 進行推理的依據,不只是裝飾。
常見問題
什麼是 LLM wiki?
LLM wiki 是由 LLM 為你編纂並維護的知識庫:模型不會在每次查詢時重新閱讀原始文件,而是事先將文件整理成結構化、彼此交互連結的 wiki 頁面,再根據這一層內容回答問題。這個詞源自 Andrej Karpathy 在 2026 年 4 月描述此模式的筆記;本文則以 Notion 為基礎,實作這個模式。若想完整了解這個概念本身,包括架構、與 RAG 的比較,以及建置方式,請參閱〈什麼是 LLM Wiki?解析 Karpathy 的模式〉。
LLM 維基與第二大腦有什麼不同?
第二大腦是一種更廣泛的知識管理實踐,將知識儲存、整理在大腦之外(Tiago Forte 的 CODE 方法)。LLM 維基則是將其中的提煉階段交由 LLM 執行的成果:由模型撰寫並維護摘要、交叉連結和時間軸。簡單來說,每個 LLM 維基都是第二大腦的一部分,但並非每個第二大腦的維基層都由 LLM 撰寫。
不用 Claude 也能建立 LLM 維基嗎?
可以。只要模型能透過 MCP 或 API 讀取你的工作空間,並將頁面寫回,就能使用這套方法,不受特定模型限制。Claude Code 最適合我的使用環境,因為它能在終端機中執行、跨工作階段保留上下文,而且只需一個 MCP 指令就能連接 Notion。開發者也可以透過 IVGraph LLM API 直接查詢圖譜層。
該從哪裡開始?
如果你的工作空間已經在 Notion 上:先連接圖譜(需 3 分鐘,500 個節點以內免費),再將 MCP 連線加入你的大型語言模型(LLM)。如果你還在挑選工具,可以先閱讀Notion 有圖譜檢視嗎?和Notion 知識圖譜終極指南。