 IVGraph
O problema: por que o Notion vira um cemitério de anotações
Tenho mais de 1800 páginas no Notion. Projetos, notas de reuniões, listas de leitura, bancos de dados de contatos, planos, rascunhos de artigos.
Parece um sistema bem organizado. Na prática — eu já não encontrava o que tinha escrito. Vivia me deparando com notas duplicadas que eu tinha criado com três meses de intervalo. Esquecia que já tinha pesquisado um assunto e começava tudo do zero.
O problema não é o Notion. Escrevemos de forma linear (página após página), mas pensamos por associação (uma ideia se conecta a outra). O Notion armazena dados em hierarquias de pastas. Mas o conhecimento não é uma hierarquia. É uma rede.
Três sintomas de que seu Notion está "morto":
- Duplicatas. Você cria uma nota sem saber que já existe uma parecida em outra página.
- Conexões perdidas. Dois projetos têm pontos em comum, mas você não consegue ver isso — eles estão em pastas diferentes.
- Busca manual. Toda vez que precisa de uma informação, você torce para lembrar as palavras-chave certas.
Se você tem mais de 200 páginas no Notion, provavelmente já se deparou com pelo menos uma dessas situações. Resolvi esse problema passo a passo. Primeiro, um LLM. Depois, o grafo.
Por que Claude + Notion cria o melhor segundo cérebro
A maioria dos sistemas de segundo cérebro se limita a fazer anotações. Adicionar um LLM que lê o conteúdo do seu Notion permite que você recupere informações quando precisar — o Claude pode buscar páginas relacionadas pelo significado, não por tags. Essa é a diferença entre um repositório no Notion e uma verdadeira wiki com LLM no Notion: a wiki responde, o repositório só armazena.
Um segundo cérebro no Notion com Claude significa três coisas na prática: o LLM tem acesso em tempo real ao seu espaço de trabalho via MCP, pode gravar informações nele e se lembra do contexto anterior de uma sessão para outra. Nada disso se aplica a um GPT personalizado comum do ChatGPT.
Segundo cérebro em 2026: o que os LLMs mudaram
O conceito de segundo cérebro surgiu anos antes dos LLMs. Tiago Forte formulou o método CODE: Capturar, Organizar, Destilar, Expressar.
Até 2025, isso funcionava bem até chegar à etapa de Destilar. Capturar e organizar — fácil. Extrair os pontos principais de centenas de notas — nem tanto. Nunca há tempo suficiente para isso.
Os LLMs eliminaram esse gargalo:
| Etapa | Antes | Agora (com LLM) |
|---|---|---|
| Capturar | Copiar para o Notion | O mesmo + o LLM coleta automaticamente |
| Organizar | Organizar manualmente em pastas | O LLM sugere tags e conexões |
| Sintetizar | Ler e destacar trechos por conta própria | O LLM cria resumos e páginas de wiki |
| Expressar | Escrever do zero | O LLM ajuda, conhecendo toda a sua base |
Um LLM pode ler toda a sua base de conhecimento e encontrar padrões que você deixaria passar. Não porque seja mais inteligente — mas porque não se cansa.
Três camadas: fontes, wiki e grafo
Em abril de 2026, Andrej Karpathy — ex-diretor de IA da Tesla e um dos fundadores da OpenAI — publicou um padrão que chamou de LLM Wiki. A ideia é simples: em vez de fazer o LLM reler os documentos brutos toda vez, você pede que ele pré-compile seus materiais em uma wiki estruturada. A abordagem rapidamente ganhou força na comunidade de IA — e é nela que meu próprio sistema se baseia.
┌─────────────────────────────────┐
│  1. RAW SOURCES (immutable)     │  PDFs, articles, transcripts
│     You only add                │  LLM only reads
├─────────────────────────────────┤
│  2. WIKI (LLM writes & maintains)│  Summaries, concepts,
│     You read and ask            │  timelines, crosslinks
│     questions                   │
├─────────────────────────────────┤
│  3. GRAPH (visualization)       │  Nodes = pages
│     You explore visually        │  Edges = connections
└─────────────────────────────────┘
Na prática: você coloca um relatório em PDF em uma pasta. Claude Code lê o arquivo, extrai os principais conceitos, cria uma página wiki com um resumo e adiciona links para páginas relacionadas que já existem.
Por que isso é melhor que a busca comum
A abordagem padrão (RAG) busca trechos de texto relevantes a cada consulta, insere esses trechos no contexto e responde. Cada consulta começa do zero. Nada se acumula.
A abordagem de wiki funciona de outro jeito. O LLM sintetiza as informações uma única vez e as salva. A próxima consulta parte do que já foi sintetizado. O conhecimento gera mais conhecimento — como juros compostos, mas para informações.
Segundo cérebro com LLM vs. gestão tradicional do conhecimento pessoal
Uma estrutura tradicional de PKM (gestão pessoal do conhecimento) organiza suas notas — pastas, tags e páginas MOC. Um LLM como segundo cérebro vai um passo além e responde com base nelas. O grafo de conhecimento 3D sobreposto a essa estrutura é a ponte: ele mostra como o LLM enxerga a estrutura, para que você possa identificar agrupamentos e lacunas que não perceberia apenas olhando.
Se você pesquisou por "llm segundo cérebro" ou "segundo cérebro llm" esperando encontrar algo melhor do que um modelo estático — é aqui que está a diferença. Seu segundo cérebro finalmente tem um ciclo de raciocínio.
Minhas ferramentas: Notion + Claude Code + IVGraph
Quando experimentei essa abordagem com minhas próprias anotações, a combinação de ferramentas ficou assim:
| Componente | Ferramenta | Função |
|---|---|---|
| Armazenamento | Notion | Notas, bancos de dados, documentos |
| Síntese | Claude Code | Leitura, análise, geração de wiki |
| Visualização | IVGraph | Grafo 3D de conexões entre páginas |
Notion — porque minhas 1800+ páginas já estão lá. Migrar para o Obsidian levaria meses de trabalho.
Claude Code — funciona diretamente no terminal, lê arquivos de forma nativa e mantém o contexto entre sessões. Não é um chatbot — é uma ferramenta que trabalha com seus dados.
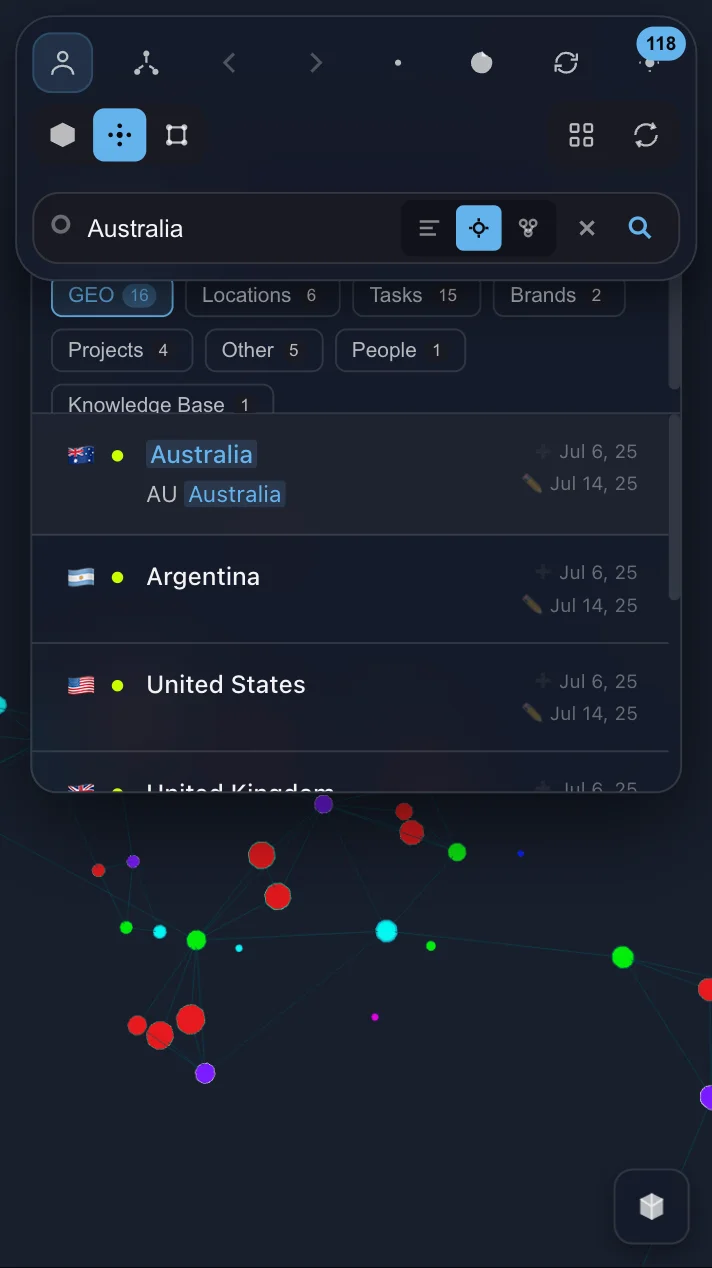
IVGraph — O Notion não tem um grafo integrado (ao contrário do Obsidian). O IVGraph transforma seu espaço de trabalho em um grafo 3D interativo com busca semântica.
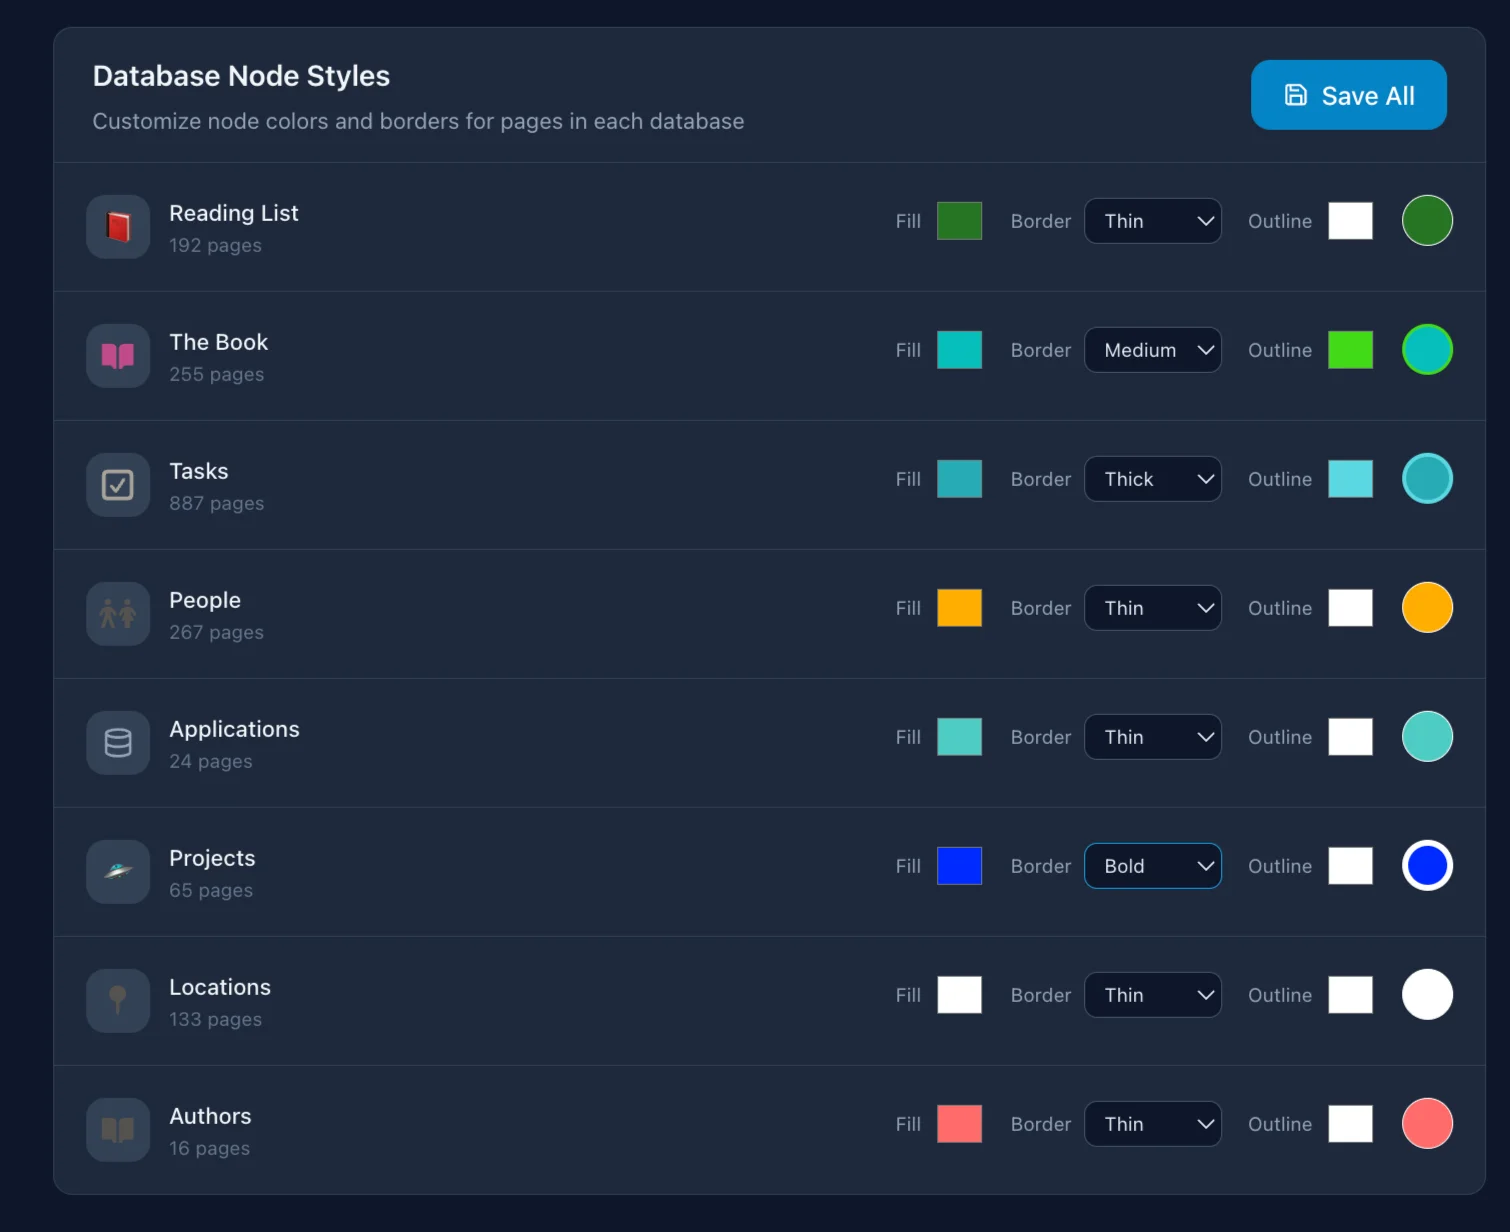
Notion como camada de dados brutos
Neste sistema, o Notion é a camada de armazenamento. Você continua trabalhando nele como sempre. A única mudança que vale a pena fazer é vincular as páginas umas às outras de forma intencional.
| Tipo de conexão | Como criar | Exemplo |
|---|---|---|
| Menção | @page_name no texto | "Discutido na @Reunião da equipe" |
| Relação | Propriedade de banco de dados | Projeto → Tarefas |
| Página pai | Páginas aninhadas | Pasta → Página |
Tenho um banco de dados chamado "Projetos" com 40+ projetos. Cada um está vinculado a um banco de dados chamado "Tarefas" por meio de uma Relação. Quando o IVGraph criou um grafo a partir disso, vi que 6 projetos formavam um grupo coeso, embora estivessem em pastas diferentes. Esse conhecimento estava escondido em propriedades de Relação que eu nunca tinha consultado em conjunto.
Você não precisa de uma estrutura especial, tags ou uma organização perfeita. O LLM lida bem com o caos.
Claude Code: síntese e descoberta de conexões
O que o Claude Code faz no meu fluxo de trabalho
Resumos e síntese. Eu envio um documento longo → Claude cria um resumo e o vincula a notas existentes. Na semana passada, enviei um relatório de 40 páginas — em 2 minutos, recebi uma página com 8 pontos principais e 4 links para minhas notas que tinham pontos em comum com as conclusões do relatório.
Análise de lacunas. "O que eu sei sobre sistemas distribuídos?" → Claude analisa minhas notas e mostra quais tópicos foram abordados e quais não foram.
Resumo semanal. Tudo o que mudou durante a semana: novas notas, projetos atualizados, tarefas atrasadas.
Conexões entre páginas. Claude encontra páginas que deveriam estar conectadas, mas não estão. Uma vez, encontrou duas das minhas notas de análise de SEO, escritas com 4 meses de intervalo, das quais eu tinha me esquecido. Conectá-las me deu uma visão mais completa.
Como integrar um LLM ao Notion (via MCP)
Um único comando via MCP (Protocolo de Contexto de Modelo):
claude mcp add --transport http notion https://mcp.notion.com/mcpDepois disso, o Claude Code pode ler páginas, criar novas páginas, atualizar propriedades de bancos de dados e pesquisar conteúdo. Para conhecer todas as opções de conexão — Claude Desktop, Cursor, servidor auto-hospedado, permissões — consulte nosso guia completo do Notion MCP.
CLAUDE.md — Contexto sem repetição
Um arquivo na raiz do projeto que o Claude Code lê sempre que é iniciado:
# My Notion workspace
- Always cite the source when creating summaries
- Link new notes via @mentions
- Projects DB: 40+ projects, linked to Tasks via Relation
Você não precisa explicar o contexto toda vez. E os arquivos de memória preservam os insights entre sessões: cada uma aproveita o que foi construído na anterior.
O grafo — A peça que faltava
O texto é linear. Os bancos de dados são tabulares. Mas o conhecimento é uma rede.
O que o grafo me proporcionou
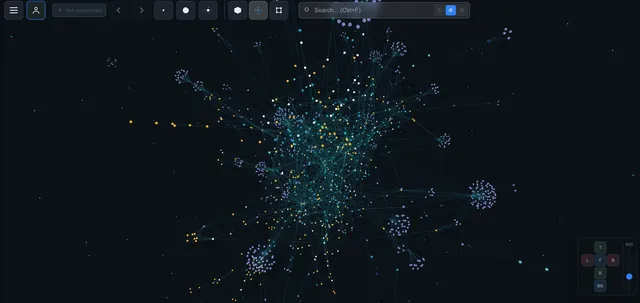
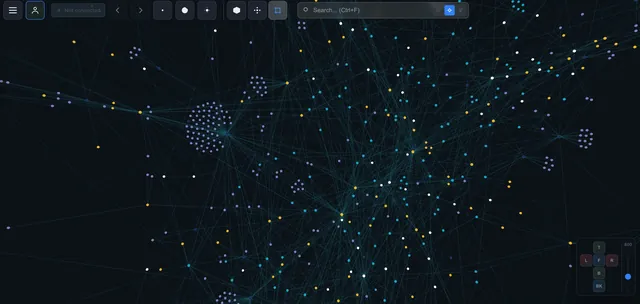
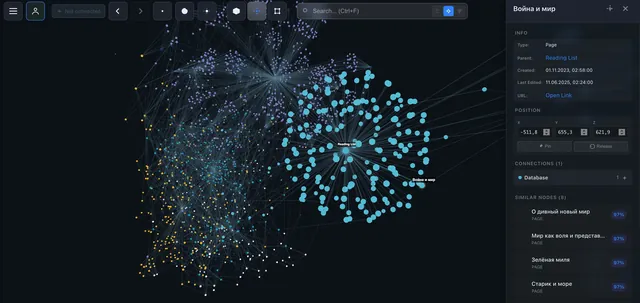
Agrupamentos. 1800 páginas em um grafo 3D — e você vê imediatamente quais grupos estão fortemente conectados. Minhas notas de "marketing" e "análise de dados" formaram dois agrupamentos separados, com uma única conexão entre eles. Percebi isso em segundos — sem o grafo, talvez eu levasse meses para notar.
Lacunas. Se dois agrupamentos estão próximos, mas têm poucas conexões entre si — isso é uma lacuna de conhecimento. O grafo mostra não só o que você sabe, mas também o que você não sabe.
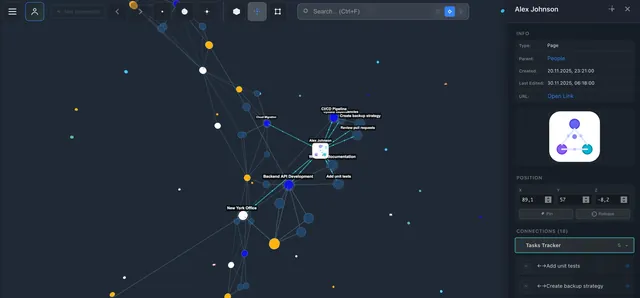
Descobertas por acaso. No Notion, você busca. No grafo, você passeia. Cliquei em um nó de um projeto, vi um link para uma anotação esquecida — e encontrei a solução para um problema em que eu estava empacado havia uma semana.
Como funciona
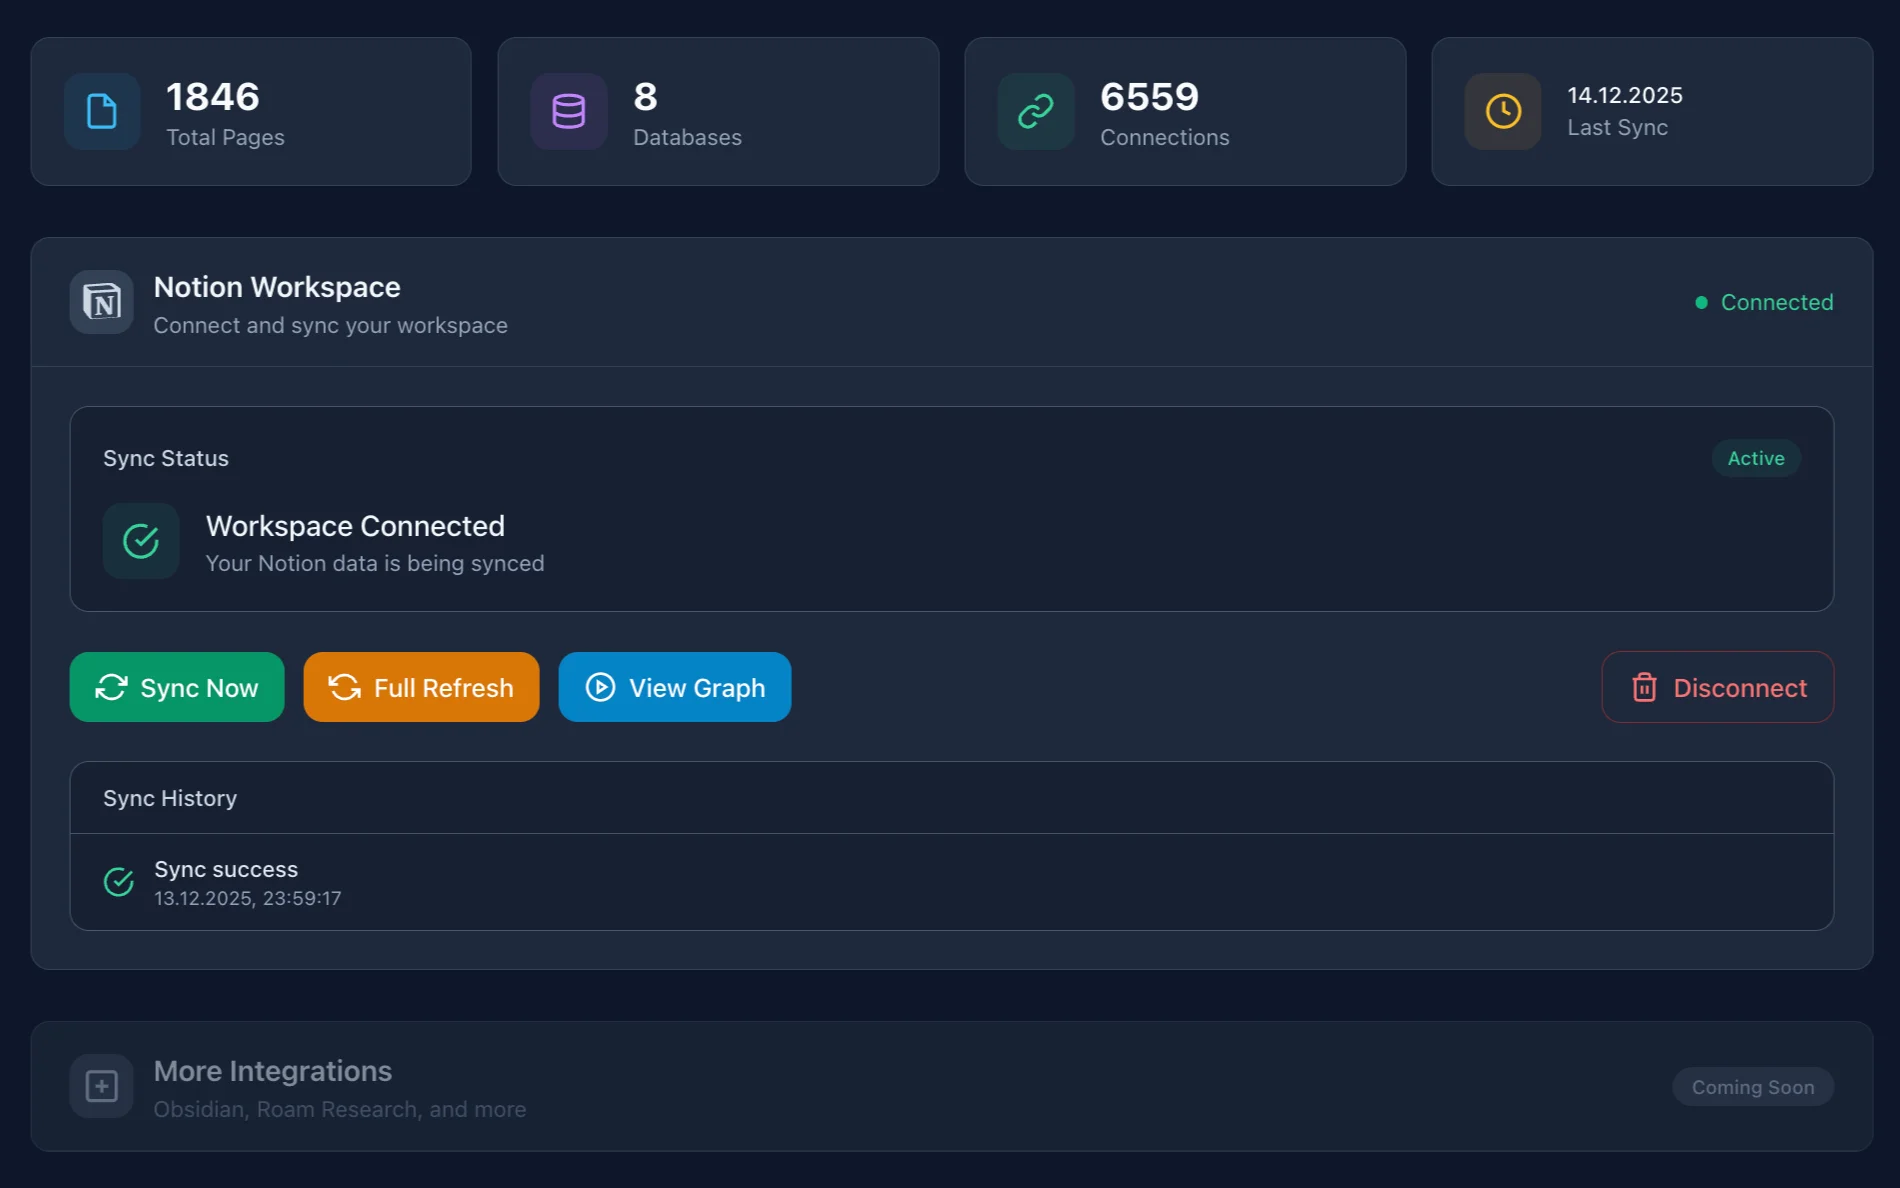
- Conecte o Notion via OAuth
- O IVGraph sincroniza os dados (páginas, bancos de dados, propriedades, conexões)
- Cria um grafo: nós = páginas, arestas = menções/Relações/pai-filho
- Renderiza em 3D interativo
A sincronização é incremental. A primeira importação de 1800 páginas leva cerca de 5 minutos. Depois disso, apenas as alterações são sincronizadas.
Meus fluxos de trabalho diários
Manhã (5 minutos)
Abro o IVGraph e vejo na hora quais notas foram atualizadas. Confiro o agrupamento do meu projeto atual. Se algo chama minha atenção, clico e leio. 5 minutos pela manhã economizam uma hora de busca depois.
Pesquisa sobre um tema (15-30 minutos)
Preparando-se para uma conversa sobre estratégia de SEO:
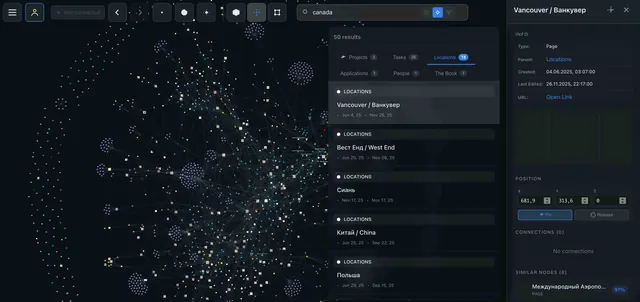
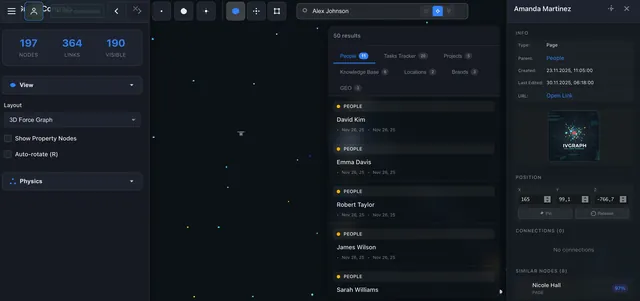
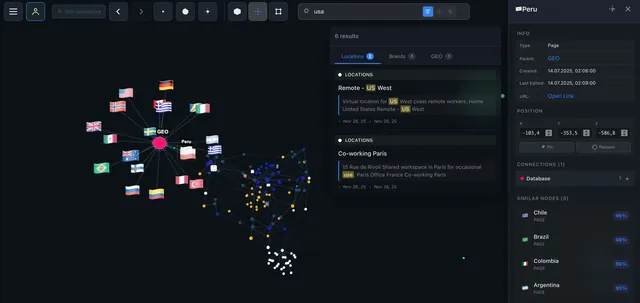
- Busque "SEO" no IVGraph — a busca semântica encontra não só páginas com essa palavra, mas também páginas semanticamente relacionadas
- Localize visualmente o agrupamento — veja quais temas estão próximos e quais estão distantes
- Peça ao Claude Code: "Reúna tudo o que eu sei sobre SEO a partir destas 12 páginas. Mostre o que está faltando"
- Claude responde: "Você não tem nada sobre SEO técnico para SPAs"
- Agora sei exatamente o que pesquisar
Revisão de domingo (30 minutos)
- Claude Code analisa as novas anotações da semana (geralmente 5-15 páginas)
- Sugere links cruzados — costuma encontrar 3-5 conexões que eu não tinha considerado
- Atualiza os resumos dos tópicos que mudaram
- Eu reviso e confirmo
O verdadeiro valor não está nos links em si — está em ter regularmente uma visão panorâmica da minha base de conhecimento.
Notion vs Obsidian: como escolher
| Critérios | Obsidian | Notion |
|---|---|---|
| Arquivos | Markdown (local) | Nuvem (API) |
| Acesso por LLM | Direto | Via MCP |
| Grafo | 2D (integrado) | 3D (via IVGraph) |
| Colaboração | Git / Sync | Integrada |
| Bancos de dados | Não | Nativos |
Obsidian — se você trabalha sozinho e quer controle total. Ele tem Smart Connections (busca semântica), Copilot (chat com RAG), claude-obsidian (wiki + pesquisa automática). Se eu estivesse começando do zero, provavelmente escolheria o Obsidian.
Notion — se você tem uma equipe, bancos de dados de verdade e seus dados já estão lá.
Testei uma abordagem híbrida por três meses. Voltei a usar só o Notion — dois sistemas de armazenamento criaram mais problemas do que resolveram.
Limitações e primeiros passos
O que não funciona
LLMs cometem erros. Certa vez, Claude vinculou "decoradores em Python" a "decoração de interiores" — ambos continham a palavra "decorator". Sempre verifique os links cruzados automáticos.
O contexto é limitado. Claude não consegue ler todas as 1800 páginas de uma vez. A solução — consultar a vizinhança de um nó (1-3 saltos), não a base inteira.
A configuração inicial leva 15-30 minutos. Não é instantânea, mas você só precisa fazer isso uma vez.
O grafo 3D causa desorientação nas primeiras duas sessões. Depois disso, você navega com rapidez.
Minha principal conclusão: não tenha medo de anotações bagunçadas. O LLM e o grafo extraem uma estrutura do que parece ser um caos.
Três etapas em 15 minutos
1. Conecte o Claude Code ao Notion (5 minutos)
claude mcp add --transport http notion https://mcp.notion.com/mcp2. Experimente fazer sua primeira consulta (5 minutos)
"Leia meu espaço de trabalho no Notion. Encontre 5 páginas relacionadas em termos de significado, mas que não tenham links entre si."
3. Visualize as conexões (5 minutos)
Acesse ivgraph.com e conecte seu espaço de trabalho.
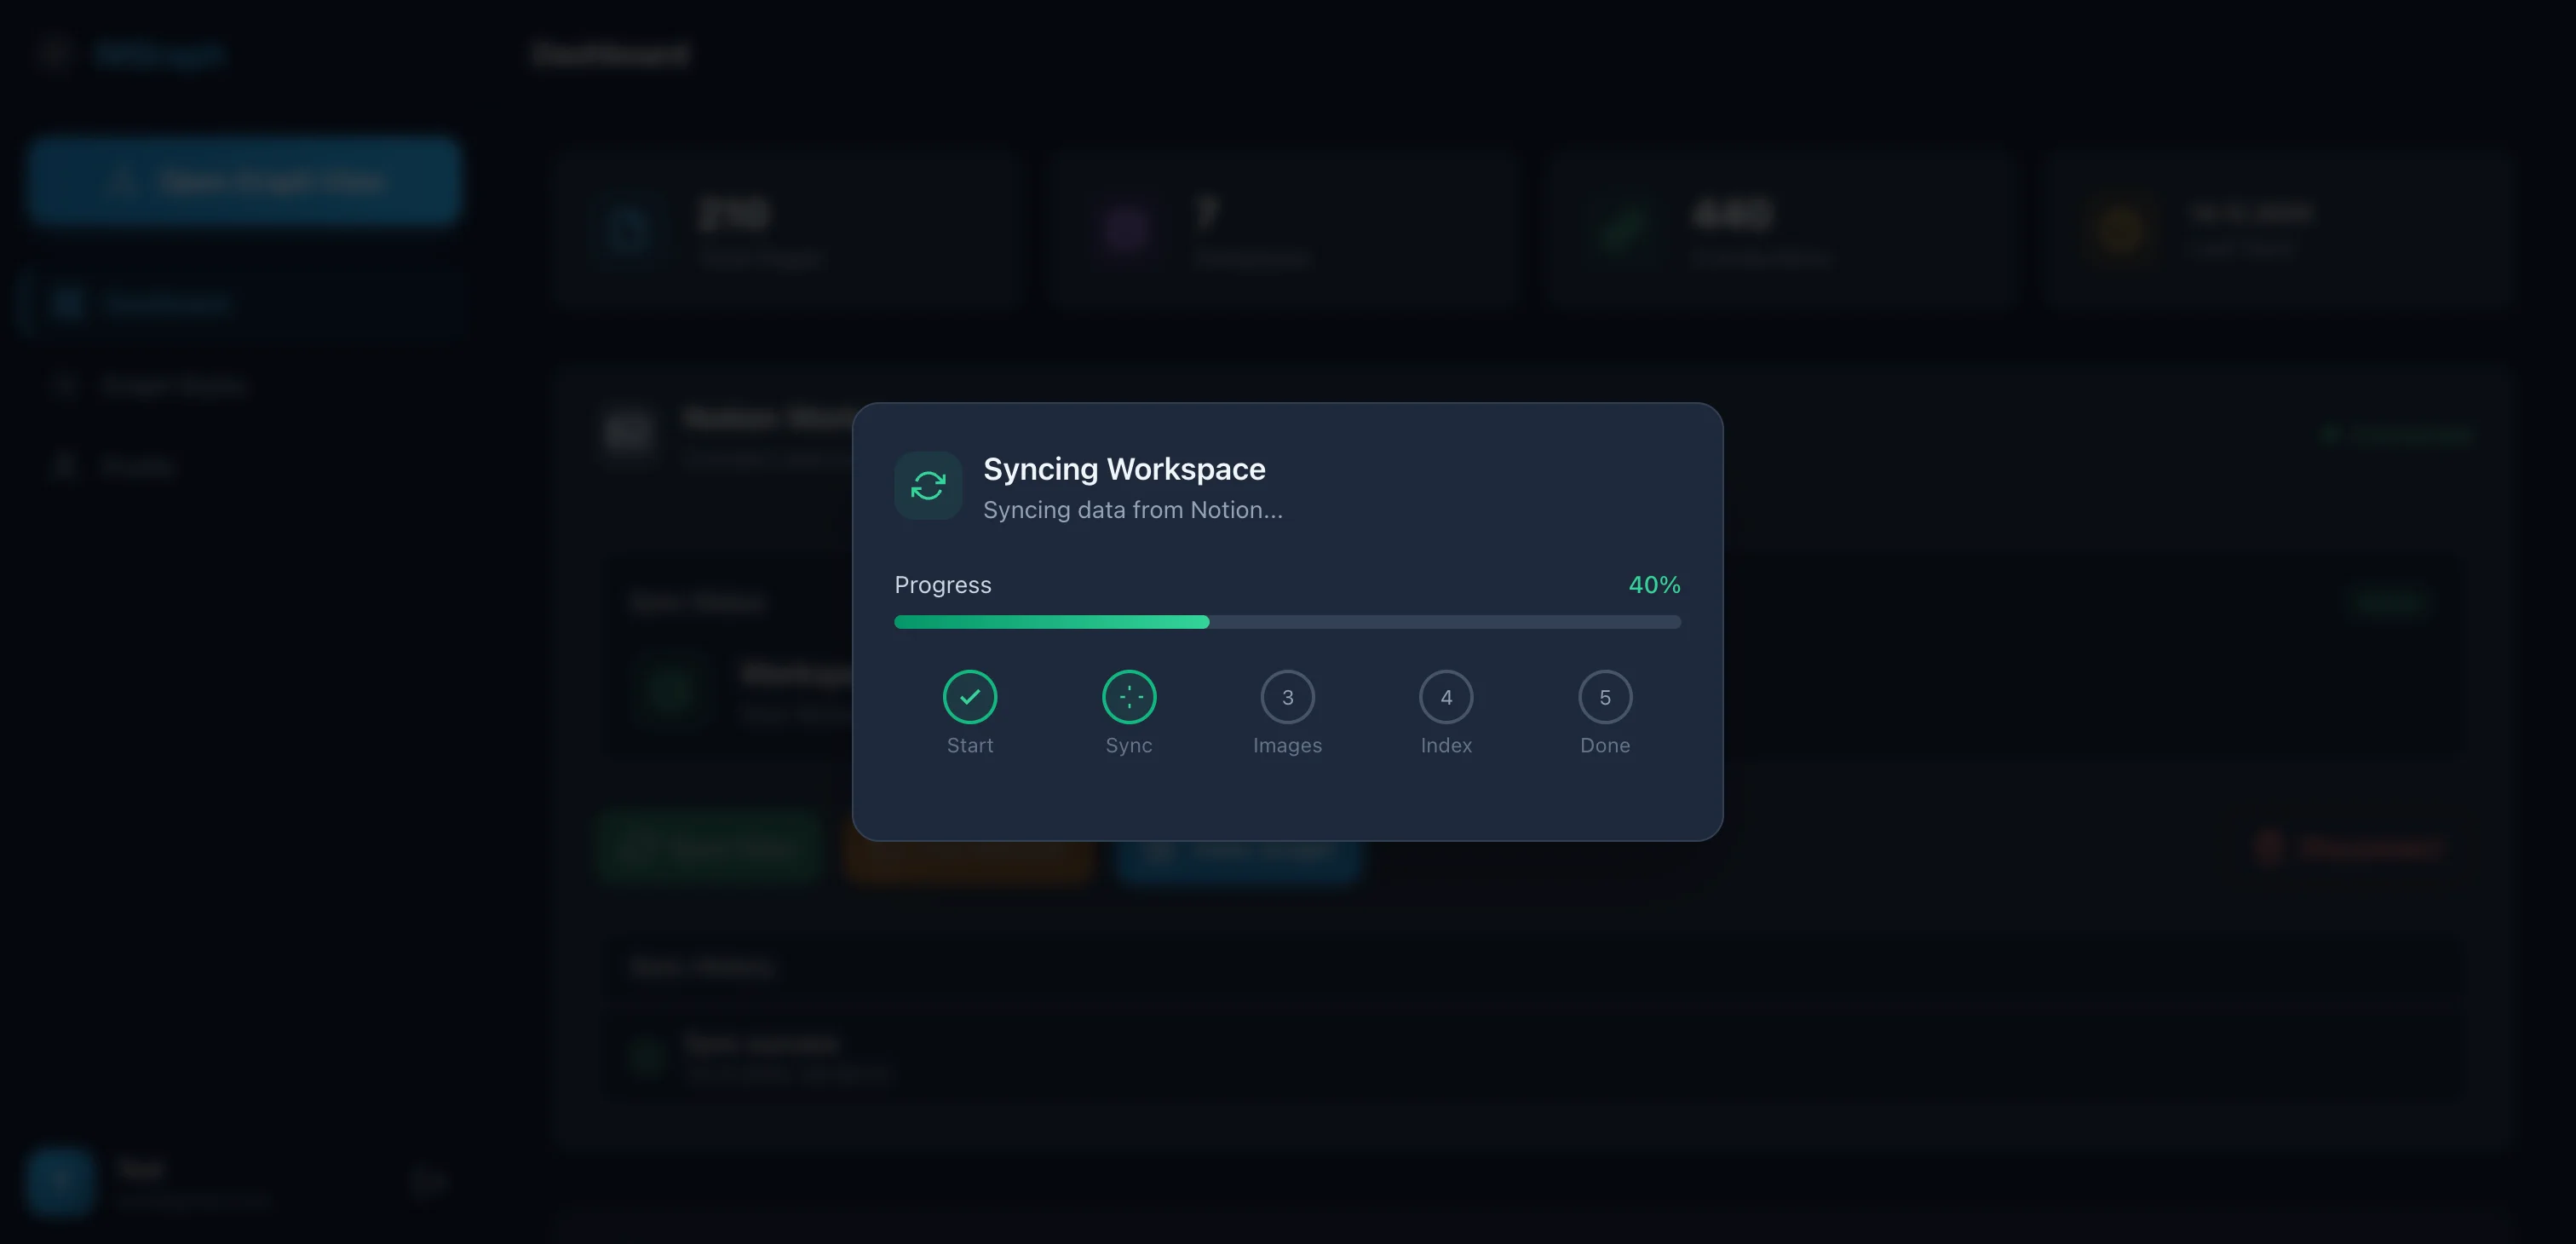
Encontre nós isolados — são notas esquecidas. Clique no maior nó — esse é o seu "centro" de conhecimento. A partir daí, experimente.
Comece pelo grafo, adicione o LLM e, em duas semanas, você vai perceber que está trabalhando com suas anotações de um jeito completamente diferente.
Use o Notion como fonte de dados brutos, o Claude Code como redator e o grafo como índice. Essa combinação — uma wiki baseada em LLM para o Notion com um grafo de conhecimento 3D sobreposto — é o que este artigo documentou do início ao fim. Essa mesma configuração também explica por que as pessoas buscam por "grafo de conhecimento Claude": o Claude raciocina sobre o grafo, que não é apenas um elemento decorativo.
Perguntas frequentes
O que é uma wiki de LLM?
Uma wiki de LLM é uma base de conhecimento que um LLM compila e mantém para você: em vez de reler documentos brutos a cada consulta, o modelo os processa previamente e os transforma em páginas de wiki estruturadas e interligadas, para então responder com base nessa camada. O termo vem de uma nota de Andrej Karpathy de abril de 2026 que descreve esse padrão; este artigo apresenta uma implementação prática dele usando o Notion como base. Para uma análise completa do conceito em si — arquitetura, comparação com RAG e formas de criar uma —, veja O que é uma wiki de LLM? Entenda o padrão de Karpathy.
Wiki com LLM vs. segundo cérebro — qual é a diferença?
Um segundo cérebro é a prática mais ampla de armazenar e organizar seu conhecimento fora da sua cabeça (método CODE de Tiago Forte). Uma wiki com LLM é o resultado da etapa de destilação quando ela é realizada por um LLM: o modelo escreve e mantém os resumos, os links cruzados e as linhas do tempo. Em resumo — toda wiki com LLM faz parte de um segundo cérebro, mas nem todo segundo cérebro tem um LLM escrevendo sua camada de wiki.
Posso criar uma wiki com LLM sem o Claude?
Sim. Qualquer modelo que consiga ler seu espaço de trabalho via MCP ou uma API e gravar páginas nele vai funcionar — essa abordagem independe do modelo. O Claude Code é o que melhor se encaixa na minha configuração porque roda no terminal, mantém o contexto entre sessões e se conecta ao Notion com um único comando MCP. Desenvolvedores também podem consultar a camada do grafo diretamente pela IVGraph LLM API.
Por onde começar?
Se o seu espaço de trabalho já está no Notion: primeiro, conecte o grafo (3 minutos, grátis até 500 nós) e depois adicione a conexão MCP ao seu LLM. Se você ainda está escolhendo uma ferramenta, comece por O Notion tem uma visualização em grafo? e pelo Guia definitivo do grafo de conhecimento no Notion.