 IVGraph
GraphRAGは、エンティティとその関係を表すナレッジグラフを使い、LLMのための文脈を見つける検索拡張生成です。回答が、互いにつながる事実や、情報の集まり全体に見られるパターンに依存する場合は、試す価値があります。ただし、適切な段落を見つけるだけでよい場合まで、常に試す価値があるとは限りません。ベクトルRAGは引き続き妥当な出発点であり、両者を組み合わせた設計を検討するほうが、より有用なことも多くあります。
端的に言えば、類似度で文章の一節を見つけ、グラフで事実をつなぎます
ベクトル検索で問うのは、この質問と意味が似ている文章はどれか?ということです。グラフ検索では、さらにこの質問が扱う事柄には何がつながっているか?という問いが加わります。
プロジェクトのワークスペースを思い浮かべてください。「サービスをデプロイするにはどうすればよいですか?」という問いには、1つの運用手順書で答えられるかもしれません。一方、「このインシデントに対応しているチームが管理するサービスに依存しているのは、どのローンチですか?」という問いに答えるには、インシデント、チーム、サービス、ローンチのつながりをたどる必要があります。
グラフRAGとベクトルRAGの実用上の違いは、そこにあります。「賢い検索か、愚かな検索か」という話ではありません。必要な根拠を集めるのに、どちらの構造が役立つかという選択です。
1段落でわかるRAGとベクトル検索の限界
検索拡張生成は、モデルが回答する前に関連情報を検索し、文脈情報としてLLMに渡す仕組みです。従来のベクトルRAGは、文書をチャンクに分割し、各チャンクを数値表現に変換したうえで、質問とのベクトル類似度に基づいて検索します。回答を生成するモデルは、選ばれたテキストをもとに回答します。Meilisearchの比較記事では、類似度に基づく検索と、つながりのあるエンティティをたどる検索という、根本的な違いを説明しています。
たとえば「当社の返金ポリシーではキャンセルについてどう定めていますか?」という質問なら、ポリシーの該当箇所を見つけるだけで十分な場合があります。そのワークフローを試すために、すべての顧客、ポリシー、製品をノードとしてモデル化する必要はありません。
必要なコンテキストが分散していると、こうした制約はさらに興味深いものになります。
- 複数のつながりをたどる質問:回答には、質問に合う一つの文章を見つけるのではなく、複数の関係をたどる必要があります。
- 全体に関する質問:「私たちのプロジェクトの振り返り全体で、繰り返し出てくるテーマは何ですか?」という質問は、最も関連性の高い情報だけでなく、情報の集合全体を対象にしています。
- 点在する事実:回答に必要な情報が別々のページに分かれており、その一部は元の質問と似ていない場合もあります。
インシデントの例では、ローンチページにそのインシデントへの言及がまったくない可能性があります。質問に似た表現の文章を取得することと、記録された依存関係をたどってそのローンチに行き着くことは、異なる操作です。
これは、ベクトル検索では答えが得られないという意味ではありません。最初の検索結果が関連していそうかどうかで判断するのではなく、必要な情報をすべて取得できているかを検証する必要があるということです。
Microsoft GraphRAGの仕組みをステップごとに解説
Microsoft GraphRAGは、グラフを基盤とするオープンソースのRAGシステムです。抽出、コミュニティ形成、要約という処理の流れは、この手法を理解するうえで参考になります。作業は、データ集合を準備する段階と、そのデータ集合に基づいて質問に回答する段階の2つに分けます。
インデックス化:テキストをつながりのある文脈に変換
- エンティティを抽出します。 LLMが元の資料で取り上げられている対象を特定します。仮にエンジニアリング関連の資料群であれば、サービス、チーム、プロジェクト、インシデントなどが対象として挙げられます。
- 関係を抽出します。 LLMがエンティティ間のつながりを特定します。たとえば、あるチームが特定のサービスを担当していると文書に記載されている場合があります。
- グラフを構築します。 エンティティがノードに、関係がリンクになり、資料の内容をつながりのある構造として表現することで、検索に利用できるようにします。
- エンティティをコミュニティにまとめます。 システムは各エンティティを個別に扱うのではなく、グラフをつながりのあるグループに整理します。
- コミュニティの要約を作成します。 生成された要約は、その後の検索や回答のために、各グループの概要を示します。
重要な変化は、システムが検索可能な文章だけでなく、それらの文章で扱われている事柄や、その事柄同士のつながり、つながりのあるグループに含まれるものを表す情報も用意する点です。
クエリ:局所的な問いと全体的な問い
ローカル検索は、エンティティを中心とした検索です。たとえば、「請求サービスには何がつながっている?」という問いを考えてみてください。関連するコンテキストは、特定のエンティティとその関係性を軸に整理されています。
グローバル検索はデータセット全体を対象にします。たとえば、「これらのプロジェクト全体で、どのような調整上の問題が繰り返し発生しているか?」という問いを考えてみてください。コミュニティの要約は、質問に近い内容の文章だけに頼るのではなく、より広範な情報を統合するための材料となります。
MicrosoftのGraphRAGドキュメントでは、インデックス作成、クエリ手法、プロンプト調整を分けて説明しています。最初の評価で役立つのは、シンプルな区別です。特定の対象を調べたいのか、それともコレクション全体を俯瞰したいのか、という点です。
「ローカル」を「自分のノートパソコン上で動作する」という意味と混同しないでください。ここでは検索範囲を指しています。また、グラフに対するすべてのクエリにコミュニティの要約が必要だとは考えないでください。明示的なページ間の関係をたどるのは、より範囲を絞ったグラフ検索のワークフローです。
グラフRAGとベクトルRAG:実用面での比較
以下のグラフ列には、Microsoftの抽出・要約アプローチが含まれています。既存のリンクをもとに構築されたワークフローでは、それらのリンクの抽出を省略できるため、セットアップは同一ではありません。
| 比較項目 | ベクトルRAG | グラフベースRAG |
|---|---|---|
| データモデル | テキストを分割したチャンクを埋め込みで表現します。 | エンティティやページを関係でつなぎます。Microsoft GraphRAGでは、コミュニティの要約も作成します。 |
| インデックス作成の作業とコスト | チャンクを準備し、埋め込みを生成します。 | グラフ構造を準備します。処理パイプラインでLLMによる抽出や要約の生成を行う場合は、その費用も予算に組み込みます。 |
| 最初に検証する質問 | 関連するテキストの一節、または少数の節から回答できる質問です。 | 相互につながる事実についての質問です。コミュニティの要約が利用できる場合は、データセット全体の情報を総合して答える質問も対象になります。 |
| 説明可能性 | 検索で取得したテキストの該当箇所とその出典を確認します。 | 検索で取得した出典と関係をたどる経路を確認します。経路が可視化されていても、それを裏付ける証拠は必要です。 |
| 情報の鮮度とメンテナンス | テキストの変更をチャンクと埋め込みにどう反映するか計画します。 | 変更が関係や生成済みの要約にどう影響するかも考慮して計画します。 |
| 代表的なツールや構成要素 | 埋め込みモデル、ベクトルインデックス、元データの保存先、回答用のLLMです。 | グラフ表現と検索ロジックです。Microsoft GraphRAGは、評価の候補となるオープンソースの実装です。 |
| 注意すべき失敗 | 関連性がありそうに見えても、必要な事実が抜けている検索結果です。 | 関係の欠落や誤解を招く関係、必要な詳細が抜けている要約です。 |
私が出発点とする原則:根拠が文章の一節に収まるなら、まず一節単位での検索を試します。根拠が連鎖をなしているなら、その連鎖を検索で取得する方法を試します。質問が文書群に関するものなら、文書群全体を対象とするアプローチを試します。
それぞれの使いどころと、併用する場面
文章形式の回答を得るには、まずベクトルRAGから始めましょう
想定される回答が特定可能なテキスト内にある場合、ポリシー、指示、説明は最初に試す対象として適しています。同じ情報群を別の形式で表現したものを導入する前に、比較の基準を確立しましょう。
失敗の原因が情報の検索にあったのか、回答の生成にあったのかを確認しましょう。正しい根拠がすでにあったのであれば、グラフを追加しても実際の問題は解決しないかもしれません。
関係性を捉えた回答を得るためにグラフ検索を試す
つながりをたどって答える必要のある質問を使ってください。たとえば、どのプロジェクトがあるサービスに依存しているか、どの意思決定がある要件に結びついているか、どのリサーチノートがある主張の裏付けになっているか、といった質問です。これらは評価に使うケースの提案であり、精度の向上を約束するものではありません。
データにそれらの関係が含まれているか確認してください。元のデータ構造からも抽出処理からも得られない有用なエッジを、グラフでたどることはできません。
すべてを置き換える前に、ハイブリッド型のワークフローを試しましょう
検証用の実用的な設計では、意味に基づくエントリーポイントとグラフの展開を組み合わせます。
- 質問に関連するテキストやノードを検索します。
- それらを起点に、選択したつながりをたどります。
- つながっている項目の元のコンテンツを取得します。
- 回答を生成するモデルに、根拠とその参照元を渡します。
インシデントの例では、検索でインシデントレポートを見つけられます。その後、グラフ探索によって、影響を受けたサービスや、そのサービスに依存するリリースへのリンクをたどれます。それらのページを読むことで、回答の根拠となる実際の情報が得られます。
テスト前に範囲を決めましょう。どの種類のつながりが有用か、どこまでたどるか、どれだけのコンテンツを返すか。「つながっているものをすべて含める」のは検索戦略ではなく、選別を避けているだけです。
GraphRAGの実際のコスト
対象となる文書群、使用するモデル、設定が決まっていなければ、根拠をもって一律の料金や固定のコスト倍率を示すことはできません。予算を考えるうえで役立つのは、このパイプラインによって、どのような作業が追加されるのか?という問いです。
Microsoftの抽出・要約アプローチでは、エンティティと関係性を抽出し、コミュニティの要約を生成するためのモデルによる処理も含めてください。これらは、基本的なチャンク分割・埋め込みパイプラインに加えて必要となる準備工程です。「オープンソース」であることを、こうした処理の実行費用を賄えることと混同しないでください。
試験導入では、費用を別途記録してください。
- 初期準備:設計上必要な箇所で行う埋め込み、抽出、要約の生成です。
- 質問への対応:検索処理、LLMへのコンテキストの提供、回答の生成です。
- 更新:ソースの編集内容を、維持管理しているデータ表現に反映するために必要な作業です。
- 運用:保存、デバッグ、誤った関係や欠落している関係の確認です。
更新についても、別途テストする必要があります。元の記述を編集し、選択した更新ワークフローを再実行して、生成された回答を確認してください。元のコンテンツ、グラフ上の表現、変更前の記述に基づくすべての要約を確認してください。初回のインデックス作成が一度成功しただけで、コレクションが最新の状態に保たれると判断しないでください。
エッジがすでに明示的なリンクとして存在していれば、それらのエッジをLLMで抽出する必要はありません。ただし、コンテンツの取得、回答の生成、メンテナンスが不要になるわけではありません。省けるのは特定の工程であり、グラフベースのRAGに伴うすべてのコストではありません。
あなたのノートには、すでにグラフ構造があります
リンクでつながったワークスペースは、互いにつながりのない文書をまとめたフォルダーとは異なる出発点になります。Notionには、データベース間のリレーション、ページへのメンションとバックリンク、ページの親子関係による明示的なエッジがすでに存在しています。Obsidianの保管庫にはウィキリンクがあります。これらのリンクは、LLMに見つけてもらわなくても、グラフのエッジとして利用できます。
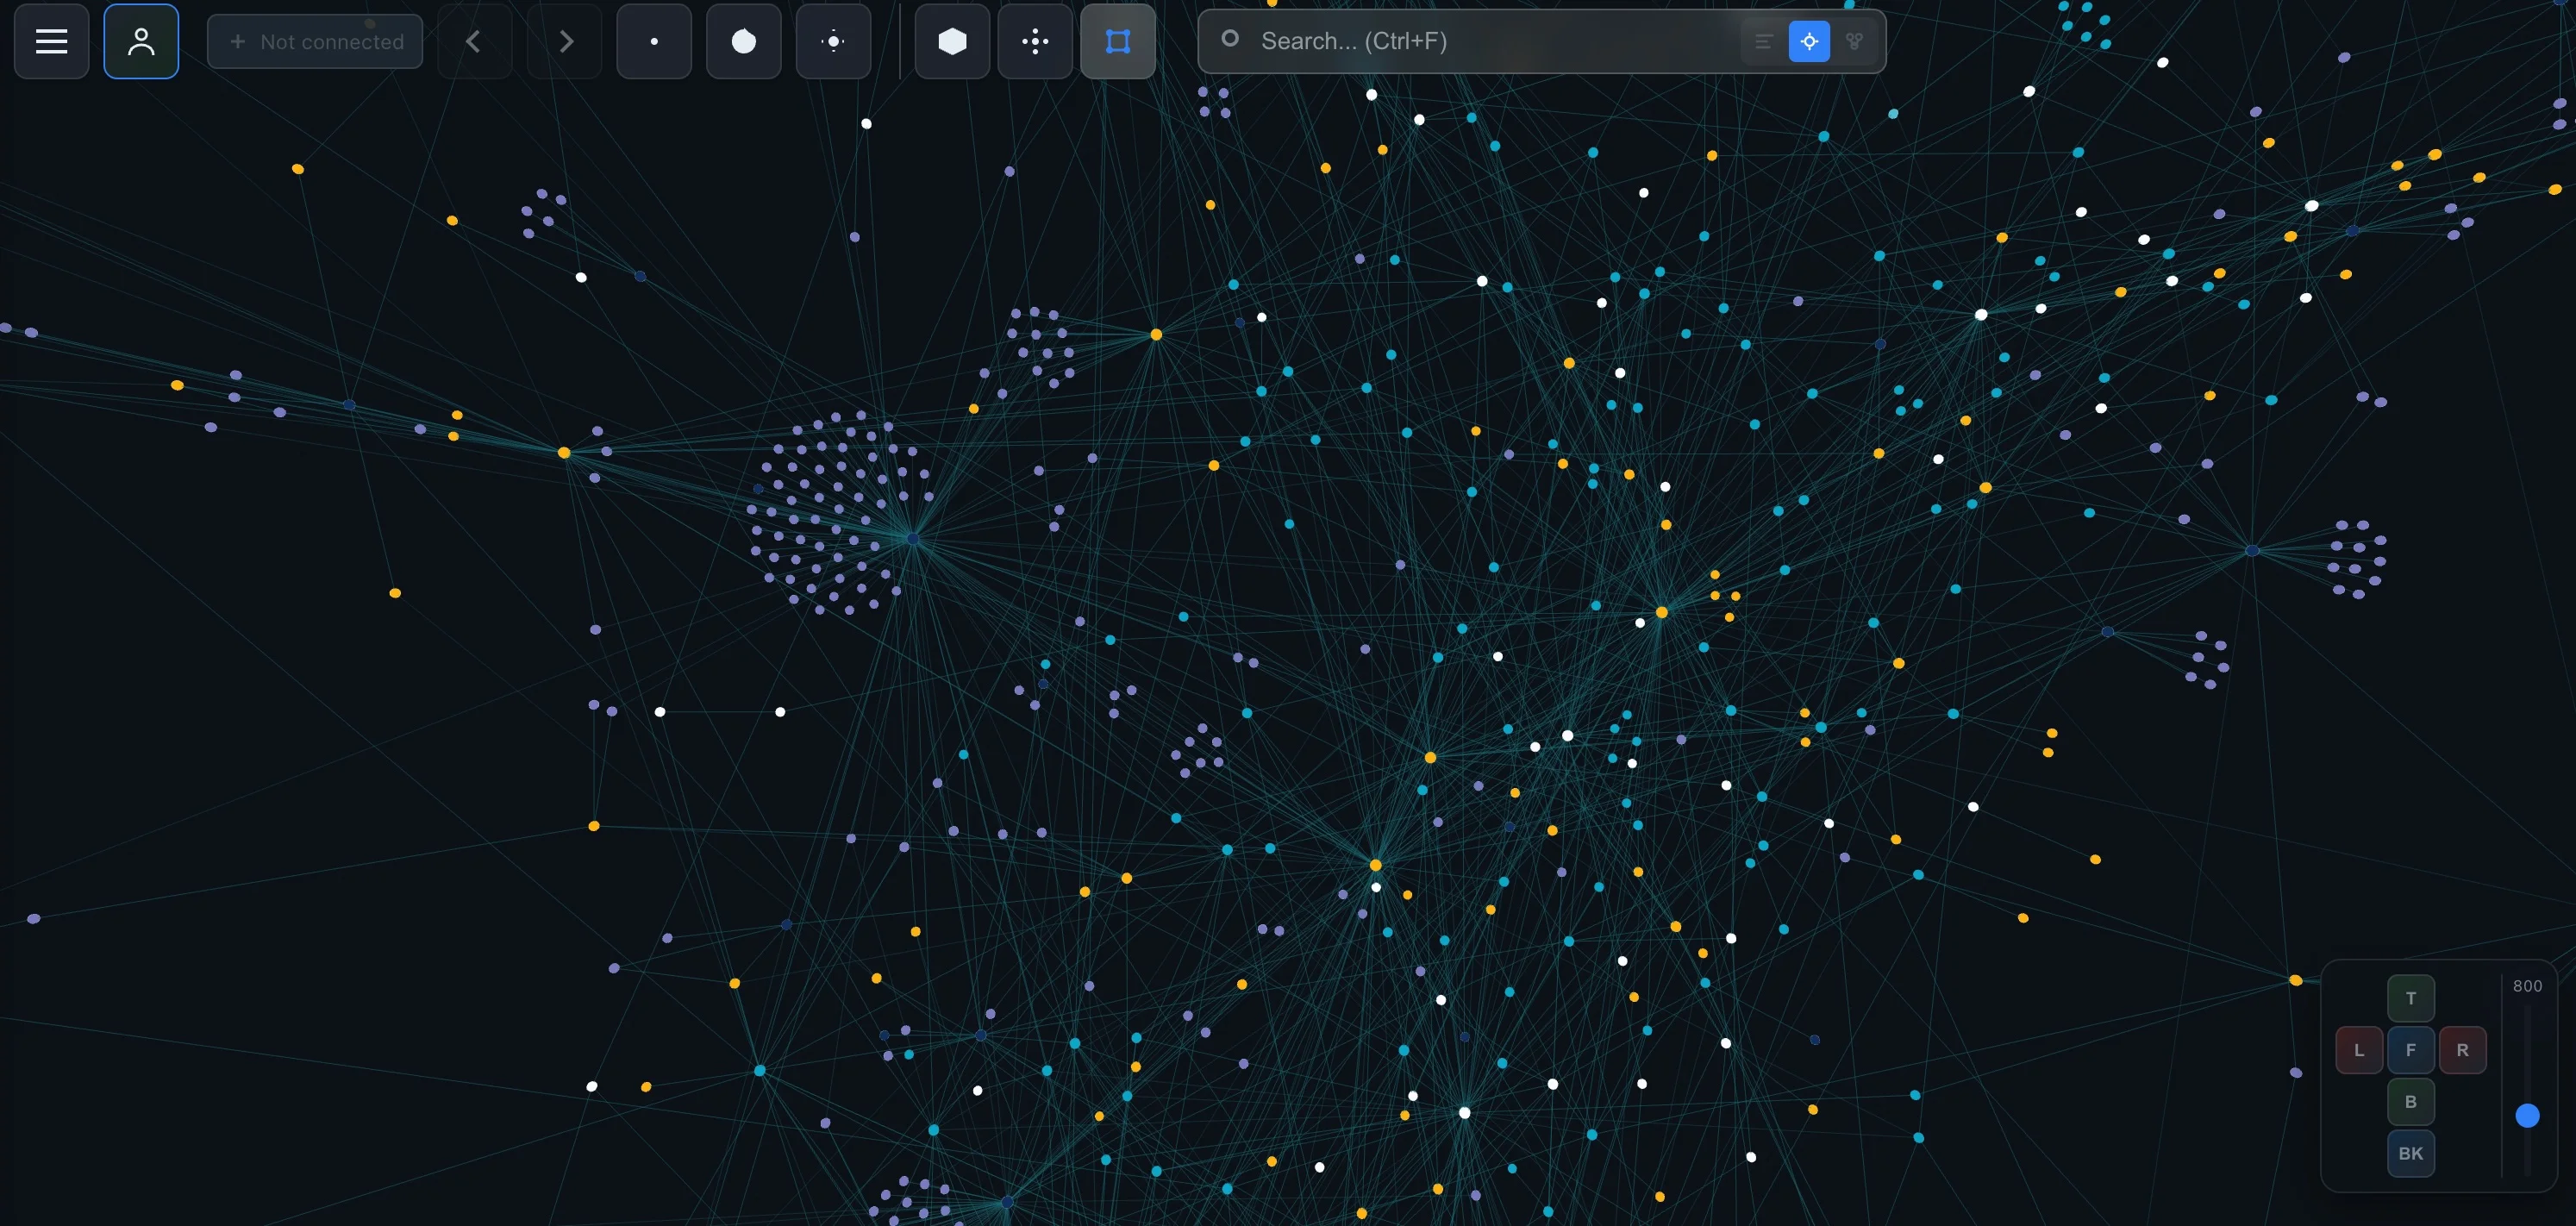
たとえば、プロジェクトのデータベースとサービスのデータベースがリレーションで結ばれ、インシデントのメモにはサービスのページへの言及があるとします。この時点で、インシデントのメモからサービスを経由して、関連するプロジェクトへとたどる道筋ができています。Notionのデータベース間のリレーションガイドでは明示的なリンクについて解説し、より広い視点を扱うNotionのナレッジグラフガイドでは、そうしたリンクを全体の中でどう捉えるかを説明しています。
ただし、率直に言うと、注意点が1つあります。ページのグラフが、そのままエンティティのナレッジグラフになるわけではありません。1つのページで複数のエンティティを扱うこともあります。メンションが示すのは、あるページが別のページを参照しているということであり、あるサービスが別のサービスに依存しているとは限りません。親子関係のリンクが表すのは階層構造であり、所有関係や因果関係ではありません。
情報を取得する際も、この区別を保ってください。メンションをたどって有用な根拠になりそうな情報を探し、その関係が何を意味するのかを断定する前に、ページを読んでください。
これは、LLMウィキにも自然につながる考え方です。情報源となるページ、ページ同士のリンク、生成された解釈を、それぞれ分けて考えます。これらの層を区別しておくと、生成されたつながりをすべて確かな事実として扱うのではなく、回答を検証しやすくなります。
エージェントが構造とコンテンツにアクセスできるようにする
IVGraphは、Notionのページ、バックリンク、メンション、データベース間のリレーションからグラフを構築します。読み取り専用のV1 LLM APIを通じて、エージェントは検索、ノードの詳細やページ内容の取得、グラフの走査を行えます。これらを組み合わせれば、すでに管理しているワークスペースを基盤に、グラフ構造を活用した情報検索のワークフローを構築できます。
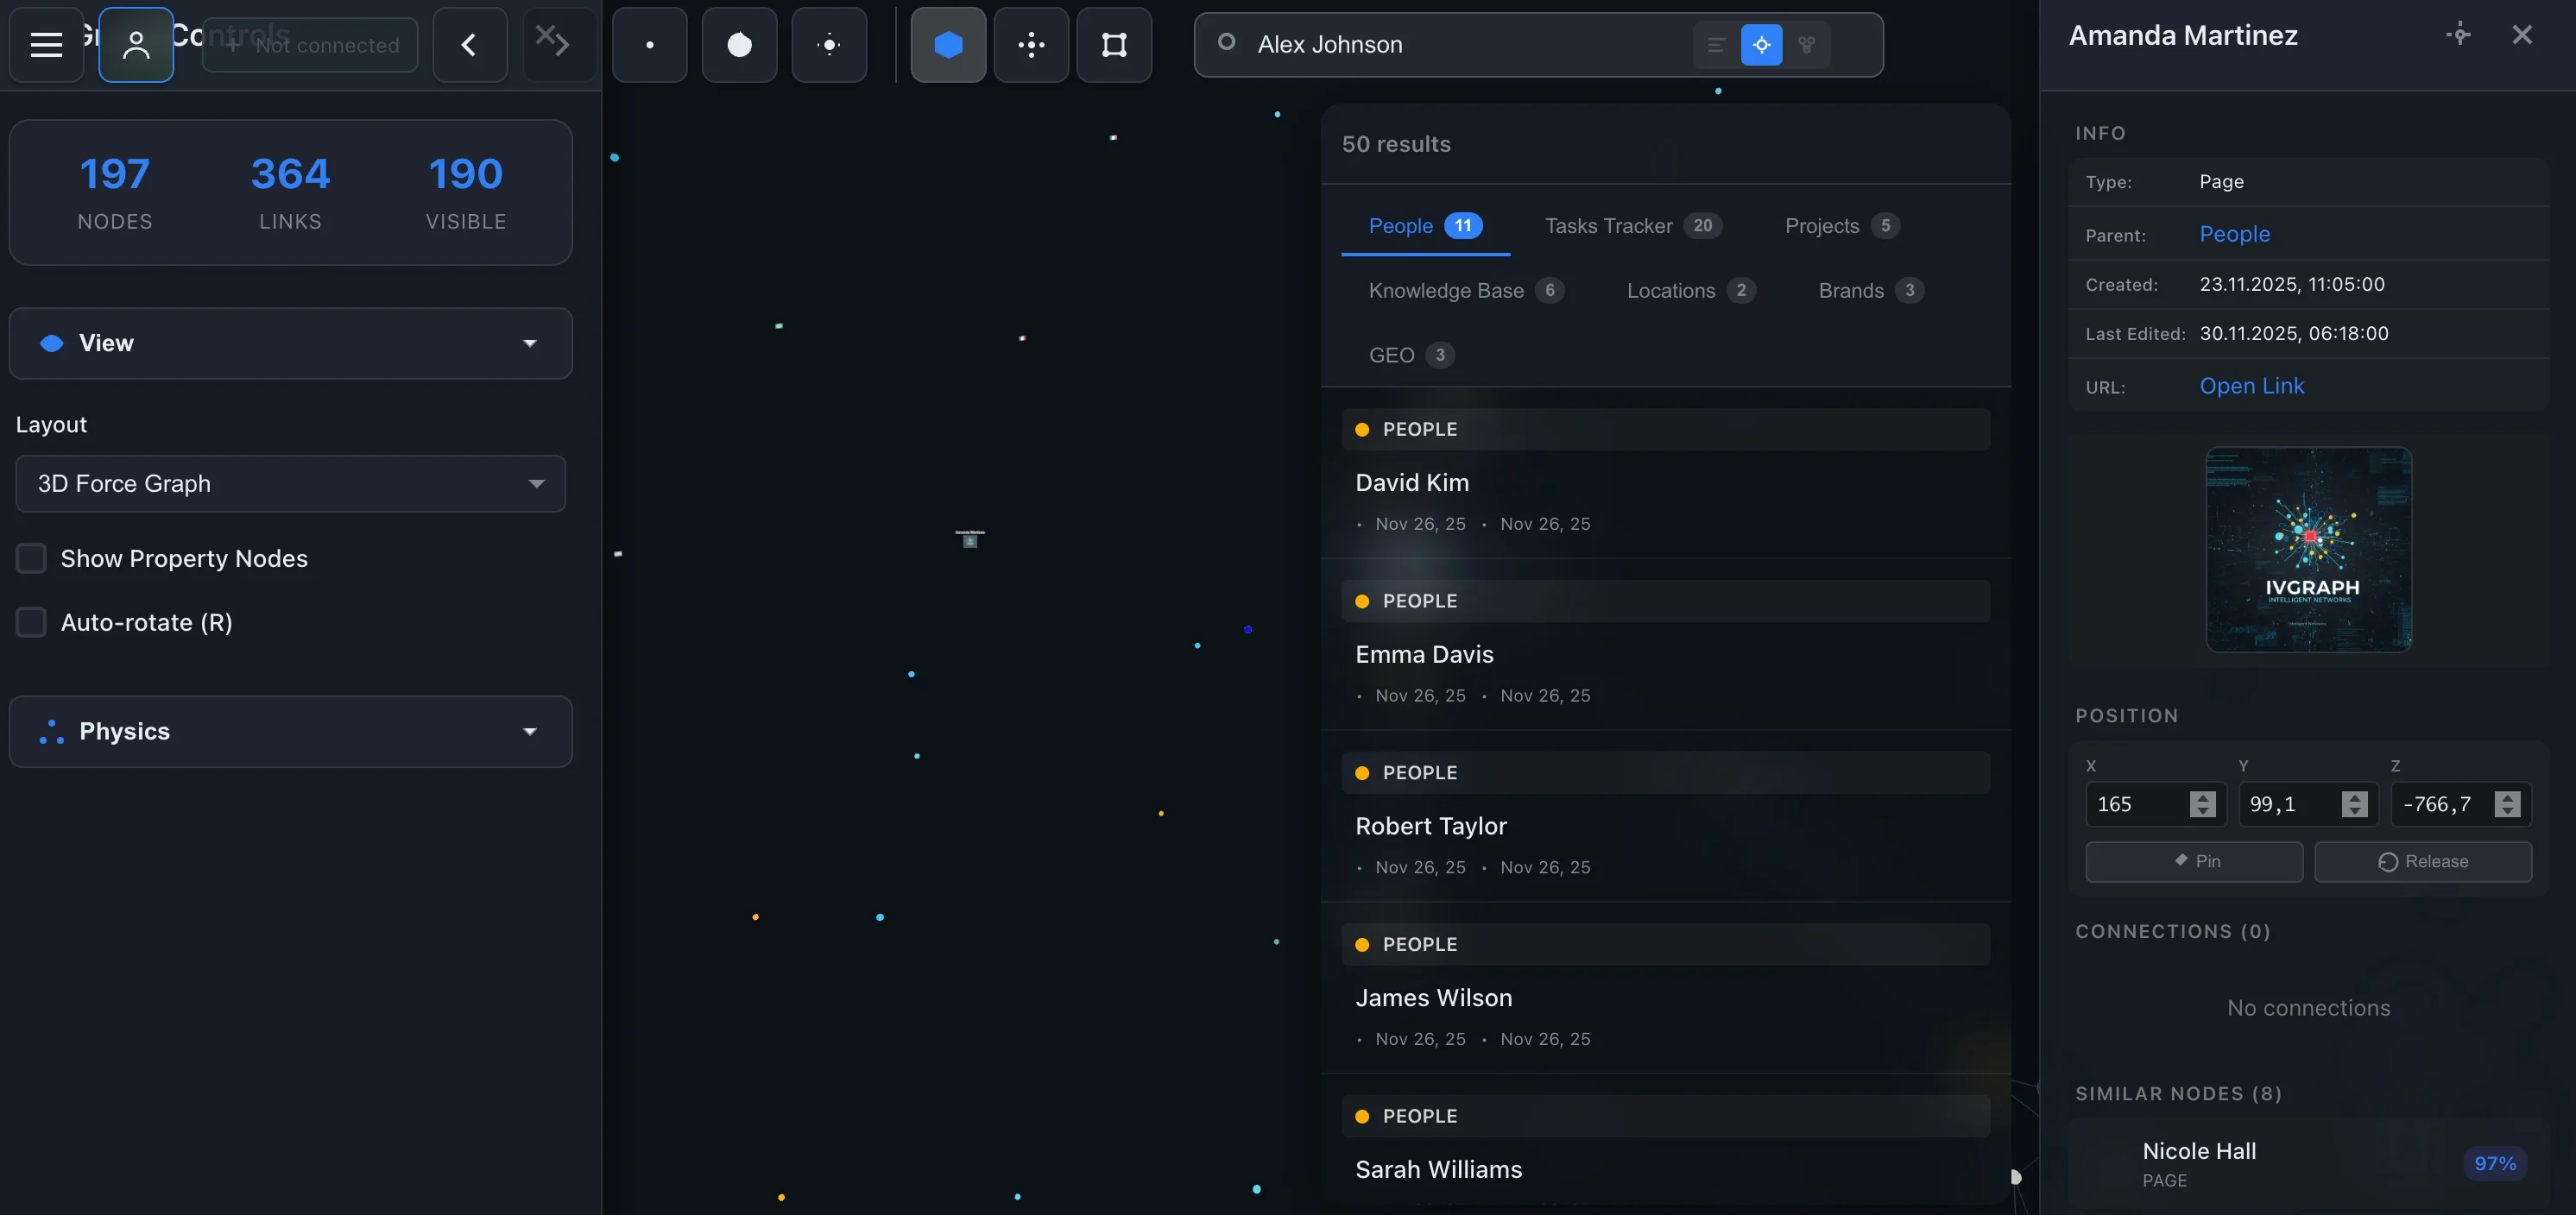
エージェントで試すワークフローはシンプルです。プロジェクトを検索し、そのノードを確認して関連するリンクをたどり、つながっているページの内容を取得して、その情報を根拠に回答します。より幅広い個人用のワークフローについては、LLM、Notion、Claude Codeでセカンドブレインを構築する方法をご覧ください。
すでに明示的に管理している関係性の抽出から始めないでください。まずは、そうした関係性を可視化することで、文脈の不足という問題を解決できるか試してください。
小さく始めるには
データベースの移行ではなく、問いから始めましょう。このチェックリストを使って、実際に情報を見つけられなかったケースに即して実験を進めましょう。
- 範囲を限定したコレクションを1つ選びます。 内容と関係性を自分で確認できるプロジェクト領域を選びます。
- 実際に使う質問を書き出します。 特定の情報を調べる質問、関連する事実を結び付ける質問、コレクション全体に関する質問が業務で重要なら、それらを含めます。
- 必要な根拠を特定します。 正しい回答が根拠として用いるべき記述と関係性を記録します。
- ベクトル検索を実行して比較の基準を作ります。 生成された回答だけでなく、検索で取得したコンテキストも保存します。アーキテクチャを変更する前に、不足している根拠を特定します。
- 既存のエッジを洗い出します。 有用な関係性を、付随的な言及や階層構造のリンクと区別します。
- 不足している機能だけを追加します。 関連する事実を結び付けるためのグラフ探索をテストするか、Microsoftの抽出・要約パイプラインを、そのパイプラインが対象としている質問でテストします。
- 比較して更新します。 必要な根拠をどこまで網羅できているか、根拠のない主張、コスト、応答時間を確認します。その後、情報源を編集し、最新の情報が反映されるかを確認します。
グラフ層が、ベースラインでは取得できない必要な文脈を、負担できるコストで取得できるなら、そのグラフ層を維持してください。どちらのアプローチでも同程度に適切な回答が得られるなら、より保守しやすい方を選んでください。
よくある質問
GraphRAGとは、簡単に言うと何ですか?
GraphRAGは、エンティティとその関係を表すナレッジグラフを使って、LLMに必要な文脈を探す検索拡張生成です。似た文章を探すだけでなく、物事のつながりをたどって情報を取得できます。
GraphRAGはベクトルRAGより優れていますか?
すべての質問で優れているわけではありません。関連する箇所を見つけるには、ベクトルRAGから始めるのが妥当です。回答に互いに関連する事実が必要な場合は、グラフ検索を試す価値があります。一方、Microsoftのコミュニティ要約を用いた手法は、データセット全体に関する質問にも対応しています。ご自身の質問と情報源を使って比較してみてください。
Microsoft GraphRAGは、グラフベースのRAG全般と同じものですか?
いいえ。Microsoft GraphRAGは、エンティティと関係を抽出し、それらをコミュニティにグループ化して要約を生成し、ローカル検索とグローバル検索を提供するオープンソースの実装です。グラフベースの検索では、抽出から要約までの一連の処理をすべて行わずに、既存の関係を利用することもできます。
GraphRAGの費用はどのくらいですか?
対象の文書群、使用するモデル、パイプラインの構成が決まらなければ、参考になる一律の費用は示せません。抽出と要約生成を利用する場合はその費用に加え、検索と回答生成、ストレージ、更新の費用も予算に含めてください。ベクトルRAGの費用に一定の倍率を掛けて見積もるのではなく、全体を代表する小規模なサンプルで実測してください。
NotionのリンクはGraphRAGに使えますか?
はい。データベース間のリレーション、メンションとバックリンク、ページの親子関係を使えば、LLMによる抽出なしで明示的なグラフのエッジを得られます。ただし、関連するページを選び、その内容を読み取り、回答を生成するモデルに根拠を渡す検索ワークフローは必要です。ページのリンクだけでは、関係性を説明できません。