 IVGraph
GraphRAG ist Retrieval-Augmented Generation, die einen Wissensgraphen aus Entitäten und Beziehungen nutzt, um Kontext für ein LLM zu finden. Ein Test lohnt sich, wenn eine Antwort von verknüpften Fakten oder Mustern innerhalb einer Sammlung abhängt – nicht automatisch, wenn du nur den passenden Absatz brauchst. Vektor-RAG bleibt ein sinnvoller Ausgangspunkt, und oft ist es nützlicher, einen Ansatz zu erkunden, der beide kombiniert.
Die kurze Antwort: Ähnlichkeit findet Textstellen; Graphen verknüpfen Fakten
Die Vektorsuche fragt: Welche Textpassagen sind dieser Frage inhaltlich ähnlich? Die Graphsuche stellt eine weitere Frage: Was ist mit den Dingen verknüpft, um die es in dieser Frage geht?
Stell dir einen Projekt-Workspace vor. „Wie stellen wir den Dienst bereit?“ lässt sich vielleicht mit einem einzigen Runbook beantworten. Um die Frage „Welcher Launch hängt von dem Dienst ab, für den das Team verantwortlich ist, das diesen Vorfall bearbeitet?“ zu beantworten, musst du den Verbindungen zwischen einem Vorfall, einem Team, einem Dienst und einem Launch folgen.
Das ist der praktische Unterschied zwischen Graph-RAG und Vektor-RAG. Es geht nicht um „intelligente Suche versus dumme Suche“, sondern um die Wahl der Struktur, die dir hilft, die nötigen Belege zusammenzutragen.
RAG in einem Absatz – und wo die Vektorsuche an ihre Grenzen stößt
Retrieval-Augmented Generation ruft relevante Informationen ab und stellt sie einem LLM als Kontext bereit, bevor das Modell antwortet. Klassisches Vektor-RAG teilt Dokumente in Textabschnitte auf, wandelt diese in numerische Vektorrepräsentationen um und ruft sie anhand ihrer Vektorähnlichkeit zur Frage ab. Das antwortende Modell arbeitet dann mit dem ausgewählten Text. Der Vergleich von Meilisearch beschreibt den grundlegenden Unterschied: ähnlichkeitsbasierter Abruf im Gegensatz zum Abruf über miteinander verbundene Entitäten.
Bei einer Frage wie „Was steht in unserer Rückerstattungsrichtlinie zu Stornierungen?“ reicht es möglicherweise aus, die relevante Stelle in der Richtlinie zu finden. Du musst nicht jeden Kunden, jede Richtlinie und jedes Produkt als Knoten modellieren, um diesen Workflow zu testen.
Interessanter werden die Einschränkungen, wenn der benötigte Kontext verteilt ist:
- Fragen über mehrere Verknüpfungen hinweg: Um die Frage zu beantworten, musst du mehreren Beziehungen folgen, statt nur eine passende Textstelle zu finden.
- Übergreifende Fragen: „Welche Themen tauchen in unseren Projektretrospektiven immer wieder auf?“ bezieht sich auf die gesamte Sammlung, nicht nur auf die ähnlichsten Treffer.
- Verstreute Fakten: Verschiedene Seiten enthalten unterschiedliche Teile der Antwort, und manche davon ähneln der ursprünglichen Frage möglicherweise nicht.
Im Beispiel mit dem Vorfall wird dieser auf einer Seite zum Launch möglicherweise gar nicht erwähnt. Textpassagen abzurufen, die ähnlich klingen wie die Frage, ist nicht derselbe Vorgang wie einer dokumentierten Abhängigkeit zu diesem Launch zu folgen.
Das heißt nicht, dass die Vektorsuche die Antwort nicht liefern kann. Es heißt, dass du prüfen solltest, ob sie alle nötigen Informationen findet, statt sie danach zu beurteilen, ob der erste Treffer relevant erscheint.
So funktioniert Microsoft GraphRAG – Schritt für Schritt
Microsoft GraphRAG ist ein quelloffenes, graphbasiertes RAG-System. Seine Pipeline für Extraktion, Gruppenbildung und Zusammenfassung dient als hilfreiche Referenz für das Verständnis des Ansatzes. Teile die Arbeit in zwei Phasen auf: die Sammlung vorbereiten und Fragen auf ihrer Grundlage beantworten.
Indexierung: Text in vernetzten Kontext verwandeln
- Entitäten extrahieren. Ein LLM identifiziert die Dinge, die im Ausgangsmaterial behandelt werden. In einer hypothetischen Sammlung aus dem Ingenieurwesen könnten das etwa Dienste, Teams, Projekte und Vorfälle sein.
- Beziehungen extrahieren. Das LLM identifiziert Verbindungen zwischen diesen Entitäten. Ein Dokument könnte zum Beispiel besagen, dass ein bestimmtes Team für einen Dienst verantwortlich ist.
- Den Graphen aufbauen. Entitäten werden zu Knoten und Beziehungen zu Verbindungen. So entsteht eine vernetzte Darstellung des Materials für den Informationsabruf.
- Entitäten zu Gruppen zusammenfassen. Das System organisiert den Graphen in zusammenhängenden Gruppen, statt jede Entität isoliert zu betrachten.
- Zusammenfassungen der Gruppen erstellen. Generierte Zusammenfassungen geben einen Überblick über diese Gruppen für den anschließenden Informationsabruf und die Beantwortung von Fragen.
Die wichtige Änderung besteht darin, dass das System mehr als nur durchsuchbare Textpassagen aufbereitet. Es bildet auch ab, worum es in den Passagen geht, wie die darin behandelten Dinge miteinander zusammenhängen und was die miteinander verbundenen Gruppen enthalten.
Abfragen: lokale Fragen im Vergleich zu globalen Fragen
Die lokale Suche stellt eine Entität in den Mittelpunkt. Zum Beispiel: „Was ist mit dem Abrechnungsdienst verbunden?“ Der relevante Kontext ist um eine bestimmte Entität und ihre Beziehungen herum strukturiert.
Die globale Suche bezieht den gesamten Datensatz ein. Zum Beispiel: „Welche wiederkehrenden Abstimmungsprobleme zeigen sich über diese Projekte hinweg?“ Zusammenfassungen von Communities liefern Material für eine umfassendere Synthese, statt sich nur auf Textpassagen zu stützen, die der Frage ähneln.
Microsofts GraphRAG-Dokumentation behandelt Indexierung, Abfragemethoden und Prompt-Optimierung getrennt. Für eine erste Bewertung hilft eine einfache Unterscheidung: Untersuchst du etwas Bestimmtes oder suchst du einen Überblick über die gesamte Sammlung?
Verwechsle „lokal“ nicht mit „läuft auf meinem Laptop“. Hier beschreibt es den Suchbereich. Geh auch nicht davon aus, dass jede Graph-Abfrage Community-Zusammenfassungen benötigt: Das Nachverfolgen expliziter Beziehungen zwischen Seiten ist ein enger gefasster Workflow für den Informationsabruf aus einem Graphen.
Graph-RAG vs. Vektor-RAG: Vergleich für die Praxis
Die Graph-Spalte unten berücksichtigt Microsofts Ansatz zur Extraktion und Zusammenfassung. Ein Workflow, der auf bestehenden Links aufbaut, kann deren Extraktion überspringen. Die Einrichtung ist daher nicht identisch.
| Dimension | Vektor-RAG | Graphbasiertes RAG |
|---|---|---|
| Datenmodell | Textabschnitte, die durch Embeddings repräsentiert werden. | Entitäten oder Seiten, die durch Beziehungen verbunden sind; Microsoft GraphRAG erstellt außerdem Zusammenfassungen von Communities. |
| Aufwand und Kosten der Indexierung | Textabschnitte vorbereiten und Embeddings erzeugen. | Graphstruktur vorbereiten; Kosten für die Extraktion per LLM und für Zusammenfassungen einplanen, sofern die Pipeline diese nutzt. |
| Fragen für erste Tests | Fragen, die sich anhand einer relevanten Textpassage oder weniger Textpassagen beantworten lassen. | Fragen zu miteinander verknüpften Fakten; Synthese auf Grundlage des gesamten Datensatzes, wenn Zusammenfassungen von Communities verfügbar sind. |
| Nachvollziehbarkeit | Abgerufene Textpassagen und ihre Quellen prüfen. | Abgerufene Quellen und Beziehungspfade prüfen; auch ein sichtbarer Pfad muss durch Belege gestützt werden. |
| Aktualität und Pflege | Planen, wie Textänderungen in Textabschnitten und Embeddings berücksichtigt werden. | Zusätzlich planen, wie sich Änderungen auf Beziehungen und etwaige generierte Zusammenfassungen auswirken. |
| Typische Tools oder Komponenten | Ein Embedding-Modell, ein Vektorindex, ein Quellenspeicher und ein LLM zur Beantwortung von Fragen. | Eine Graphrepräsentation und eine Abruflogik; Microsoft GraphRAG ist eine Open-Source-Implementierung, die du evaluieren kannst. |
| Fehler, auf die du achten solltest | Ergebnisse, die relevant wirken, aber eine notwendige Information auslassen. | Fehlende oder irreführende Beziehungen oder Zusammenfassungen, die notwendige Details auslassen. |
Meine Grundregel: Wenn die Belege in einen Textabschnitt passen, teste zuerst den Abruf von Textabschnitten. Wenn die Belege eine Kette bilden, teste den Abruf dieser Kette. Wenn sich die Frage auf die Sammlung bezieht, teste einen Ansatz auf Sammlungsebene.
Wann du welches Tool nutzt – und wann du sie kombinierst
Starte mit Vektor-RAG für Antworten in Form von Textpassagen
Richtlinien, Anweisungen und Erklärungen eignen sich als erste Anwendungsfälle, wenn sich die erwartete Antwort in identifizierbaren Textstellen findet. Schaffe eine Vergleichsbasis, bevor du eine weitere Darstellung derselben Sammlung einführst.
Frag dich, ob ein Fehler beim Abrufen der Informationen oder beim Beantworten entstanden ist. Wenn die richtigen Belege bereits vorlagen, löst ein zusätzlicher Graph möglicherweise nicht das eigentliche Problem.
Teste die graphbasierte Suche für Antworten, die Beziehungen abbilden
Nutze Fragen, bei denen es wirklich auf Verbindungen ankommt: Welche Projekte hängen von einem Dienst ab, welche Entscheidungen sind mit einer Anforderung verknüpft oder welche Forschungsnotizen stützen ein Argument? Das sind vorgeschlagene Testfälle für die Evaluierung, keine Versprechen höherer Genauigkeit.
Prüfe, ob deine Daten diese Beziehungen enthalten. Ein Graph kann einer nützlichen Kante nicht folgen, wenn sie weder in deiner Quellstruktur vorhanden ist noch durch deinen Extraktionsprozess bereitgestellt wird.
Probiere einen hybriden Workflow aus, bevor du alles ersetzt
Ein praxisnahes Konzept, das sich zum Testen anbietet, kombiniert semantische Einstiegspunkte mit der Erweiterung des Graphen:
- Suche nach Text oder Knoten, die für die Frage relevant sind.
- Folge von diesen Ausgangspunkten aus ausgewählten Beziehungen.
- Rufe die Quellinhalte der verbundenen Elemente ab.
- Gib dem Modell, das die Antwort erstellt, die Belege und die zugehörigen Quellenverweise.
Im Beispiel mit dem Vorfall könnte die Suche den Vorfallsbericht finden. Anschließend könnte man im Graphen den Verknüpfungen zum betroffenen Dienst und zur davon abhängigen Einführung folgen. Das Lesen dieser Seiten liefert die konkreten Belege für die Antwort.
Lege vor dem Testen Grenzen fest: Welche Beziehungstypen sind nützlich, wie weit sollen Verknüpfungen verfolgt werden und wie viel Inhalt soll zurückgegeben werden? „Alles einbeziehen, was verknüpft ist“ ist keine Strategie zum Abrufen von Informationen; damit wird vermieden, eine Auswahl zu treffen.
Was GraphRAG in der Praxis kostet
Ohne einen Korpus, eine Modellauswahl und eine Konfiguration lässt sich weder ein allgemeingültiger Preis noch ein fester Kostenmultiplikator fundiert angeben. Die hilfreiche Frage für die Budgetplanung lautet: Welche zusätzlichen Arbeiten fallen durch diese Pipeline an?
Bei Microsofts Ansatz zur Extraktion und Zusammenfassung musst du auch den Modellaufwand für die Extraktion von Entitäten und Beziehungen sowie die Erstellung von Community-Zusammenfassungen einrechnen. Das sind zusätzliche Vorbereitungsschritte, die über eine einfache Pipeline zum Aufteilen in Chunks und Erstellen von Embeddings hinausgehen. Betrachte „Open Source“ nicht als Budget für die Durchführung dieser Arbeit.
Erfasse die Kosten für ein Pilotprojekt separat:
- Anfängliche Vorbereitung: Erstellung von Embeddings, Extraktion und Erstellung von Zusammenfassungen, wo immer dein Konzept diese vorsieht.
- Fragen: Aufwand für den Informationsabruf, Bereitstellung von Kontext für das LLM und Generierung von Antworten.
- Aktualisierungen: nötiger Aufwand, um Änderungen an den Quellen in den von dir gepflegten Repräsentationen abzubilden.
- Betrieb: Speicherung, Fehlersuche und Prüfung falscher oder fehlender Beziehungen.
Aktualisierungen sollten gesondert getestet werden. Bearbeite eine Aussage in der Quelle, führe den von dir gewählten Aktualisierungsworkflow erneut aus und prüfe die daraus entstandene Antwort. Prüfe den ursprünglichen Inhalt, die Darstellung im Graphen und alle Zusammenfassungen, die auf der alten Aussage basierten. Gehe nicht davon aus, dass eine erfolgreiche Erstindexierung beweist, dass die Sammlung aktuell bleibt.
Wenn deine Kanten bereits als explizite Links vorliegen, kannst du für diese Kanten auf die Extraktion per LLM verzichten. Inhalte müssen trotzdem abgerufen, Antworten generiert und das System gewartet werden. Es entfällt ein bestimmter Schritt – nicht sämtliche Kosten, die mit graphbasiertem RAG verbunden sind.
Deine Notizen enthalten bereits eine Graphstruktur
Ein vernetzter Workspace bietet einen anderen Ausgangspunkt als ein Ordner mit unverbundenen Dokumenten. Notion enthält bereits explizite Kanten durch Relationen zwischen Datenbanken, Seitenerwähnungen und Backlinks sowie Beziehungen zwischen über- und untergeordneten Seiten. Obsidian-Vaults haben Wikilinks. Diese Verknüpfungen können zu Kanten im Graphen werden, ohne ein LLM damit zu beauftragen, sie zu entdecken.
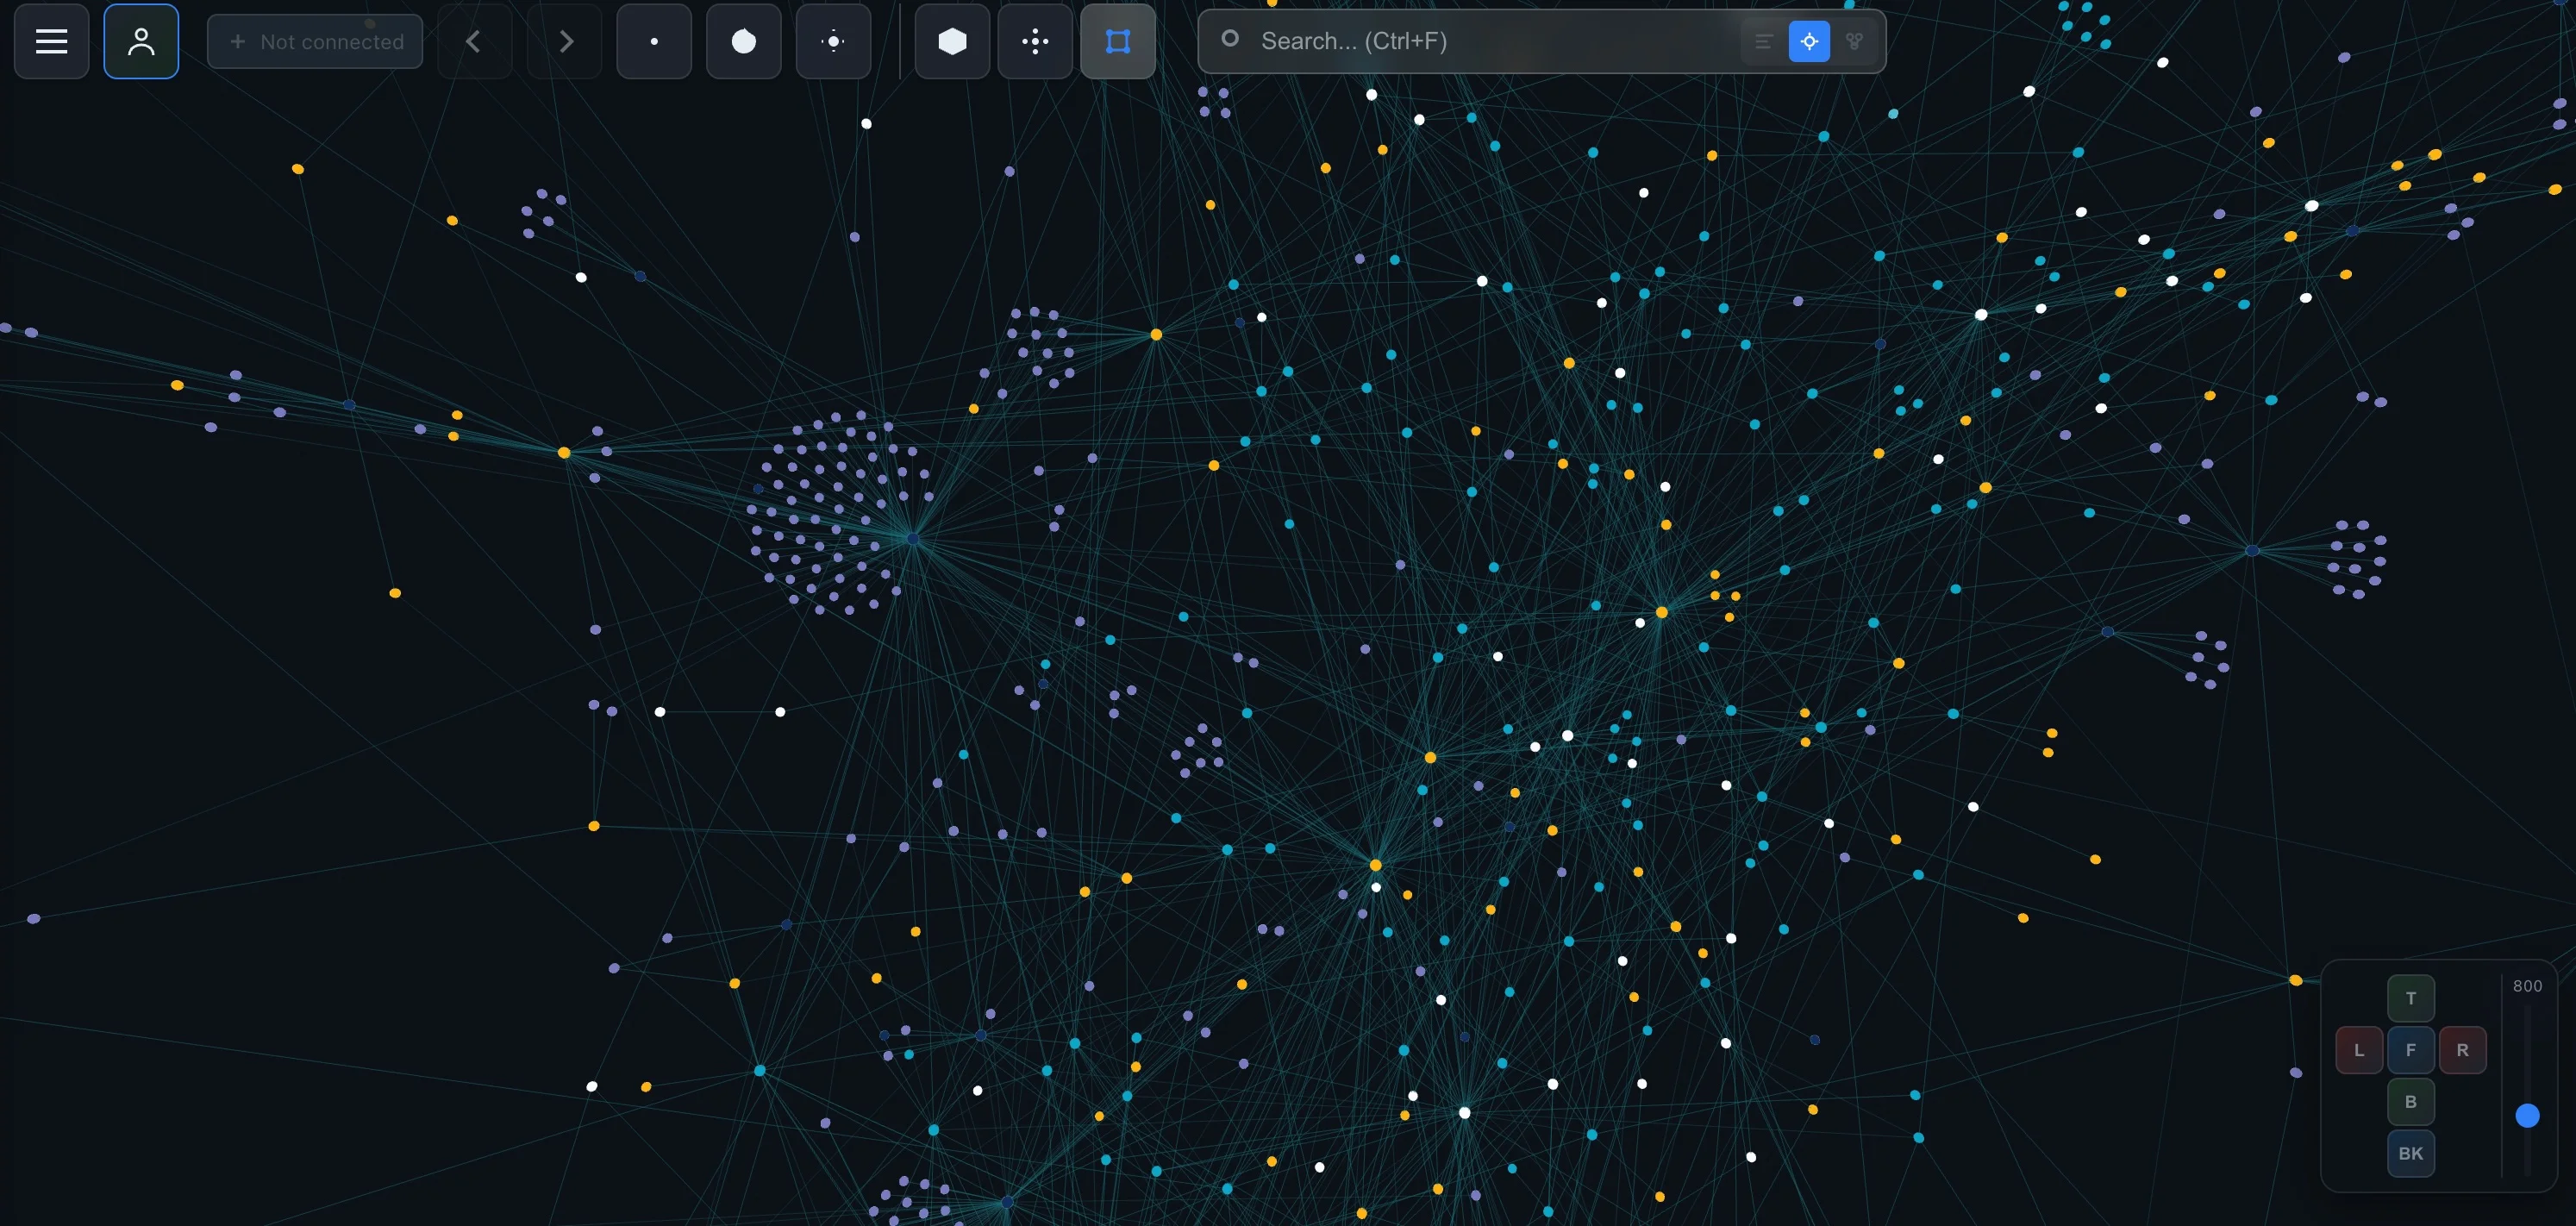
Angenommen, deine hypothetische Datenbank „Projekte“ ist über eine Relation mit einer Datenbank „Dienste“ verknüpft, während Notizen zu Vorfällen Seiten zu Diensten erwähnen. Damit hast du bereits einen Weg von einer Notiz zu einem Vorfall über einen Dienst zu den zugehörigen Projekten. Unser Leitfaden zu Relationen zwischen Notion-Datenbanken behandelt die expliziten Verknüpfungen; der umfassendere Leitfaden zum Notion-Wissensgraphen ordnet diese Verknüpfungen in den größeren Zusammenhang ein.
Ein ehrlicher Hinweis: Ein Seitengraph ist nicht automatisch ein Wissensgraph für Entitäten. Eine Seite kann mehrere Entitäten behandeln. Eine Erwähnung zeigt dir, dass eine Seite auf eine andere verweist – nicht unbedingt, dass ein Dienst von einem anderen abhängt. Eine Eltern-Kind-Verknüpfung drückt eine Hierarchie aus, keine Eigentumsverhältnisse oder Ursache-Wirkungs-Beziehung.
Behalte diese Unterscheidung beim Abrufen von Informationen bei. Folge einer Erwähnung, um potenziell hilfreiche Belege zu finden, und lies dann die Seite, bevor du eine Aussage darüber triffst, was die Beziehung bedeutet.
Das passt gut zu einem LLM-Wiki: Betrachte die Quellseiten, die Links zwischen ihnen und die generierte Interpretation getrennt voneinander. Wenn du diese Ebenen auseinanderhältst, kannst du eine Antwort leichter überprüfen, statt jede generierte Verbindung als gesicherte Tatsache zu behandeln.
Gib Agenten Zugriff auf Struktur und Inhalte
IVGraph erstellt einen Graphen aus Notion-Seiten, Backlinks und Erwähnungen sowie Relationen in Datenbanken. Die V1 LLM API mit reinem Lesezugriff bietet Agenten Zugriff auf die Suche, Knotendetails und Seiteninhalte sowie die Möglichkeit, den Graphen zu durchlaufen. Zusammen reicht das aus, um einen Workflow zum Abrufen von Informationen zu entwickeln, der den Graphen berücksichtigt und auf einem Workspace aufbaut, den du bereits pflegst.
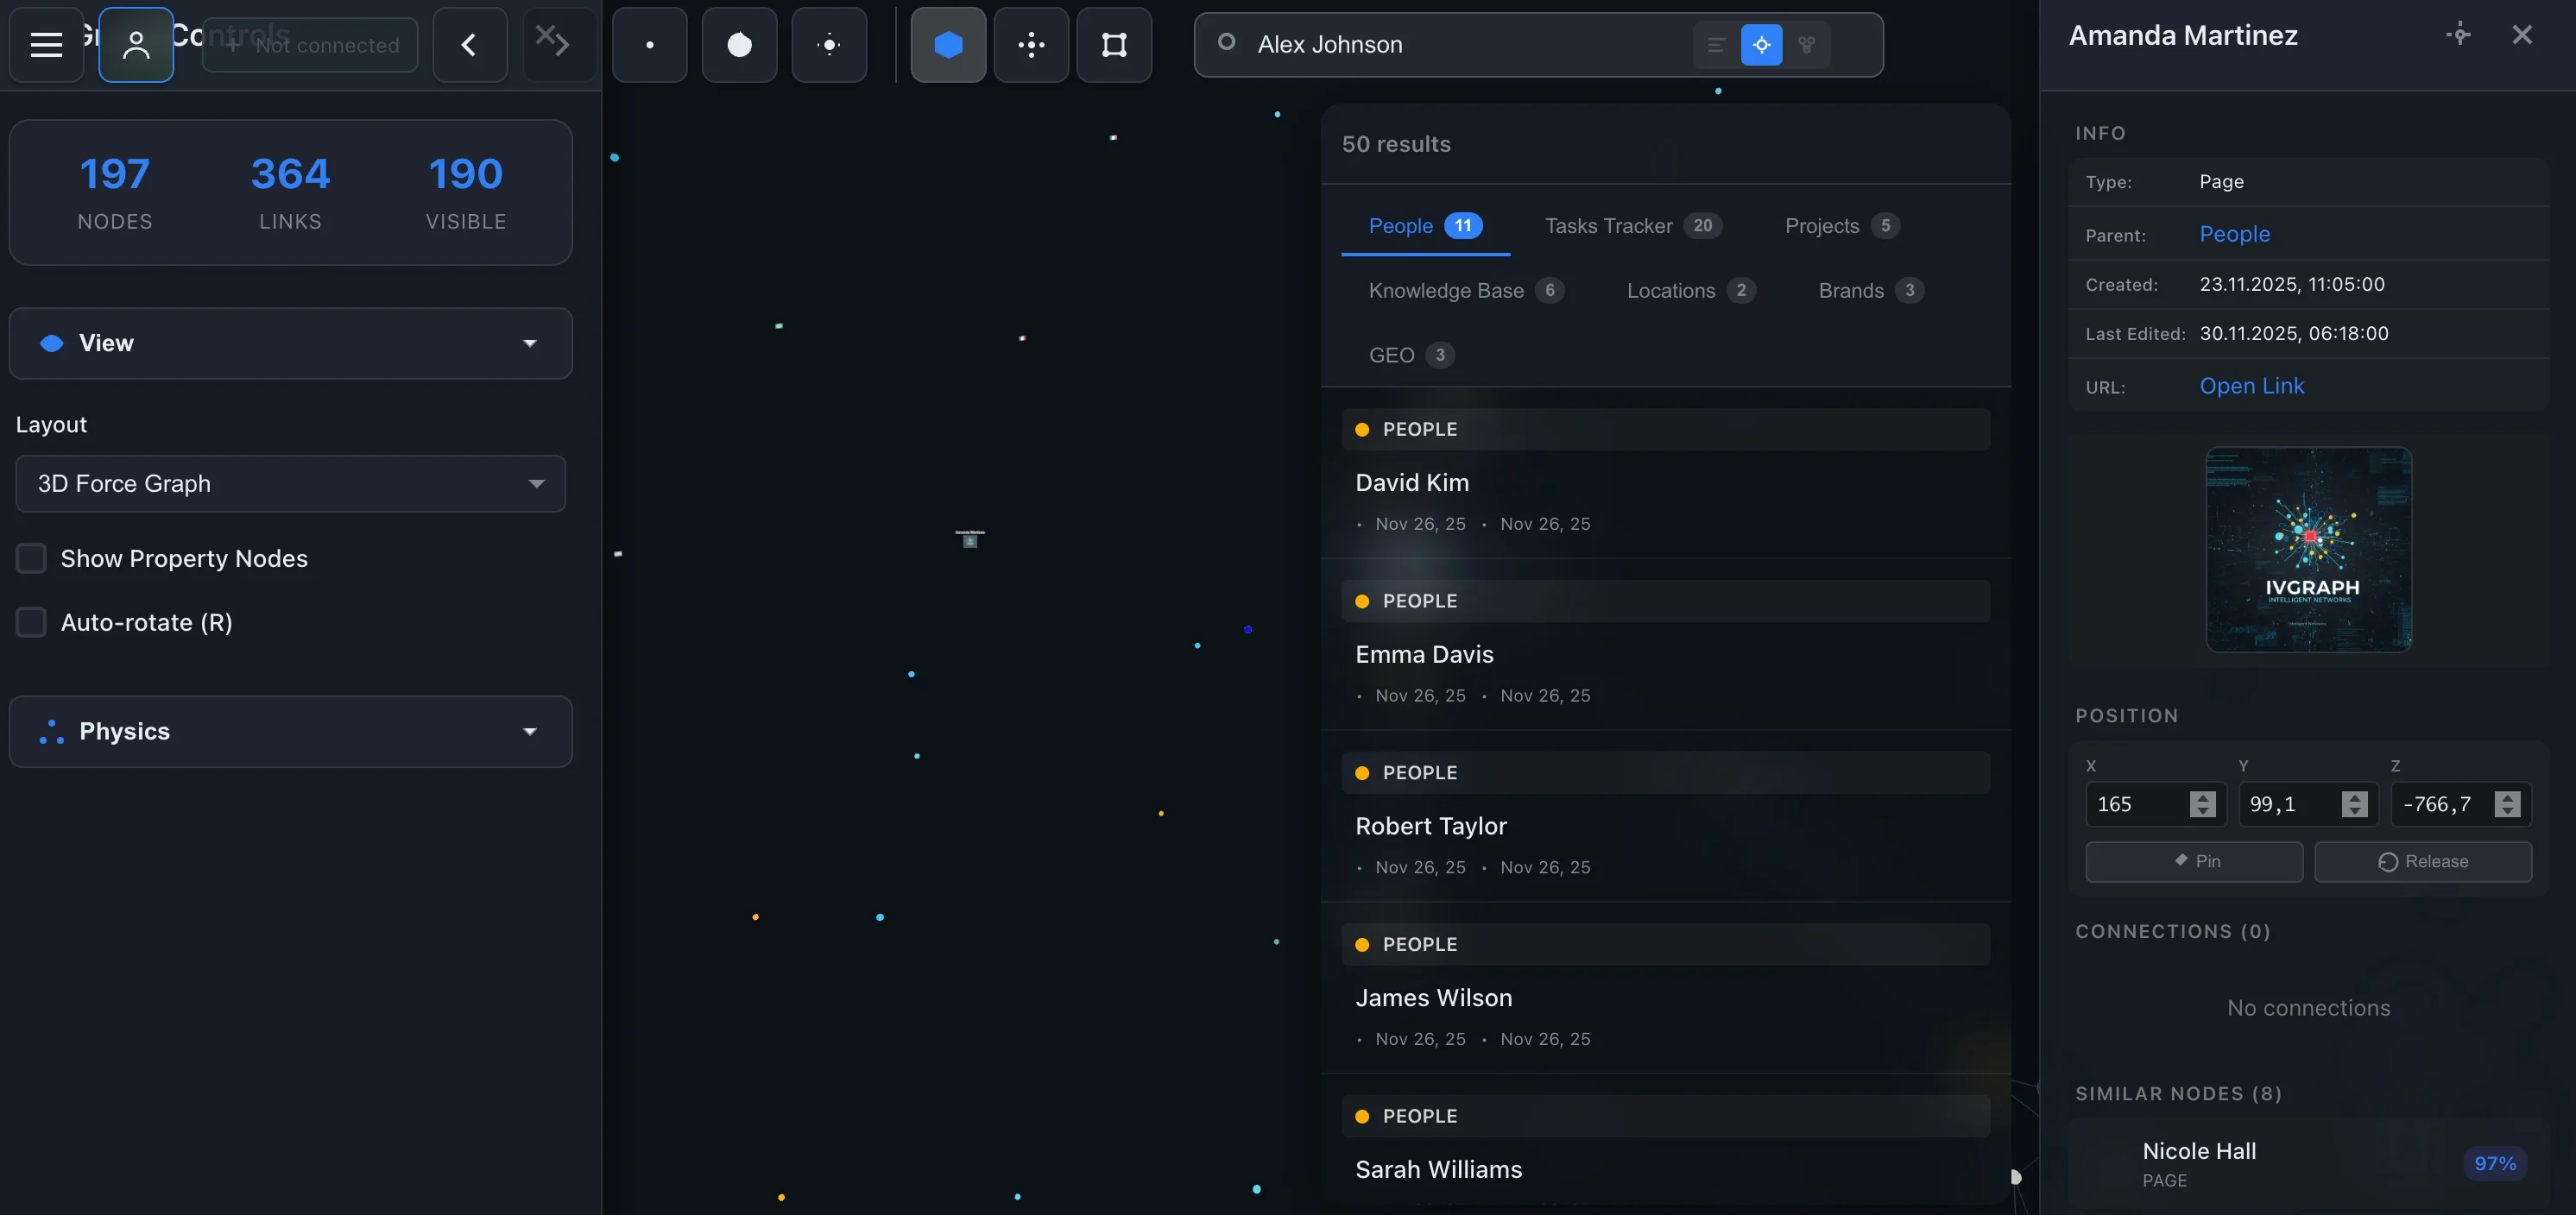
Ein einfacher Agenten-Workflow zum Testen sieht so aus: Suche nach dem Projekt, prüfe seinen Knoten, folge relevanten Links, rufe die Inhalte verknüpfter Seiten ab und beantworte die Frage auf dieser Grundlage. Einen umfassenderen persönlichen Workflow findest du unter Ein Second Brain mit einem LLM, Notion und Claude Code aufbauen.
Beginne nicht damit, Beziehungen zu extrahieren, die du bereits explizit pflegst. Teste zuerst, ob das Sichtbarmachen dieser Beziehungen das Problem des fehlenden Kontexts löst.
So fängst du klein an
Starte mit Fragen, nicht mit einer Datenbankmigration. Nutze diese Checkliste, damit das Experiment auf tatsächliche Probleme beim Wiederfinden von Informationen ausgerichtet bleibt:
- Wähle eine klar abgegrenzte Sammlung. Wähle einen Projektbereich, dessen Inhalte und Beziehungen du selbst prüfen kannst.
- Formuliere echte Fragen. Berücksichtige Fragen, die sich durch direktes Nachschlagen beantworten lassen, Fragen zu verknüpften Fakten und Fragen zur gesamten Sammlung, sofern sie für deine Arbeit relevant sind.
- Bestimme die erforderlichen Belege. Halte fest, welche Textstellen und Beziehungen eine korrekte Antwort nutzen muss.
- Teste eine vektorbasierte Referenzlösung. Speichere sowohl den abgerufenen Kontext als auch die generierte Antwort. Ermittle fehlende Belege, bevor du die Architektur änderst.
- Erfasse vorhandene Kanten. Trenne nützliche Beziehungen von beiläufigen Erwähnungen und Hierarchieverknüpfungen.
- Ergänze nur die fehlende Funktion. Teste die Traversierung für verknüpfte Fakten oder Microsofts Pipeline zur Extraktion und Zusammenfassung für die Fragen, für die sie konzipiert ist.
- Vergleiche und aktualisiere. Prüfe die Abdeckung der erforderlichen Belege, unbelegte Aussagen, Kosten und Antwortzeit. Bearbeite dann eine Quelle und prüfe die Aktualität.
Behalte die Graph-Ebene bei, wenn sie nötigen Kontext liefert, den der Basisansatz nicht erfasst, und die Kosten für dich tragbar sind. Wenn beide Ansätze gleich gute Antworten liefern, wähle den, den du leichter pflegen kannst.
Häufige Fragen
Was ist GraphRAG, einfach erklärt?
GraphRAG ist eine Form der Retrieval-Augmented Generation, die einen Wissensgraphen aus Entitäten und Beziehungen nutzt, um Kontext für ein LLM zu finden. Statt nur ähnliche Textpassagen zu finden, kann GraphRAG Informationen über die Verbindungen zwischen Entitäten abrufen.
Ist GraphRAG besser als Vektor-RAG?
Nicht bei jeder Frage. Vektor-RAG ist ein sinnvoller Ausgangspunkt, um relevante Textpassagen zu finden. Es lohnt sich, graphbasierten Abruf zu testen, wenn Antworten miteinander verknüpfte Fakten erfordern, während Microsofts Ansatz mit Community-Zusammenfassungen auch Fragen zum gesamten Datensatz unterstützt. Vergleiche die Ansätze anhand deiner eigenen Fragen und Quellen.
Ist Microsoft GraphRAG mit allen graphbasierten RAG-Ansätzen gleichzusetzen?
Nein. Microsoft GraphRAG ist eine Open-Source-Implementierung, die Entitäten und Beziehungen extrahiert, sie zu Gemeinschaften gruppiert, Zusammenfassungen erstellt und eine lokale sowie eine globale Suche bietet. Graphbasierter Abruf kann auch vorhandene Beziehungen nutzen, ohne diese vollständige Pipeline zur Extraktion und Zusammenfassung zu durchlaufen.
Was kostet GraphRAG?
Ohne Angaben zum Datenkorpus, zur Modellwahl und zur Pipeline-Konfiguration lässt sich kein sinnvoller pauschaler Preis nennen. Plane Kosten für die Extraktion und die Erstellung von Zusammenfassungen ein, sofern diese zum Einsatz kommen, sowie für den Abruf, die Antwortgenerierung, die Speicherung und Aktualisierungen. Ermittle die Kosten anhand einer kleinen repräsentativen Stichprobe, statt einen festen Kostenfaktor gegenüber vektorbasiertem RAG anzunehmen.
Kann ich Notion-Links für GraphRAG nutzen?
Ja. Relationen in Datenbanken, Erwähnungen und Backlinks sowie über- und untergeordnete Seiten können explizite Kanten im Graphen liefern, ohne dass ein LLM sie extrahieren muss. Du brauchst dennoch einen Retrieval-Workflow, der relevante Seiten auswählt, deren Inhalte liest und dem antwortenden Modell Belege liefert. Ein Seitenlink allein erklärt die Beziehung nicht.