 IVGraph
GraphRAG es generación aumentada por recuperación que utiliza un grafo de conocimiento de entidades y relaciones para encontrar contexto para un LLM. Vale la pena probarlo cuando una respuesta depende de hechos conectados o de patrones que abarcan una colección, pero no por defecto cuando solo necesitas el párrafo adecuado. El RAG vectorial sigue siendo un punto de partida razonable, y suele ser más útil explorar un diseño que combine ambos.
En pocas palabras: la similitud encuentra fragmentos; los grafos conectan hechos
La recuperación vectorial plantea esta pregunta: ¿Qué pasajes tienen un significado similar al de esta pregunta? La recuperación mediante grafos añade otra: ¿Qué está conectado con los elementos de los que trata esta pregunta?
Imagina un espacio de trabajo para un proyecto. La respuesta a «¿Cómo desplegamos el servicio?» podría estar en un solo manual de operaciones. Para responder a «¿Qué lanzamiento depende del servicio a cargo del equipo que gestiona este incidente?», hay que seguir las conexiones entre un incidente, un equipo, un servicio y un lanzamiento.
Esa es la diferencia práctica entre RAG basado en grafos y RAG vectorial. No se trata de «recuperación inteligente frente a recuperación tonta». Se trata de elegir qué estructura te ayuda a reunir las pruebas necesarias.
RAG en un párrafo y las limitaciones de la búsqueda vectorial
La generación aumentada por recuperación recupera información relevante y se la proporciona a un LLM como contexto antes de que el modelo responda. El RAG vectorial clásico divide los documentos en fragmentos, los codifica como representaciones numéricas y los recupera según su similitud vectorial con la pregunta. El modelo que genera la respuesta trabaja entonces con el texto seleccionado. La comparativa de Meilisearch describe la diferencia fundamental: recuperación basada en la similitud frente a recuperación a través de entidades conectadas.
Para una pregunta como «¿Qué dice nuestra política de reembolsos sobre las cancelaciones?», puede bastar con encontrar el fragmento pertinente de la política. No necesitas modelar cada cliente, política y producto como un nodo para probar ese flujo de trabajo.
Las limitaciones se vuelven más interesantes cuando el contexto necesario está distribuido:
- Preguntas de varios saltos: para responder hay que seguir varias relaciones, no localizar un único pasaje que coincida.
- Preguntas globales: «¿Qué temas se repiten en las retrospectivas de nuestros proyectos?» es una pregunta sobre el conjunto, no solo sobre las coincidencias más cercanas.
- Datos dispersos: distintas páginas contienen diferentes partes de la respuesta, y algunas de ellas pueden no parecerse a la pregunta original.
En el ejemplo del incidente, puede que una página de lanzamiento no mencione nunca el incidente. Recuperar fragmentos que se parecen a la pregunta no es lo mismo que seguir una dependencia documentada hasta ese lanzamiento.
Esto no significa que la recuperación vectorial no pueda proporcionar la respuesta. Significa que debes comprobar si recupera todos los elementos necesarios, en lugar de evaluarla en función de si el primer resultado parece relevante.
Cómo funciona Microsoft GraphRAG, paso a paso
Microsoft GraphRAG es un sistema RAG de código abierto basado en grafos. Su flujo de extracción, detección de comunidades y generación de resúmenes ofrece una referencia útil para entender este enfoque. Divide el trabajo en dos etapas: preparar la colección y responder preguntas a partir de ella.
Indexación: convierte el texto en contexto interconectado
- Extraer entidades. Un LLM identifica los elementos de los que se habla en el material de origen. En una colección hipotética de documentos de ingeniería, podrían ser servicios, equipos, proyectos e incidentes.
- Extraer relaciones. El LLM identifica las conexiones entre esas entidades. Por ejemplo, un documento podría indicar que un equipo concreto es responsable de un servicio.
- Construir el grafo. Las entidades se convierten en nodos y las relaciones en enlaces, lo que proporciona una representación interconectada del material para la recuperación de información.
- Agrupar entidades en comunidades. El sistema organiza el grafo en grupos conectados, en lugar de tratar cada entidad de forma aislada.
- Redactar resúmenes de las comunidades. Los resúmenes generados ofrecen una visión general de esos grupos para recuperar información y responder preguntas posteriormente.
El cambio importante es que el sistema no solo prepara fragmentos en los que se puede buscar. También prepara una representación de aquello de lo que hablan esos fragmentos, de cómo se conectan esos elementos y de qué contienen los grupos de elementos conectados.
Consultas: preguntas locales frente a preguntas globales
La búsqueda local se centra en las entidades. Piensa en esta pregunta: «¿Qué está conectado al servicio de facturación?». El contexto relevante se organiza en torno a una entidad concreta y sus relaciones.
La búsqueda global abarca todo el conjunto de datos. Por ejemplo: «¿Qué problemas de coordinación se repiten en estos proyectos?». Los resúmenes de las comunidades aportan material para una síntesis más amplia, en lugar de basarse únicamente en fragmentos similares a la pregunta.
La documentación de GraphRAG de Microsoft distingue entre indexación, métodos de consulta y ajuste de instrucciones. Para una evaluación inicial, la distinción útil es sencilla: ¿estás investigando algo en concreto o buscas una visión global de la colección?
No confundas «local» con «se ejecuta en mi portátil». Aquí se refiere al alcance de la búsqueda. Tampoco supongas que todas las consultas al grafo necesitan resúmenes de comunidades: seguir las relaciones explícitas entre páginas es un flujo de recuperación de información del grafo más acotado.
RAG de grafos frente a RAG vectorial: comparación práctica
La columna del grafo que aparece a continuación incluye el enfoque de extracción y resumen de Microsoft. Un flujo de trabajo basado en enlaces existentes puede omitir la extracción de esos enlaces, por lo que su configuración no es idéntica.
| Dimensión | RAG vectorial | RAG basado en grafos |
|---|---|---|
| Modelo de datos | Fragmentos de texto representados mediante embeddings. | Entidades o páginas conectadas mediante relaciones; Microsoft GraphRAG también crea resúmenes de comunidades. |
| Trabajo y coste de indexación | Preparar los fragmentos y generar embeddings. | Preparar la estructura del grafo; prever el coste de la extracción mediante LLM y de los resúmenes si el flujo de procesamiento los utiliza. |
| Preguntas para probar primero | Preguntas que se pueden responder con un pasaje relevante o un pequeño conjunto de pasajes. | Preguntas sobre hechos relacionados; síntesis del conjunto completo de datos cuando hay resúmenes de comunidades disponibles. |
| Explicabilidad | Examinar los pasajes recuperados y sus fuentes. | Examinar las fuentes recuperadas y las rutas de relaciones; una ruta visible sigue necesitando pruebas que la respalden. |
| Actualización y mantenimiento | Planificar cómo se reflejarán los cambios del texto en los fragmentos y los embeddings. | Planificar también cómo afectarán los cambios a las relaciones y a los resúmenes que se hayan generado. |
| Herramientas o componentes habituales | Un modelo de embeddings, un índice vectorial, un repositorio de fuentes y un LLM que genere respuestas. | Una representación en forma de grafo y lógica de recuperación; Microsoft GraphRAG es una implementación de código abierto que puedes evaluar. |
| Fallos que hay que vigilar | Resultados que parecen relevantes, pero omiten un dato necesario. | Relaciones ausentes o engañosas, o resúmenes que omiten detalles necesarios. |
Mi regla de partida: si las pruebas caben en un pasaje, prueba primero la recuperación de pasajes. Si las pruebas forman una cadena, prueba a recuperar esa cadena. Si la pregunta se refiere a la colección, prueba un enfoque a nivel de colección.
Cuándo usar cada uno y cuándo combinarlos
Empieza con RAG vectorial para respuestas en forma de fragmentos de texto
Las políticas, las instrucciones y las explicaciones son casos útiles para empezar cuando la respuesta esperada se encuentra en un texto identificable. Establece un punto de referencia antes de introducir otra representación de la misma colección.
Pregúntate si el fallo se produjo al recuperar la información o al generar la respuesta. Si ya se contaba con la evidencia correcta, añadir un grafo quizá no resuelva el verdadero problema.
Prueba la recuperación de información mediante grafos para obtener respuestas estructuradas en torno a relaciones
Usa preguntas cuya respuesta dependa realmente de las conexiones: qué proyectos dependen de un servicio, qué decisiones están vinculadas a un requisito o qué notas de investigación respaldan un argumento. Estos son casos de evaluación propuestos, no promesas de mayor precisión.
Comprueba si tus datos contienen esas relaciones. Un grafo no puede recorrer una arista útil que no proporcionen ni la estructura de tus datos de origen ni tu proceso de extracción.
Prueba un flujo de trabajo híbrido antes de reemplazarlo todo
Un diseño práctico que se puede poner a prueba combina puntos de entrada semánticos con la expansión del grafo:
- Busca texto o nodos relevantes para la pregunta.
- Sigue las relaciones seleccionadas desde esos puntos de partida.
- Obtén el contenido de origen de los elementos conectados.
- Proporciona al modelo que responde las evidencias y las referencias a sus fuentes.
En el ejemplo del incidente, la búsqueda podría encontrar el informe del incidente. A continuación, al recorrer el grafo, se podrían seguir los enlaces hasta el servicio afectado y el lanzamiento que depende de él. La lectura de esas páginas aporta las pruebas concretas para responder.
Define los límites antes de hacer pruebas: ¿qué tipos de relaciones son útiles, hasta dónde debe llegar el recorrido y cuánto contenido debe devolverse? «Incluir todo lo que esté conectado» no es una estrategia de recuperación; es una forma de evitar elegir.
Cuánto cuesta GraphRAG en la práctica
No se puede justificar un precio universal —ni un multiplicador de costes fijo— sin un corpus, un modelo elegido y una configuración. La pregunta útil para elaborar un presupuesto es: ¿qué trabajo añade este flujo de procesamiento?
Para el enfoque de Microsoft basado en la extracción y el resumen, incluye el trabajo del modelo para extraer entidades y relaciones y generar resúmenes de comunidades. Estos pasos de preparación se añaden a los de un flujo básico de fragmentación y generación de embeddings. No des por hecho que «de código abierto» significa que dispones de presupuesto para ejecutar ese trabajo.
Para una prueba piloto, registra los costes por separado:
- Preparación inicial: generación de embeddings, extracción y generación de resúmenes donde tu diseño los utilice.
- Preguntas: tareas de recuperación, contexto proporcionado al LLM y generación de respuestas.
- Actualizaciones: trabajo necesario para reflejar los cambios en las fuentes en las representaciones que mantienes.
- Operaciones: almacenamiento, depuración y revisión de relaciones incorrectas o faltantes.
Las actualizaciones merecen una prueba específica. Edita una afirmación en la fuente, vuelve a ejecutar el flujo de actualización que hayas elegido y revisa la respuesta resultante. Comprueba el contenido original, su representación en el grafo y cualquier resumen que se haya basado en la afirmación anterior. No des por hecho que una indexación inicial correcta demuestra que la colección se mantiene actualizada.
Si las aristas ya existen como enlaces explícitos, puedes prescindir de la extracción mediante LLM para esas aristas. Eso no elimina la recuperación de contenido, la generación de respuestas ni el mantenimiento. Elimina un paso concreto, no todos los costes asociados al RAG basado en grafos.
Tus notas ya tienen una estructura de grafo
Un espacio de trabajo interconectado ofrece un punto de partida distinto al de una carpeta de documentos desconectados. Notion ya contiene aristas explícitas mediante las propiedades de Relación de las bases de datos, las menciones de páginas y los backlinks, y las relaciones entre páginas principales y secundarias. Las bóvedas de Obsidian tienen enlaces wiki. Esos enlaces pueden convertirse en aristas del grafo sin pedirle a un LLM que los descubra.
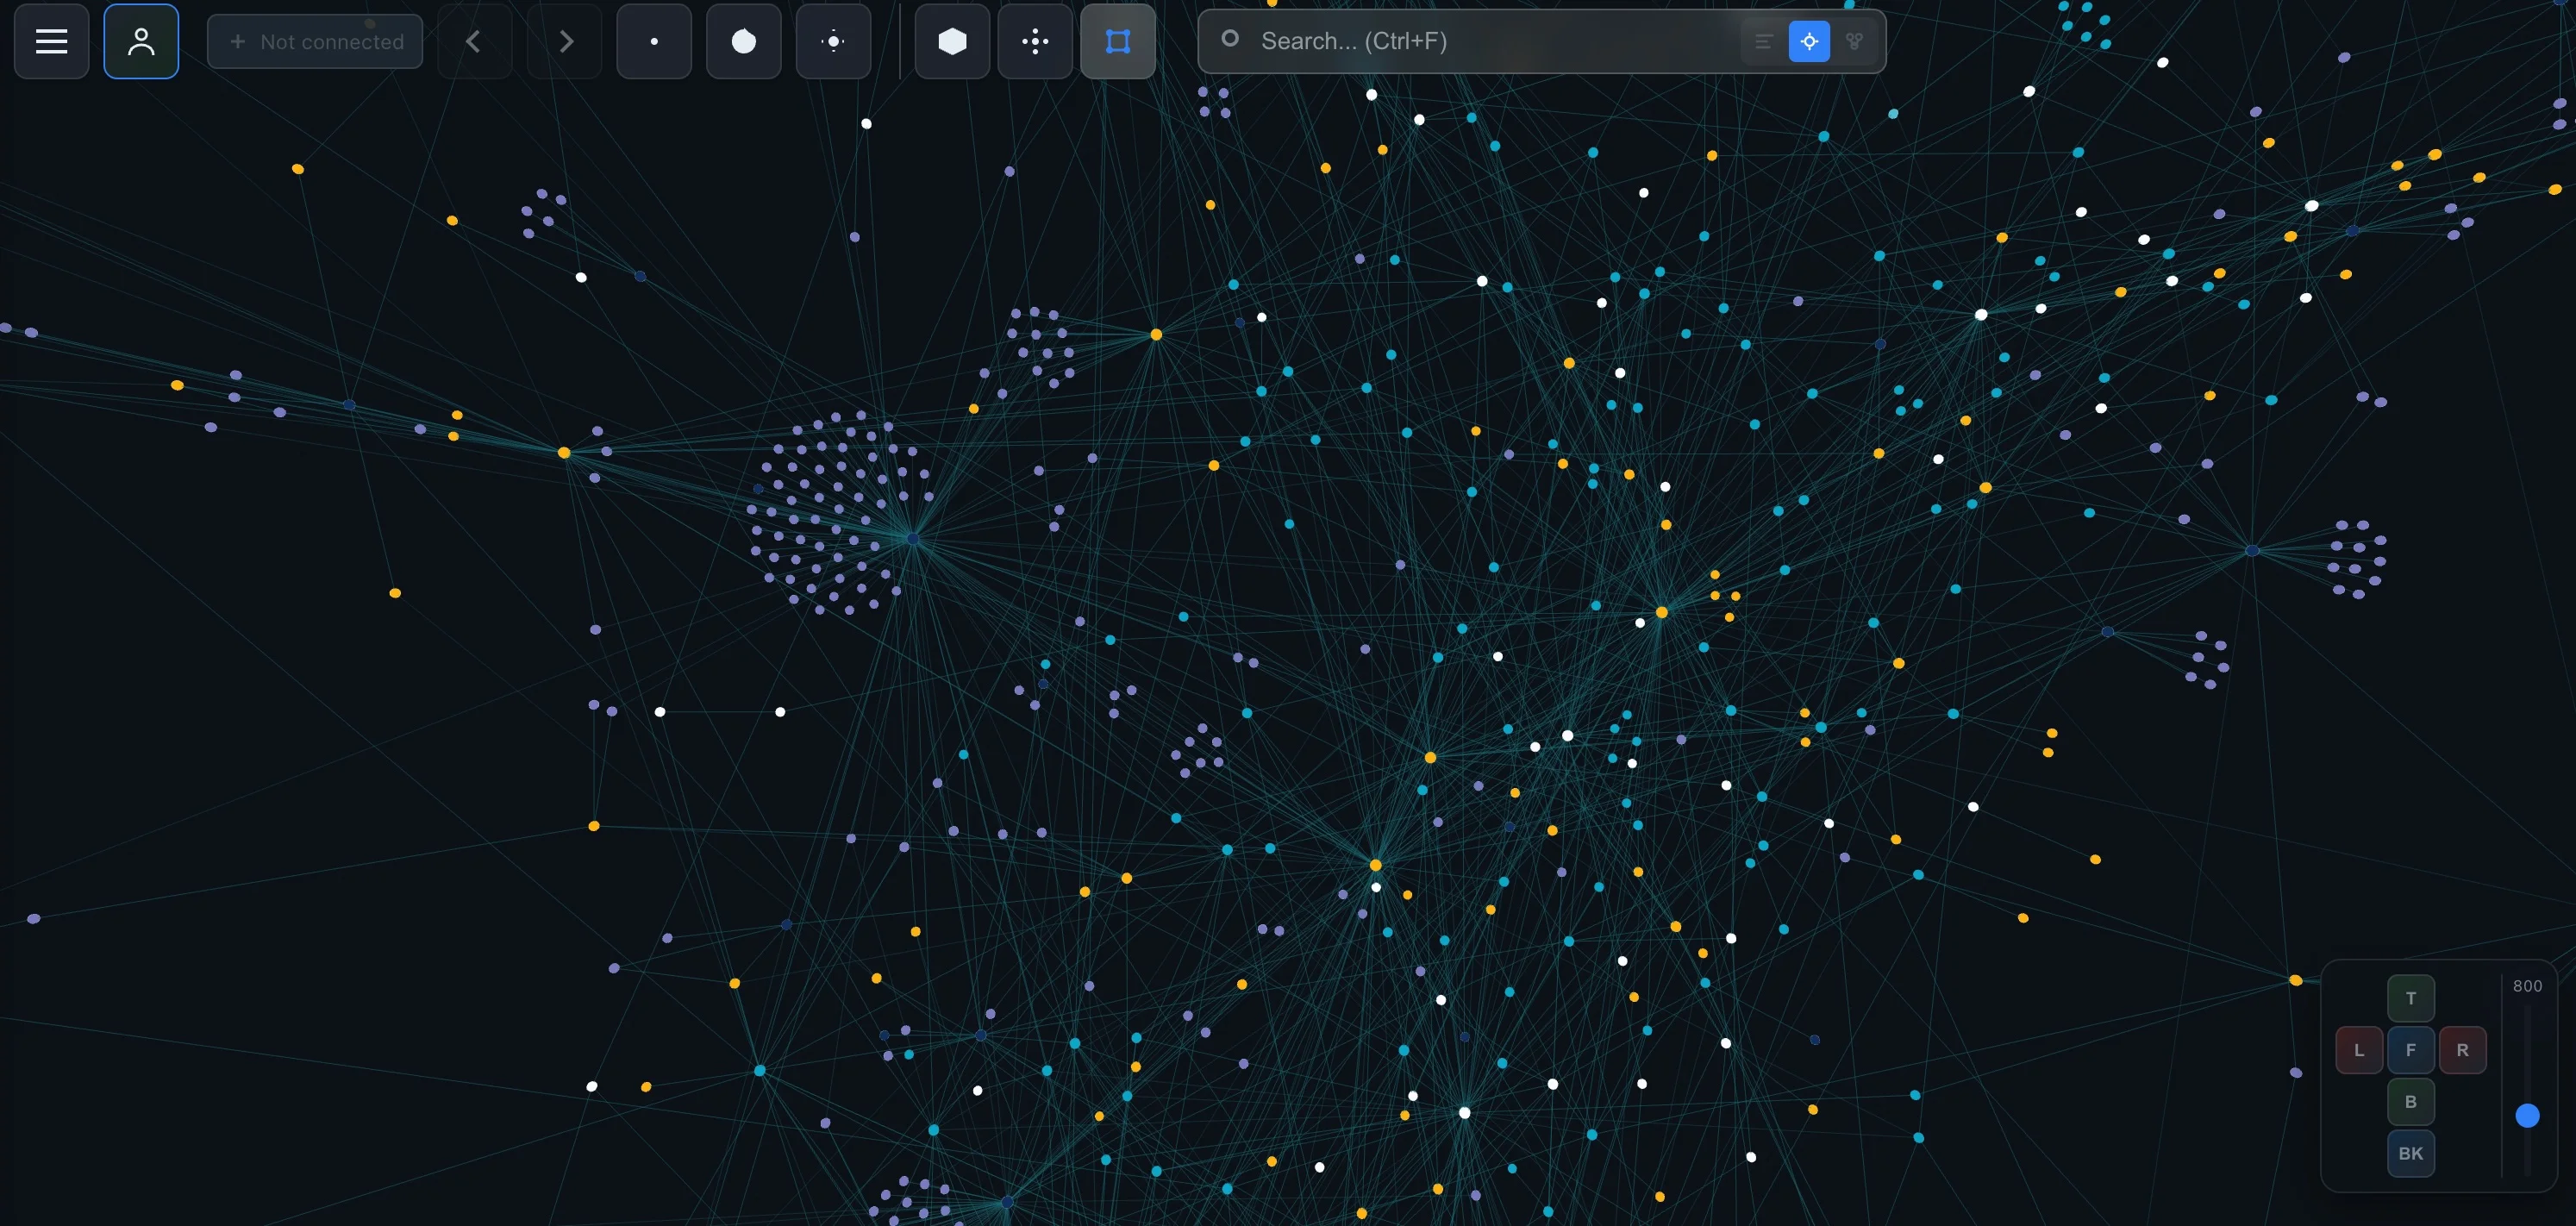
Supongamos que tu base de datos hipotética de Proyectos está relacionada con una base de datos de Servicios, mientras que las notas de incidentes mencionan páginas de servicios. Ya tienes un recorrido desde una nota de incidente hasta un servicio y, desde ahí, hasta los proyectos relacionados. Nuestra guía sobre las relaciones entre bases de datos de Notion aborda los enlaces explícitos; la guía del grafo de conocimiento de Notion, más amplia, pone esos enlaces en contexto.
Una advertencia, para ser sinceros: un grafo de páginas no es automáticamente un grafo de conocimiento de entidades. Una página puede tratar sobre varias entidades. Una mención indica que una página hace referencia a otra, pero no necesariamente que un servicio depende de otro. Un enlace padre-hijo expresa una jerarquía, no una relación de propiedad ni de causalidad.
Mantén esa distinción al recuperar información. Sigue una mención para encontrar pruebas que puedan ser útiles y luego lee la página antes de afirmar qué significa esa relación.
Esto conecta de forma natural con una wiki de LLM: considera por separado las páginas de origen, los enlaces entre ellas y la interpretación generada. Mantener estas capas diferenciadas facilita la revisión de una respuesta, en lugar de tratar cada conexión generada como un hecho establecido.
Da a los agentes acceso a la estructura y al contenido
IVGraph crea un grafo a partir de páginas de Notion, backlinks y menciones, y propiedades de Relación de las bases de datos. Su API V1 para LLM de solo lectura permite a los agentes realizar búsquedas, consultar los detalles de los nodos y el contenido de las páginas, y recorrer el grafo. En conjunto, estas funciones bastan para crear un flujo de recuperación de información que tenga en cuenta el grafo y se base en un espacio de trabajo que ya mantienes.
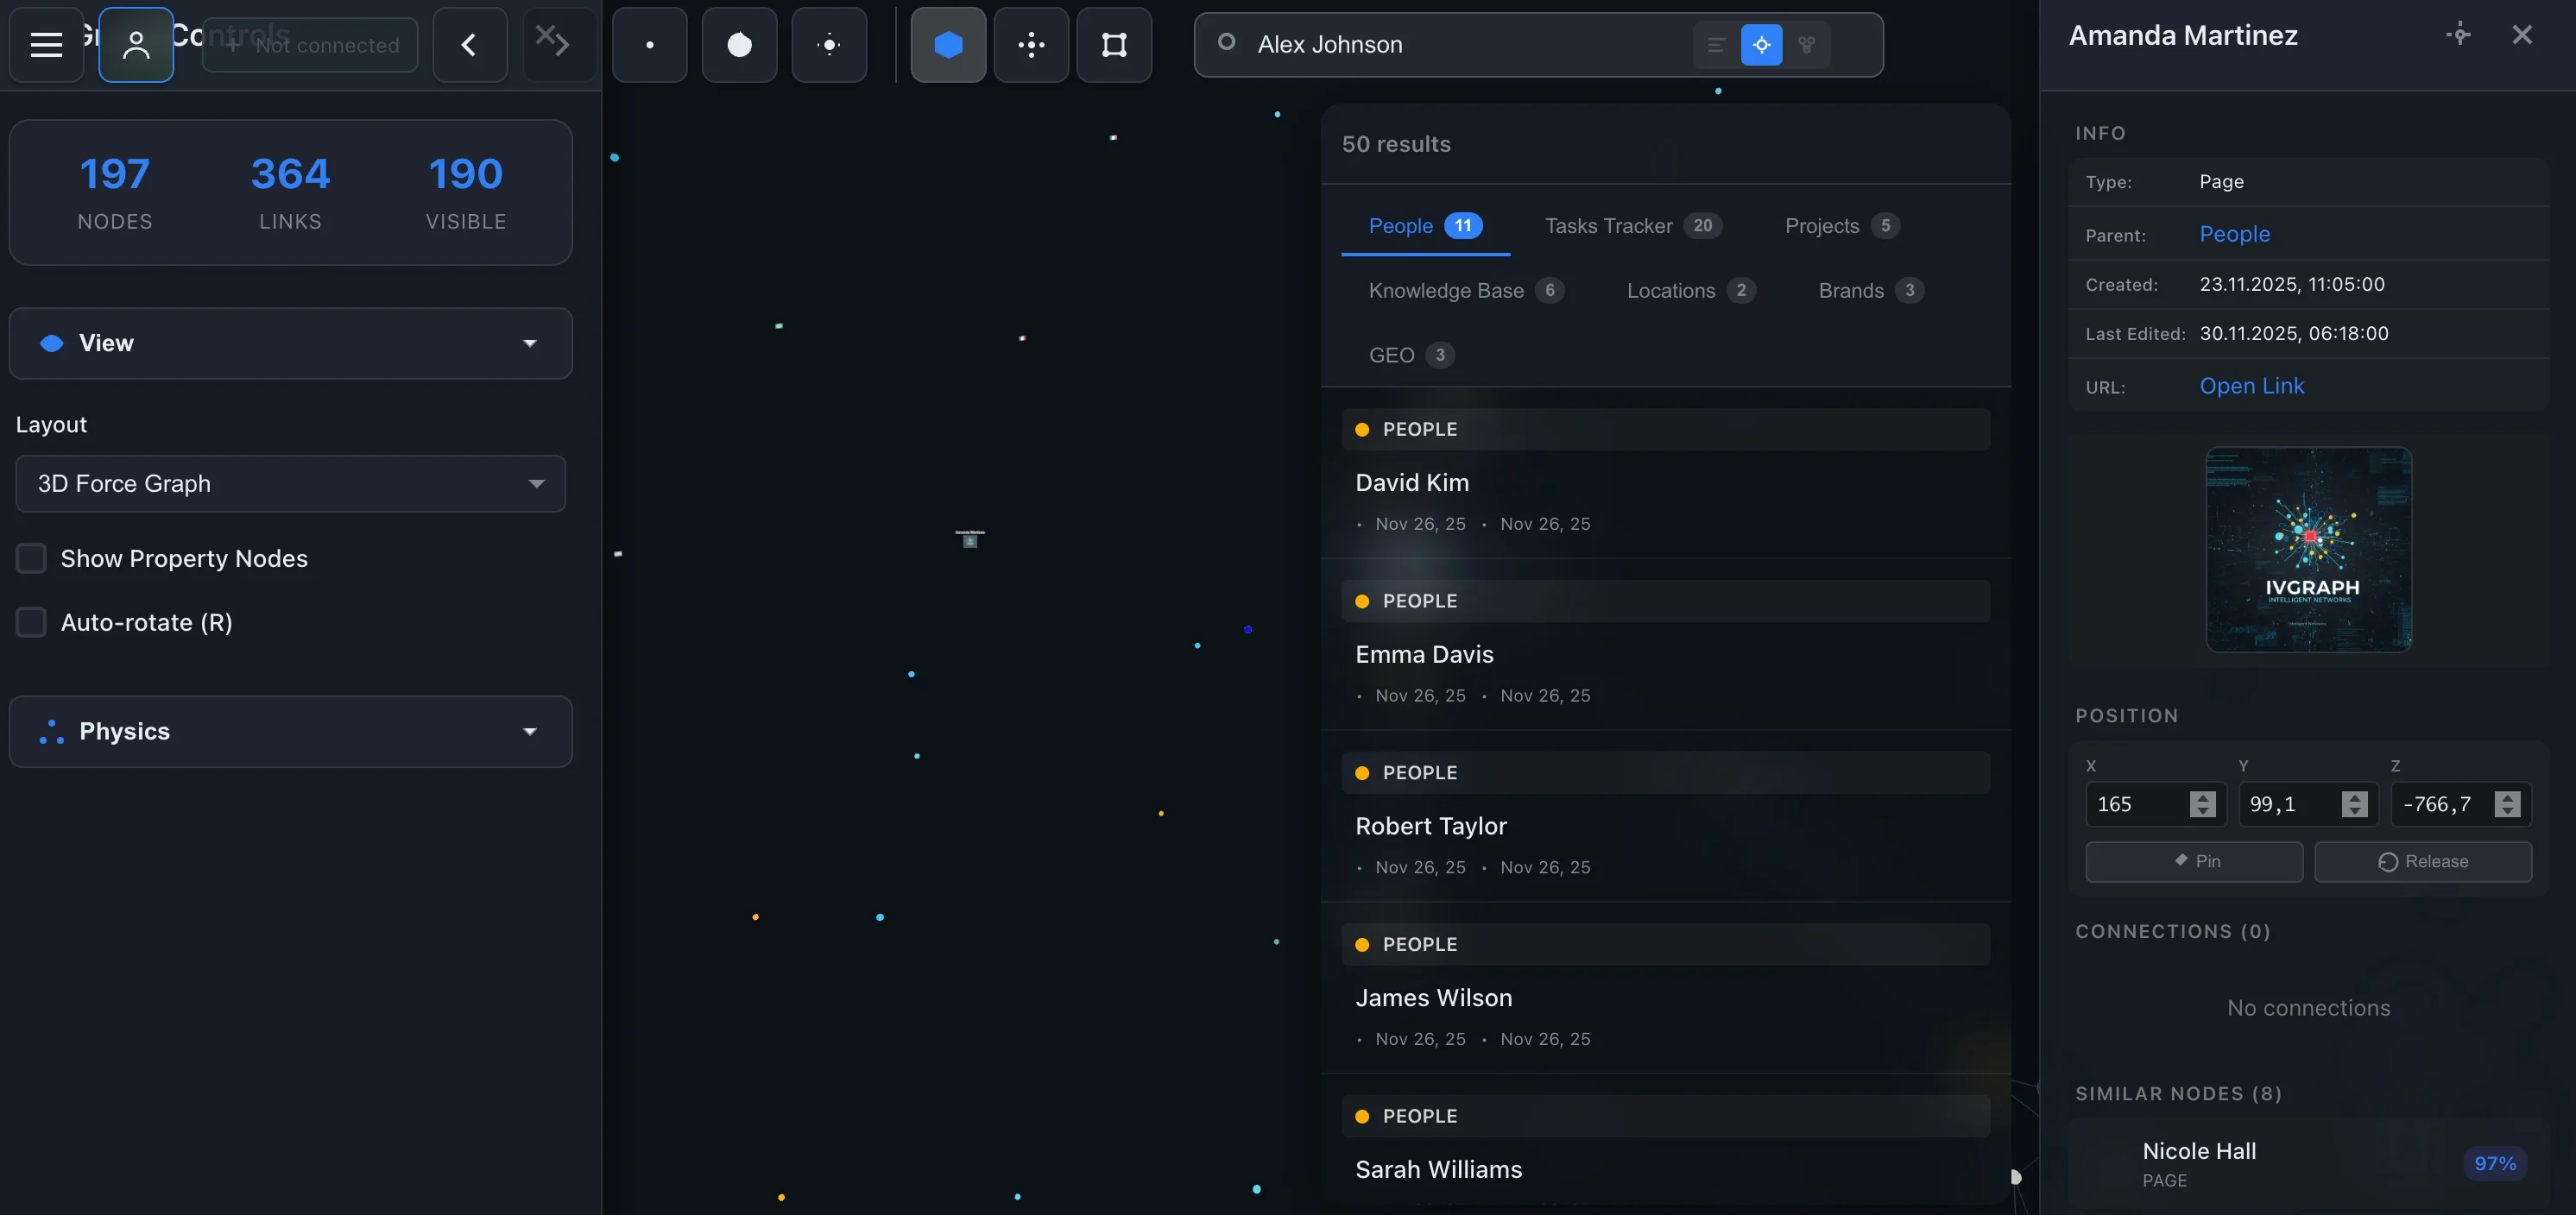
Un flujo de trabajo sencillo para probar con un agente consiste en buscar el proyecto, examinar su nodo, seguir los enlaces relevantes, obtener el contenido de las páginas conectadas y responder basándose en la información obtenida. Para un flujo de trabajo personal más amplio, consulta cómo crear un segundo cerebro con un LLM, Notion y Claude Code.
No empieces por extraer relaciones que ya mantienes de forma explícita. Primero comprueba si hacer visibles esas relaciones resuelve el problema de la falta de contexto.
Cómo empezar a pequeña escala
Empieza con preguntas, no con la migración de una base de datos. Usa esta lista de verificación para mantener el experimento vinculado a fallos reales en la recuperación de información:
- Elige una colección acotada. Selecciona un área de proyecto cuyo contenido y relaciones puedas revisar por tu cuenta.
- Formula preguntas reales. Incluye consultas directas, preguntas sobre hechos relacionados y preguntas sobre toda la colección si son relevantes para tu trabajo.
- Identifica la evidencia necesaria. Anota qué pasajes y relaciones debe utilizar una respuesta correcta.
- Ejecuta una prueba de referencia con búsqueda vectorial. Guarda tanto el contexto recuperado como la respuesta generada. Identifica la evidencia que falta antes de cambiar la arquitectura.
- Haz un inventario de las aristas existentes. Separa las relaciones útiles de las menciones circunstanciales y los enlaces jerárquicos.
- Añade solo la capacidad que falta. Prueba el recorrido del grafo para los hechos relacionados, o el flujo de procesamiento de extracción y resumen de Microsoft para las preguntas que está diseñado para abordar.
- Compara y actualiza. Revisa la cobertura de la evidencia, las afirmaciones sin respaldo, el coste y el tiempo de respuesta. Después, edita una fuente y comprueba si la información está actualizada.
Conserva la capa de grafo si recupera el contexto necesario que el enfoque de referencia pasa por alto, a un coste que puedas asumir. Si ambos enfoques responden igual de bien, prefiere el que te resulte más fácil de mantener.
Preguntas frecuentes
¿Qué es GraphRAG en términos sencillos?
GraphRAG es generación aumentada por recuperación que utiliza un grafo de conocimiento de entidades y relaciones para encontrar contexto para un LLM. En lugar de encontrar solo fragmentos similares, puede recuperar información a través de las conexiones entre elementos.
¿Es GraphRAG mejor que el RAG vectorial?
No para todas las preguntas. El RAG vectorial es un punto de partida razonable para encontrar fragmentos relevantes. Vale la pena probar la recuperación basada en grafos cuando las respuestas requieren hechos relacionados entre sí, mientras que el enfoque de Microsoft basado en resúmenes de comunidades también permite responder preguntas sobre el conjunto de datos completo. Compáralos utilizando tus propias preguntas y fuentes.
¿Microsoft GraphRAG es lo mismo que cualquier RAG basado en grafos?
No. Microsoft GraphRAG es una implementación de código abierto que extrae entidades y relaciones, las agrupa en comunidades, genera resúmenes y ofrece búsquedas locales y globales. La recuperación basada en grafos también puede aprovechar relaciones existentes sin pasar por todo ese proceso de extracción y generación de resúmenes.
¿Cuánto cuesta GraphRAG?
No hay un precio único que sirva de referencia sin definir el corpus, el modelo y la configuración del flujo de procesamiento. Contempla en el presupuesto la extracción y la generación de resúmenes cuando se utilicen, la recuperación y la generación de respuestas, el almacenamiento y las actualizaciones. Mide los costes con una pequeña muestra representativa en lugar de asumir un multiplicador fijo respecto al RAG vectorial.
¿Puedo usar enlaces de Notion para GraphRAG?
Sí. Las propiedades Relación de las bases de datos, las menciones y los backlinks, y las páginas principales y sus subpáginas pueden aportar aristas explícitas al grafo sin recurrir a la extracción mediante un LLM. Aun así, necesitas un flujo de recuperación que seleccione las páginas relevantes, lea su contenido y proporcione evidencias al modelo que genera la respuesta. Un enlace a una página, por sí solo, no explica la relación.