 IVGraph
GraphRAG est une méthode de génération augmentée par récupération qui utilise un graphe de connaissances composé d’entités et de relations pour trouver des éléments de contexte pour un LLM. Elle mérite d’être testée lorsqu’une réponse dépend de faits liés entre eux ou de régularités au sein d’un ensemble de documents, mais pas systématiquement si vous avez simplement besoin de trouver le bon paragraphe. Le RAG vectoriel reste un point de départ pertinent, et combiner les deux est souvent une approche plus utile à explorer.
En bref : la similarité repère des passages ; les graphes relient les faits
La recherche vectorielle pose la question suivante : Quels passages ont un sens proche de celui de cette question ? La recherche par graphe ajoute une autre question : Qu’est-ce qui est relié aux éléments sur lesquels porte cette question ?
Imaginez un espace de travail dédié à un projet. Un seul guide opérationnel peut répondre à la question « Comment déployer le service ? ». Pour répondre à « Quel lancement dépend du service dont est responsable l’équipe qui gère cet incident ? », il faut suivre les liens entre un incident, une équipe, un service et un lancement.
C’est la différence concrète entre le RAG par graphe et le RAG vectoriel. Il ne s’agit pas d’opposer une « recherche intelligente » à une « recherche stupide ». Il s’agit de choisir la structure qui vous aide à rassembler les éléments probants nécessaires.
Le RAG en un paragraphe — et les limites de la recherche vectorielle
La génération augmentée par récupération recherche les informations pertinentes et les fournit à un LLM comme contexte avant qu’il ne réponde. Le RAG vectoriel classique découpe les documents en fragments, encode ces fragments sous forme de représentations numériques et les récupère selon leur similarité vectorielle avec la question. Le modèle qui produit la réponse s’appuie ensuite sur le texte sélectionné. Le comparatif de Meilisearch décrit la distinction fondamentale : la récupération fondée sur la similarité, par opposition à la récupération via des entités reliées entre elles.
Pour une question comme « Que prévoit notre politique de remboursement en cas d’annulation ? », il peut suffire de trouver le passage pertinent de cette politique. Vous n’avez pas besoin de représenter chaque client, chaque politique et chaque produit par un nœud pour tester ce processus.
Les limites deviennent plus intéressantes lorsque le contexte nécessaire est réparti à plusieurs endroits :
- Questions à plusieurs étapes : pour répondre, il faut suivre plusieurs relations, et non trouver un seul passage correspondant à la question.
- Questions globales : la question « Quels thèmes reviennent dans nos rétrospectives de projet ? » porte sur l’ensemble des contenus, et pas seulement sur ceux qui correspondent le mieux à la question.
- Faits dispersés : différentes pages contiennent différentes parties de la réponse, et certaines de ces parties peuvent ne pas ressembler à la question initiale.
Dans l’exemple de l’incident, une page de lancement peut ne jamais mentionner l’incident. Retrouver des passages dont la formulation ressemble à celle de la question ne revient pas à suivre une dépendance documentée menant à ce lancement.
Cela ne signifie pas que la recherche vectorielle ne peut pas fournir la réponse. Cela signifie que vous devez vérifier si elle retrouve tous les éléments nécessaires, plutôt que de la juger sur la pertinence apparente du premier résultat.
Comment fonctionne Microsoft GraphRAG, étape par étape
Microsoft GraphRAG est un système RAG open source fondé sur les graphes. Son pipeline d’extraction, de détection de communautés et de synthèse constitue une référence utile pour comprendre cette approche. Divisez le travail en deux étapes : préparer le corpus, puis répondre aux questions à partir de celui-ci.
Indexation : transformez le texte en contexte interconnecté
- Extraire les entités. Un LLM identifie les éléments abordés dans les contenus sources. Dans une collection hypothétique de documents d’ingénierie, il pourrait s’agir de services, d’équipes, de projets et d’incidents.
- Extraire les relations. Le LLM identifie les liens entre ces entités. Par exemple, un document peut indiquer qu’une équipe donnée est responsable d’un service.
- Construire le graphe. Les entités deviennent des nœuds et les relations deviennent des liens, offrant ainsi une représentation interconnectée des contenus pour la recherche d’informations.
- Regrouper les entités en communautés. Le système organise le graphe en groupes d’entités reliées entre elles, plutôt que de traiter chaque entité isolément.
- Rédiger des résumés des communautés. Les résumés générés offrent une vue d’ensemble de ces groupes pour la recherche d’informations et la génération de réponses ultérieures.
Le changement important, c’est que le système ne prépare pas seulement des passages dans lesquels effectuer des recherches. Il prépare aussi une représentation des sujets abordés dans ces passages, des liens entre ces sujets et du contenu des groupes de sujets reliés entre eux.
Requêtes : questions locales ou globales
La recherche locale est centrée sur une entité. Par exemple : « Qu’est-ce qui est relié au service de facturation ? » Le contexte pertinent est organisé autour d’une entité précise et de ses relations.
La recherche globale porte sur l’ensemble du jeu de données. Par exemple : « Quels problèmes de coordination récurrents retrouve-t-on dans ces projets ? » Les résumés des communautés servent de base à une synthèse plus large, qui ne repose pas uniquement sur des passages similaires à la question.
La documentation GraphRAG de Microsoft distingue l’indexation, les méthodes de requête et l’ajustement des prompts. Pour une première évaluation, la distinction utile est simple : cherchez-vous à explorer un élément précis ou à obtenir une vue d’ensemble de la collection ?
Ne confondez pas « local » avec « s’exécute sur mon ordinateur portable ». Ici, ce terme désigne le périmètre de recherche. Et ne partez pas du principe que chaque requête sur un graphe nécessite des résumés de communautés : suivre les relations explicites entre les pages relève d’un processus de recherche dans le graphe au périmètre plus restreint.
RAG par graphe et RAG vectoriel : comparaison pratique
La colonne consacrée au graphe ci-dessous inclut l’approche de Microsoft, qui combine extraction et synthèse. Un flux de travail fondé sur des liens existants peut se passer de leur extraction : sa mise en place n’est donc pas identique.
| Dimension | RAG vectoriel | RAG fondé sur un graphe |
|---|---|---|
| Modèle de données | Fragments de texte représentés par des plongements vectoriels. | Entités ou pages reliées entre elles par des relations ; Microsoft GraphRAG crée aussi des résumés de communautés. |
| Travail et coût d’indexation | Préparer les fragments et générer les plongements vectoriels. | Préparer la structure du graphe ; prévoir un budget pour l’extraction par LLM et les résumés si le pipeline y a recours. |
| Questions à tester en priorité | Questions auxquelles un passage pertinent ou un petit ensemble de passages permet de répondre. | Questions portant sur des faits reliés entre eux ; synthèse de l’ensemble des données lorsque des résumés de communautés sont disponibles. |
| Explicabilité | Examiner les passages récupérés et leurs sources. | Examiner les sources récupérées et les chemins de relations ; même visible, un chemin doit être étayé par des preuves. |
| Actualisation et maintenance | Prévoir comment les modifications du texte seront répercutées dans les fragments et les plongements vectoriels. | Prévoir aussi comment les modifications affecteront les relations et les éventuels résumés générés. |
| Outils ou composants courants | Un modèle de plongement vectoriel, un index vectoriel, un système de stockage des sources et un LLM chargé de répondre. | Une représentation sous forme de graphe et une logique de récupération ; Microsoft GraphRAG est une implémentation open source à évaluer. |
| Défaillance à surveiller | Des résultats qui semblent pertinents, mais omettent un fait nécessaire. | Des relations manquantes ou trompeuses, ou des résumés qui omettent des détails nécessaires. |
Ma règle de départ : si les éléments probants tiennent dans un passage, testez d’abord la récupération de passages. S’ils forment une chaîne, testez la récupération de cette chaîne. Si la question porte sur la collection, testez une approche à l’échelle de la collection.
Quand utiliser chacun des deux — et quand les combiner
Commencez par le RAG vectoriel pour des réponses sous forme de passages de texte
Les politiques, les instructions et les explications constituent des cas d’usage utiles pour commencer lorsque la réponse attendue se trouve dans un texte identifiable. Établissez un point de référence avant d’introduire une autre représentation de la même collection.
Demandez-vous si l’échec provient de la recherche d’informations ou de la réponse apportée. Si les éléments probants pertinents étaient déjà présents, l’ajout d’un graphe ne résoudra pas nécessairement le véritable problème.
Testez la recherche dans le graphe pour obtenir des réponses structurées autour des relations
Posez des questions dont la réponse dépend réellement des connexions : quels projets dépendent d’un service, quelles décisions sont liées à une exigence ou quelles notes de recherche étayent un argument. Il s’agit de cas d’évaluation proposés, et non de promesses d’une meilleure précision.
Vérifiez si vos données contiennent ces relations. Un graphe ne peut pas suivre une arête utile que ni la structure de vos données sources ni votre processus d’extraction ne fournissent.
Essayez une méthode de travail hybride avant de tout remplacer
Une approche concrète à tester combine des points d’entrée sémantiques et l’expansion du graphe :
- Recherchez du texte ou des nœuds pertinents pour la question.
- Suivez les relations sélectionnées à partir de ces points de départ.
- Récupérez le contenu source des éléments connectés.
- Fournissez au modèle chargé de répondre les éléments probants et les références de leurs sources.
Dans l’exemple de l’incident, la recherche pourrait retrouver le rapport d’incident. Le parcours du graphe pourrait ensuite suivre les liens vers le service touché et le lancement qui en dépend. La lecture de ces pages fournit les éléments concrets sur lesquels s’appuie la réponse.
Définissez les limites avant de tester : quels types de relations sont utiles, jusqu’où parcourir le graphe et quelle quantité de contenu renvoyer ? « Inclure tout ce qui est connecté » n’est pas une stratégie de recherche ; c’est une façon d’éviter de faire une sélection.
Le coût de GraphRAG en pratique
Il n’existe aucun tarif universel — ni multiplicateur de coût fixe — que l’on puisse justifier sans connaître le corpus, le modèle choisi et la configuration. Pour établir votre budget, la question utile est la suivante : quelles tâches ce pipeline ajoute-t-il ?
Pour l’approche de Microsoft fondée sur l’extraction et la génération de résumés, prenez en compte le travail du modèle nécessaire pour extraire les entités et les relations et générer des résumés des communautés. Ces étapes de préparation s’ajoutent à celles d’un pipeline de base qui découpe le contenu en segments et génère leurs représentations vectorielles. Ne considérez pas le caractère « open source » comme un budget permettant de financer ce travail.
Pour un projet pilote, consignez les coûts séparément :
- Préparation initiale : vectorisation, extraction et génération de résumés, partout où la conception de votre système y fait appel.
- Questions : travail de recherche d’informations, contexte fourni au LLM et génération de réponses.
- Mises à jour : travail nécessaire pour répercuter les modifications des sources dans les représentations que vous gérez.
- Exploitation : stockage, débogage et vérification des relations incorrectes ou manquantes.
Les mises à jour méritent un test à part entière. Modifiez une affirmation dans le contenu source, relancez le processus de mise à jour que vous avez choisi et examinez la réponse obtenue. Vérifiez le contenu d’origine, sa représentation dans le graphe et tout résumé qui s’appuyait sur l’ancienne affirmation. Ne présumez pas qu’une première indexation réussie prouve que la collection reste à jour.
Si vos arêtes existent déjà sous forme de liens explicites, vous pouvez éviter de les extraire à l’aide d’un LLM. Cela ne supprime ni la récupération de contenu, ni la génération de réponses, ni la maintenance. Vous éliminez une étape précise, mais pas tous les coûts associés au RAG fondé sur un graphe.
Vos notes contiennent déjà une structure de graphe
Un espace de travail dont les contenus sont reliés offre un point de départ différent d’un dossier de documents isolés. Notion contient déjà des arêtes explicites grâce aux propriétés Relation des bases de données, aux mentions de pages et aux rétroliens, ainsi qu’aux relations entre pages parentes et enfants. Les coffres Obsidian contiennent des liens wiki. Ces liens peuvent devenir les arêtes d’un graphe sans demander à un grand modèle de langage de les découvrir.
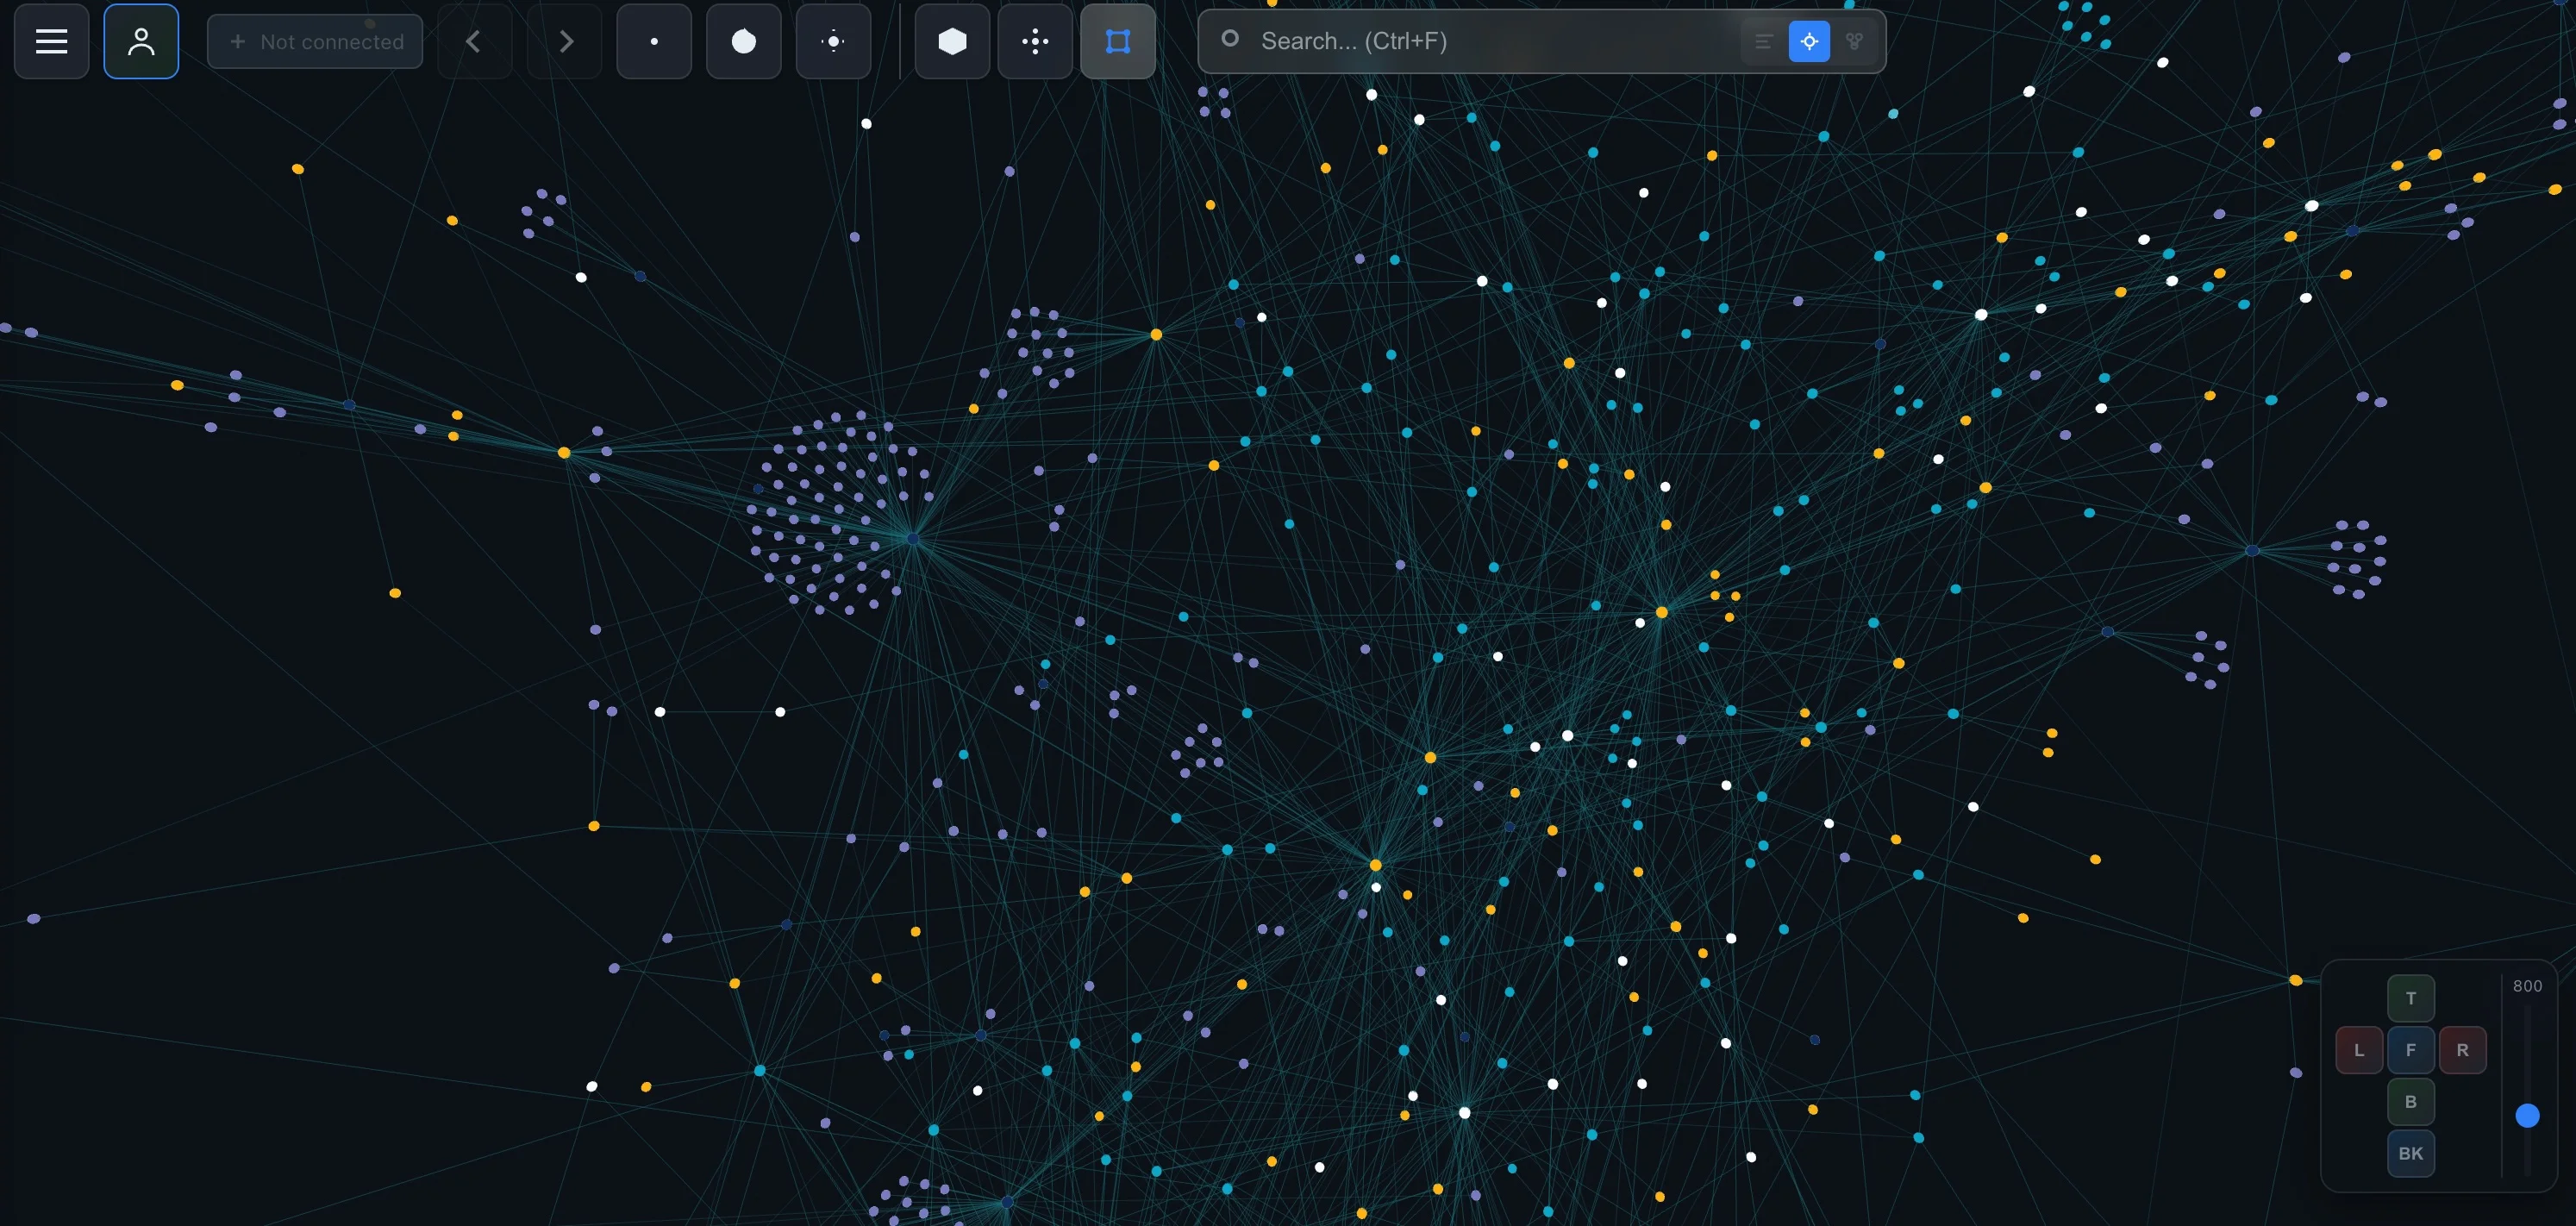
Supposons que votre base de données fictive Projets soit liée à une base de données Services, tandis que vos notes d’incident mentionnent des pages de service. Vous disposez déjà d’un chemin qui mène d’une note d’incident à un service, puis aux projets associés. Notre guide des relations entre bases de données Notion traite des liens explicites ; le guide du graphe de connaissances Notion, plus général, replace ces liens dans leur contexte.
Une réserve à souligner en toute transparence : un graphe de pages n’est pas automatiquement un graphe de connaissances d’entités. Une page peut traiter de plusieurs entités. Une mention indique qu’une page fait référence à une autre, pas nécessairement qu’un service dépend d’un autre. Un lien parent-enfant exprime une hiérarchie, pas une relation de propriété ou de causalité.
Conservez cette distinction lors de la recherche d’informations. Suivez une mention pour trouver des éléments probants potentiellement utiles, puis lisez la page avant de vous prononcer sur la signification de la relation.
Cette approche s’articule naturellement avec un wiki LLM : considérez séparément les pages sources, les liens entre elles et l’interprétation générée. En gardant ces niveaux distincts, vous pouvez plus facilement examiner une réponse plutôt que de considérer chaque relation générée comme un fait établi.
Donnez aux agents accès à la structure et au contenu
IVGraph crée un graphe à partir des pages Notion, des rétroliens et des mentions, ainsi que des propriétés Relation des bases de données. Son API LLM V1 en lecture seule permet aux agents d’effectuer des recherches, d’accéder aux détails des nœuds et au contenu des pages, et de parcourir le graphe. Ensemble, le graphe et l’API suffisent à mettre en place un processus de recherche d’informations qui tient compte du graphe, à partir d’un espace de travail que vous gérez déjà.
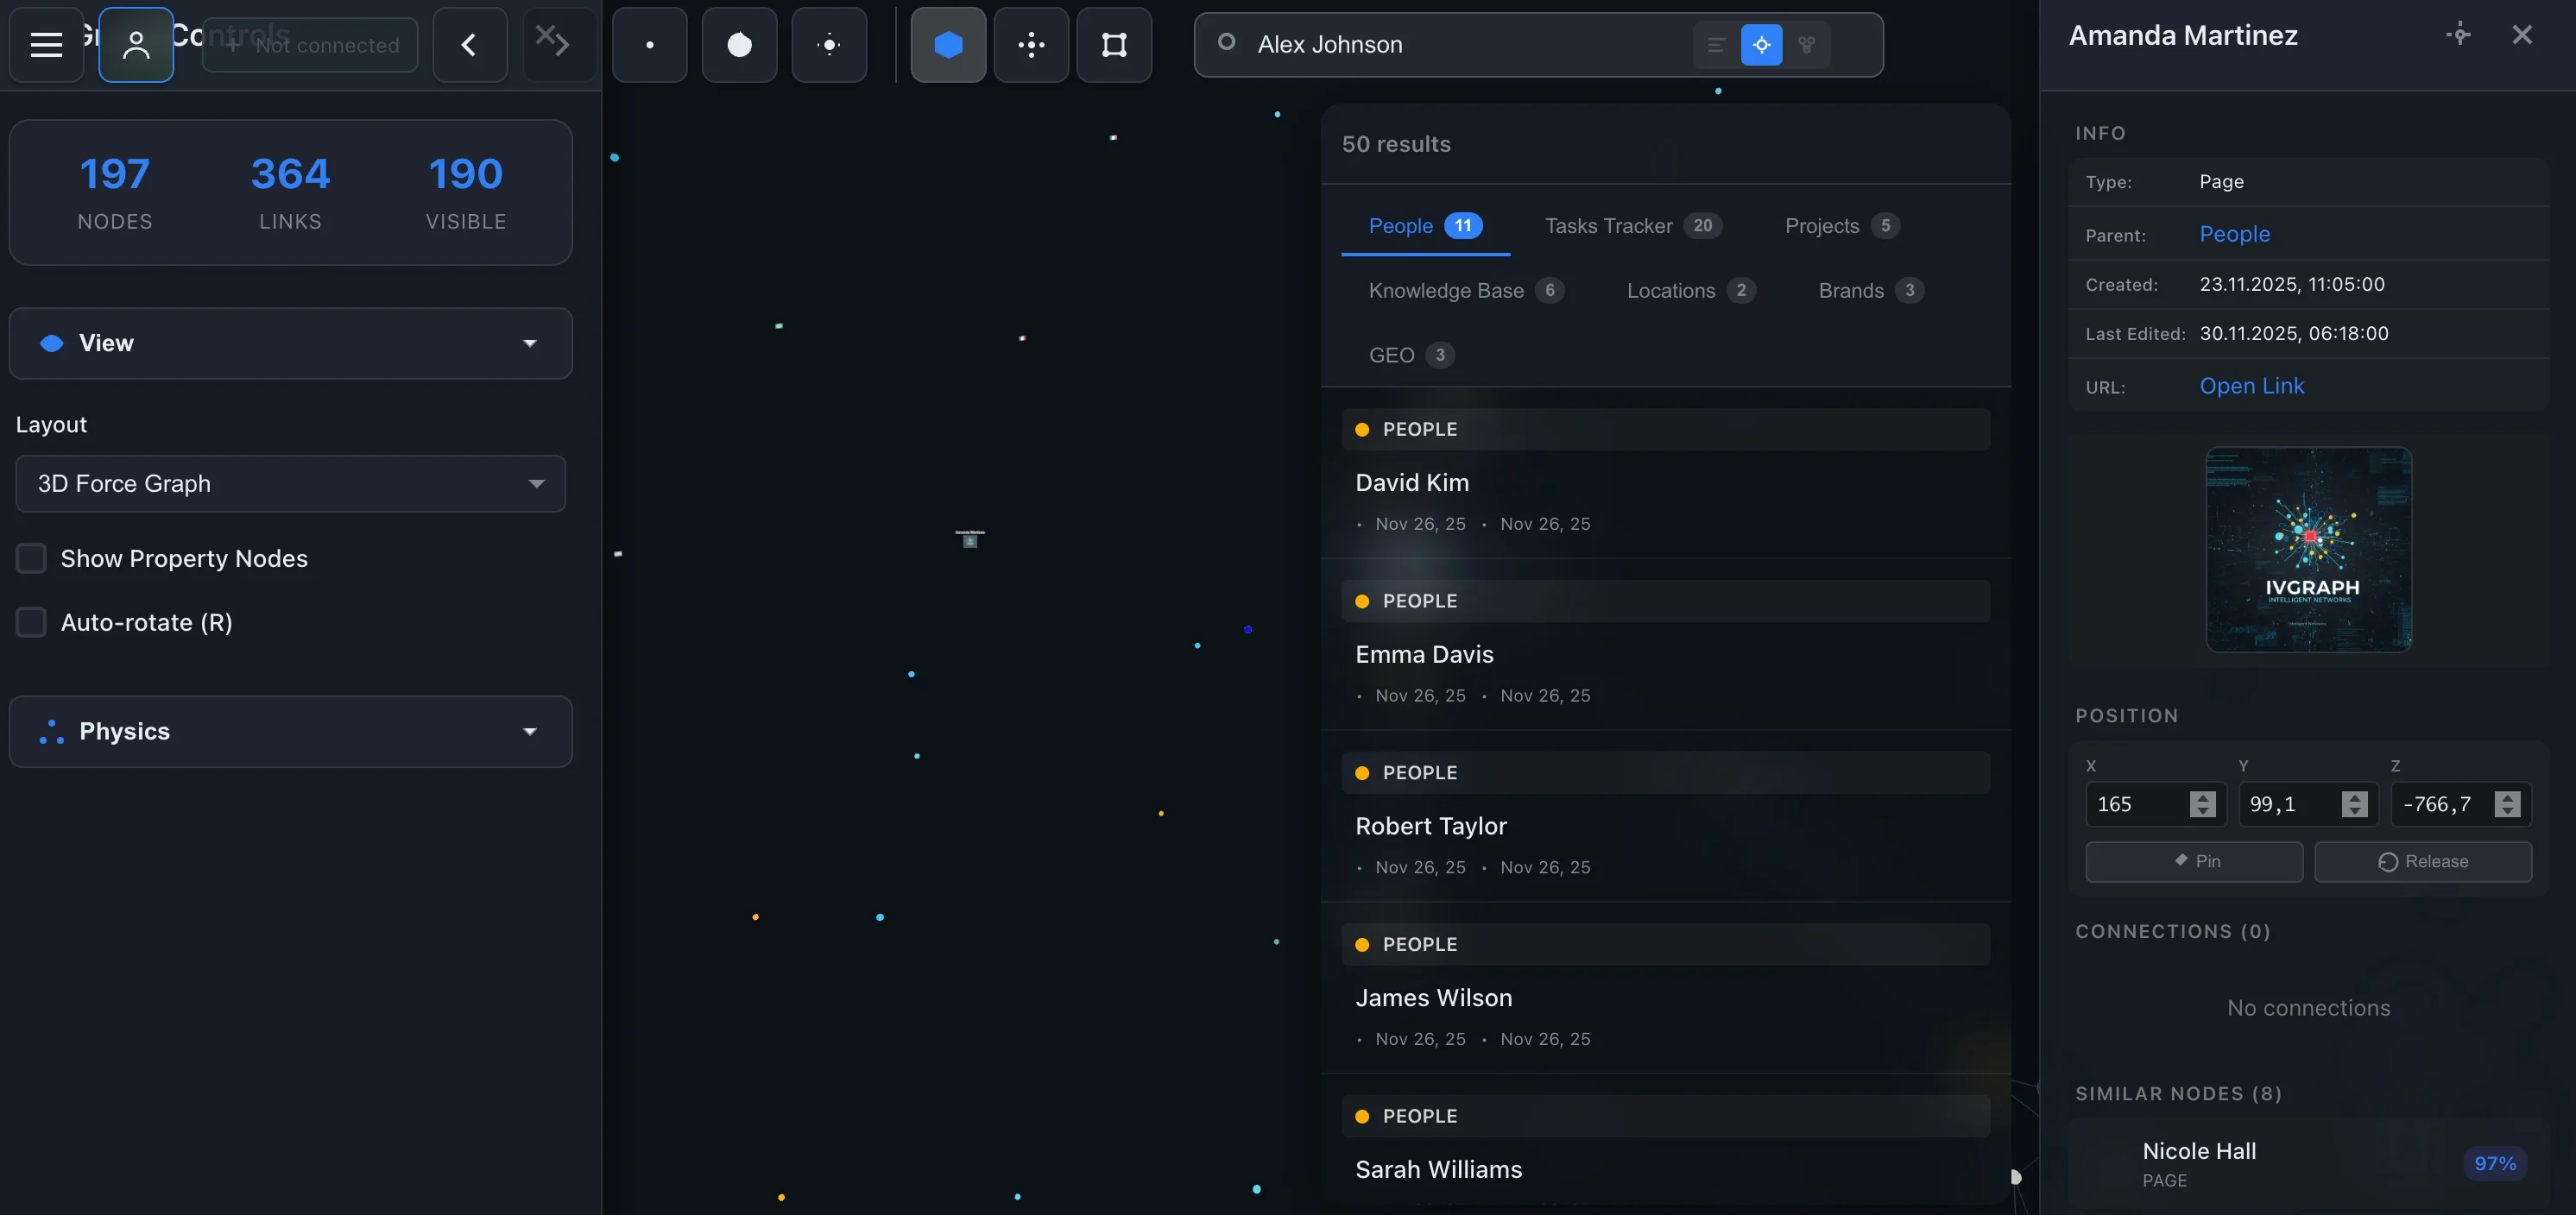
Le processus à tester avec un agent est simple : rechercher le projet, examiner son nœud, suivre les liens pertinents, récupérer le contenu des pages connectées, puis répondre en s’appuyant sur ces éléments. Pour un processus de travail personnel plus global, découvrez comment créer un second cerveau avec un LLM, Notion et Claude Code.
Ne commencez pas par extraire les relations que vous gérez déjà explicitement. Vérifiez d’abord si le fait de rendre ces relations visibles résout le problème de manque de contexte.
Comment commencer à petite échelle
Commencez par des questions, pas par une migration de base de données. Utilisez cette liste de contrôle pour garder l’expérimentation centrée sur les cas concrets où vous ne retrouvez pas l’information recherchée :
- Choisissez une collection bien délimitée. Choisissez un périmètre de projet dont vous pouvez examiner vous-même le contenu et les relations.
- Formulez des questions concrètes. Incluez des recherches directes, des questions portant sur des faits liés entre eux et des questions portant sur l’ensemble de la collection si elles sont pertinentes pour votre travail.
- Identifiez les éléments de preuve nécessaires. Notez les passages et les relations sur lesquels une réponse correcte doit s’appuyer.
- Effectuez un test de référence avec la recherche vectorielle. Enregistrez le contexte récupéré ainsi que la réponse générée. Identifiez les éléments de preuve manquants avant de modifier l’architecture.
- Recensez les arêtes existantes. Distinguez les relations utiles des mentions fortuites et des liens hiérarchiques.
- Ajoutez uniquement la capacité manquante. Testez le parcours du graphe pour les faits liés entre eux, ou le pipeline d’extraction et de synthèse de Microsoft pour les questions auxquelles il est conçu pour répondre.
- Comparez et mettez à jour. Examinez la couverture des éléments de preuve, les affirmations non étayées, le coût et le temps de réponse. Modifiez ensuite une source et vérifiez que les résultats sont à jour.
Conservez la couche de graphe si elle retrouve des éléments de contexte nécessaires que l’approche de référence laisse de côté, à un coût que vous pouvez assumer. Si les deux approches répondent aussi bien, privilégiez celle que vous pouvez maintenir le plus facilement.
FAQ
Qu’est-ce que le GraphRAG, en termes simples ?
Le GraphRAG est une méthode de génération augmentée par récupération qui utilise un graphe de connaissances composé d’entités et de relations pour trouver du contexte pour un grand modèle de langage (LLM). Au lieu de se limiter à trouver des passages similaires, cette méthode peut retrouver des informations en suivant les liens entre les éléments.
GraphRAG est-il meilleur que le RAG vectoriel ?
Pas pour toutes les questions. Le RAG vectoriel est un point de départ judicieux pour trouver des passages pertinents. La recherche par graphe mérite d’être testée lorsque les réponses nécessitent des faits liés entre eux, tandis que l’approche de Microsoft fondée sur des résumés de communautés permet aussi de traiter des questions portant sur l’ensemble du jeu de données. Comparez ces approches à partir de vos propres questions et sources.
Microsoft GraphRAG est-il équivalent à toutes les approches RAG fondées sur les graphes ?
Non. Microsoft GraphRAG est une implémentation open source qui extrait des entités et des relations, les regroupe en communautés, produit des résumés et propose une recherche locale et globale. La recherche d’informations fondée sur les graphes peut aussi exploiter des relations existantes sans passer par tout ce processus d’extraction et de synthèse.
Combien coûte GraphRAG ?
Impossible de donner un prix unique pertinent sans connaître le corpus, le modèle choisi et la configuration du pipeline. Prévoyez un budget pour l’extraction et la génération de résumés lorsqu’elles sont utilisées, la recherche d’informations et la génération de réponses, le stockage et les mises à jour. Évaluez les coûts sur un petit échantillon représentatif plutôt que de supposer un coefficient multiplicateur fixe par rapport au RAG vectoriel.
Puis-je utiliser les liens Notion pour GraphRAG ?
Oui. Les propriétés Relation des bases de données, les mentions et les rétroliens, ainsi que les liens entre pages parentes et pages enfants peuvent fournir des arêtes explicites pour le graphe sans extraction par un LLM. Vous avez toutefois besoin d’un processus de recherche qui sélectionne les pages pertinentes, lit leur contenu et fournit des éléments probants au modèle chargé de répondre. Un lien vers une page ne suffit pas à expliquer la relation.