 IVGraph
L’origine de l’idée
Le 4 avril 2026, Andrej Karpathy — cofondateur d’OpenAI et ancien responsable de l’IA chez Tesla — a publié un court gist intitulé llm-wiki.md. Ce n’est ni un outil ni un dépôt : c’est un fichier qui expose une idée, à transmettre à votre propre agent LLM (Claude Code, Codex et autres), lequel élabore ensuite avec vous une implémentation concrète. En quelques mois, il avait récolté plus de 5,000 étoiles, suscité des implémentations communautaires et fait de « wiki LLM » un terme activement recherché.
Le gist résume lui-même l’idée en une phrase : « Obsidian est l’IDE ; le LLM est le programmeur ; le wiki est la base de code » — vous gardez la main sur le choix des sources et les questions à poser, tandis que le LLM se charge de toute la rédaction, du classement et des renvois croisés.
Wiki LLM vs RAG : compiler une fois ou rechercher sans fin
La plupart des produits qui associent IA et documents reposent sur le RAG (génération augmentée par la recherche) : vous importez des fichiers et, au moment de la question, le modèle récupère les passages pertinents et improvise une réponse. Cela fonctionne — mais chaque question repart de zéro. Rien ne s’accumule entre les requêtes.
Un wiki LLM inverse cette logique. Dès qu’une nouvelle source arrive, le LLM la lit immédiatement, en extrait l’essentiel et l’intègre à un réseau de pages existant : il met à jour les pages consacrées aux entités, révise les synthèses et signale les contradictions avec les contenus précédents. Les connaissances sont compilées une seule fois, puis tenues à jour — chaque réponse s’appuie donc sur une vue d’ensemble déjà synthétisée plutôt que sur des fragments bruts.
| RAG | Wiki LLM | |
|---|---|---|
| Moment de la synthèse | À chaque requête | À l’intégration, une seule fois |
| Entre les questions | Rien ne s’accumule | Les connaissances s’accumulent et s’enrichissent |
| Contradictions | Redécouvertes (ou non détectées) | Signalées à l’intégration d’une source |
| Bonnes réponses | Se perdent dans l’historique de discussion | Sont réintégrées au wiki sous forme de pages |
Les trois couches
L’architecture du gist est volontairement minimale :
- Les sources brutes — articles, publications scientifiques, transcriptions, fichiers de données. Immuables ; le LLM les lit, mais ne les modifie jamais.
- Le wiki — des pages générées par le LLM et reliées entre elles : synthèses, pages d’entités, pages de concepts, comparaisons. Le LLM gère entièrement cette couche ; vous la consultez.
- Le schéma — un fichier de conventions (CLAUDE.md, AGENTS.md) qui indique à l’agent comment le wiki est structuré et comment se comporter lors de l’intégration de sources, de la formulation de réponses et de la maintenance. C’est ce qui transforme un chatbot généraliste en bibliothécaire rigoureux.
Au quotidien, le wiki repose sur trois opérations : l’intégration (vous déposez une source, le LLM l’intègre — un seul article peut affecter 10–15 pages), l’interrogation (vous posez des questions ; les bonnes réponses sont réintégrées sous forme de nouvelles pages) et la vérification (un contrôle périodique qui repère les contradictions, les affirmations obsolètes et les pages orphelines sans liens entrants).
Wiki LLM vs second cerveau vs base de connaissances
Ces termes se recoupent, et les résultats de recherche les confondent constamment. Pour les distinguer clairement :
| Terme | Définition | Qui l’entretient |
|---|---|---|
| Base de connaissances | Tout ensemble organisé d’informations | Quiconque s’en donne la peine |
| Second cerveau | Une pratique personnelle pour consigner et organiser ce que vous apprenez | Vous |
| Wiki LLM | Une base de connaissances que le LLM compile et tient à jour | Le LLM |
Tout se joue dans cette dernière colonne. Les gens abandonnent leurs wikis et leurs seconds cerveaux parce que le travail de gestion — actualiser les renvois croisés, concilier les anciennes affirmations avec les nouvelles sources — augmente plus vite que la valeur apportée. Le LLM ne se lasse pas : voilà pourquoi cette approche perdure là où les systèmes manuels dépérissent en silence.
Comment en créer un
Trois approches concrètes, selon l’endroit où se trouvent déjà vos connaissances :
- Fichiers Markdown + Obsidian — la configuration originale de Karpathy. Un dossier de sources, un dossier de pages wiki, un CLAUDE.md contenant les conventions et un agent dans le terminal. L’outil de capture d’Obsidian permet d’importer les articles ; sa vue graphe révèle la structure de l’ensemble à mesure qu’il grandit.
- Notion + MCP — si vos notes et vos bases de données sont déjà dans Notion, vous n’avez rien à migrer : connectez un agent via le serveur MCP de Notion et laissez-le lire et écrire directement dans les pages. Nous avons documenté toute la démarche dans Wiki LLM pour Notion : second cerveau avec Claude + graphe de connaissances 3D.
- Wiki d’équipe — le même cycle, alimenté par des transcriptions de réunions, des documents et des fils de discussion, avec une relecture des mises à jour par des humains. Le wiki reste à jour parce que le LLM assure la maintenance dont personne dans l’équipe ne veut se charger.
La place du graphe de connaissances
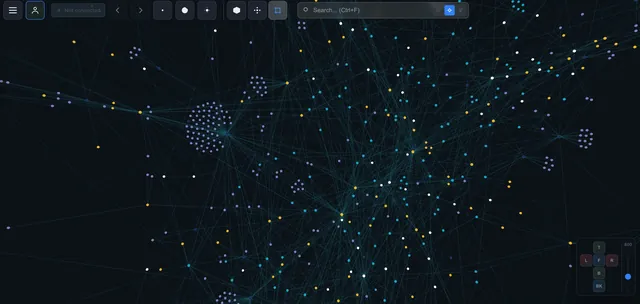
Un wiki, c’est du texte ; sa structure, c’est un graphe — les pages sont des nœuds, les liens sont des arêtes. Le gist de Karpathy recommande lui-même la vue graphe comme le meilleur moyen de visualiser la structure d’un wiki en pleine croissance : quelles pages sont devenues des pôles, lesquelles sont orphelines, où se forment les groupes. L’opération de vérification est littéralement un bilan de santé du graphe.
C’est encore plus important lorsque votre wiki LLM est dans Notion, car Notion ne propose pas de vue graphe intégrée. IVGraph comble ce manque : il représente votre espace de travail — chaque page, chaque rétrolien et chaque Relation de base de données — sous forme de graphe de connaissances 3D interactif, pour que vous puissiez voir le wiki construit par votre LLM prendre réellement forme. Les agents peuvent aussi interroger cette même structure par programmation via l’API LLM d’IVGraph.
FAQ
Qu’est-ce qu’un wiki LLM, en termes simples ?
Une base de connaissances que votre IA construit et entretient pour vous. Vous lui fournissez des sources et des questions ; elle rédige les pages, les relie entre elles et les met à jour. Compilée une fois, tenue à jour — tout l’inverse d’une nouvelle recherche dans les fichiers bruts à chaque requête.
Où trouver le wiki LLM de Karpathy sur GitHub ?
C’est un gist, pas un dépôt : llm-wiki.md, publié le 4 avril 2026. Il n’y a volontairement rien à installer — vous collez l’idée dans votre propre agent et construisez votre version ensemble.
Wiki LLM ou second cerveau : lequel vous faut-il ?
Ils ne sont pas concurrents : le second cerveau est la pratique, le wiki LLM est ce qu’elle devient lorsque le LLM prend en charge la maintenance. Si vous prenez déjà des notes, l’étape suivante consiste à ajouter un agent qui les entretient — le tableau ci-dessus détaille la répartition des rôles.
Faut-il utiliser Obsidian ?
Non — tout espace de stockage dans lequel le LLM peut lire et écrire convient. Des fichiers Markdown locaux sont l’option la plus légère ; Notion via MCP est le choix naturel si vos connaissances s’y trouvent déjà (avec, en plus, les bases de données et la collaboration).