 IVGraph
Woher die Idee stammt
Am 4. April 2026 veröffentlichte Andrej Karpathy — Mitgründer von OpenAI und ehemaliger KI-Leiter bei Tesla — einen kurzen Gist namens llm-wiki.md. Das ist weder ein Tool noch ein Repository, sondern eine Datei mit einer Idee, die dafür gedacht ist, deinem eigenen LLM-Agenten (Claude Code, Codex und ähnlichen) übergeben zu werden. Der erarbeitet dann gemeinsam mit dir eine konkrete Umsetzung. Innerhalb weniger Monate sammelte der Gist mehr als 5,000 Sterne, brachte Umsetzungen aus der Community hervor und machte „LLM-Wiki“ zu einem Begriff, nach dem gezielt gesucht wird.
Die Idee in einem Satz, direkt aus dem Gist: „Obsidian ist die IDE; das LLM ist der Programmierer; das Wiki ist die Codebasis“ — du entscheidest weiterhin, welche Quellen du auswählst und welche Fragen du stellst. Das LLM übernimmt das gesamte Schreiben, Ablegen und Erstellen von Querverweisen.
LLM-Wiki vs. RAG: einmal kompilieren oder immer wieder abrufen
Die meisten Produkte, die KI mit Dokumenten verbinden, arbeiten mit RAG (abrufgestützter Generierung): Du lädst Dateien hoch, und bei jeder Frage ruft das Modell relevante Textabschnitte ab und improvisiert eine Antwort. Das funktioniert — aber jede Frage beginnt bei null. Zwischen den Anfragen baut sich nichts auf.
Ein LLM-Wiki kehrt dieses Prinzip um. Sobald eine neue Quelle hinzukommt, liest das LLM sie sofort, extrahiert das Wesentliche und integriert es in ein bestehendes Netz aus Seiten: Es aktualisiert Seiten zu Entitäten, überarbeitet Zusammenfassungen und kennzeichnet Widersprüche zu früherem Material. Das Wissen wird einmal kompiliert und anschließend aktuell gehalten — so basiert jede Antwort auf einem bereits zusammengeführten Gesamtbild statt auf unbearbeiteten Fragmenten.
| RAG | LLM-Wiki | |
|---|---|---|
| Wann Wissen zusammengeführt wird | Bei jeder Anfrage aufs Neue | Beim Einlesen, einmalig |
| Zwischen den Fragen | Es baut sich nichts auf | Das Wissen wächst weiter |
| Widersprüche | Werden erneut entdeckt (oder übersehen) | Werden beim Einlesen einer Quelle markiert |
| Gute Antworten | Verschwinden im Chatverlauf | Werden als Seiten ins Wiki zurückgeschrieben |
Die drei Ebenen
Die Architektur im Gist ist bewusst minimal gehalten:
- Originalquellen — Artikel, wissenschaftliche Arbeiten, Transkripte, Datendateien. Unveränderlich; das LLM liest sie, bearbeitet sie aber nie.
- Das Wiki — vom LLM erzeugte, miteinander verknüpfte Seiten: Zusammenfassungen, Seiten zu Entitäten und Konzepten, Vergleiche. Diese Ebene verwaltet das LLM vollständig; du liest sie.
- Das Schema — eine Datei mit Konventionen (CLAUDE.md, AGENTS.md), die dem Agenten erklärt, wie das Wiki aufgebaut ist und wie er beim Einlesen, Antworten und Pflegen vorgehen soll. So wird aus einem allgemeinen Chatbot ein gewissenhafter Bibliothekar.
Im Alltag basiert das Wiki auf drei Vorgängen: Einlesen (du fügst eine Quelle hinzu, das LLM integriert sie — ein einzelner Artikel kann 10–15 Seiten betreffen), Abfragen (du stellst Fragen; gute Antworten werden als neue Seiten zurückgeschrieben) und Prüfen (eine regelmäßige Zustandsprüfung auf Widersprüche, veraltete Aussagen und verwaiste Seiten ohne eingehende Links).
LLM-Wiki vs. Second Brain vs. Wissensdatenbank
Die Begriffe überschneiden sich und werden in Suchergebnissen ständig durcheinandergebracht. So lassen sie sich klar voneinander abgrenzen:
| Begriff | Was es ist | Wer es pflegt |
|---|---|---|
| Wissensdatenbank | Jede geordnete Sammlung von Informationen | Wer sich die Mühe macht |
| Second Brain | Eine persönliche Praxis, Gelerntes festzuhalten und zu ordnen | Du |
| LLM-Wiki | Eine Wissensdatenbank, die das LLM kompiliert und aktuell hält | Das LLM |
Auf die letzte Spalte kommt es an. Menschen geben Wikis und Second Brains auf, weil der Verwaltungsaufwand — Querverweise aktualisieren, alte Aussagen mit neuen Quellen abgleichen — schneller wächst als der Nutzen. Das LLM langweilt sich nicht. Deshalb bleibt dieser Ansatz bestehen, während manuelle Systeme still und leise einschlafen.
So baust du ein LLM-Wiki auf
Drei praktische Wege, je nachdem, wo dein Wissen schon liegt:
- Markdown-Dateien + Obsidian — Karpathys ursprüngliches Setup. Ein Ordner mit Quellen, ein Ordner mit Wiki-Seiten, eine CLAUDE.md mit Konventionen und ein Agent im Terminal. Mit dem Clipper von Obsidian kommen Artikel hinein; die Graph-Ansicht zeigt die Struktur des wachsenden Wikis.
- Notion + MCP — wenn deine Notizen und Datenbanken bereits in Notion liegen, musst du nichts migrieren: Verbinde einen Agenten über den MCP-Server von Notion und lass ihn Seiten direkt lesen und schreiben. Den gesamten Ablauf haben wir in LLM-Wiki für Notion: Claude Second Brain + 3D-Wissensgraph dokumentiert.
- Team-Wiki — derselbe Kreislauf, gespeist aus Meeting-Transkripten, Dokumenten und Chatverläufen, wobei Menschen die Aktualisierungen prüfen. Das Wiki bleibt aktuell, weil das LLM die Pflege übernimmt, die niemand im Team erledigen möchte.
Welche Rolle der Wissensgraph spielt
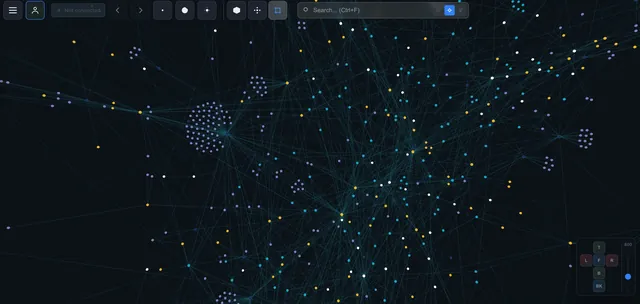
Ein Wiki besteht aus Text; seine Struktur ist ein Graph — Seiten sind Knoten, Links sind Kanten. Karpathys Gist selbst empfiehlt die Graph-Ansicht als beste Möglichkeit, die Struktur eines wachsenden Wikis zu erkennen: Welche Seiten sind zu zentralen Knoten geworden, welche sind verwaist, wo bilden sich Cluster? Der Prüfvorgang ist buchstäblich eine Zustandsprüfung für den Graphen.
Das ist noch wichtiger, wenn dein LLM-Wiki in Notion liegt, denn Notion hat keine integrierte Graph-Ansicht. IVGraph schließt diese Lücke: Es stellt deinen Workspace — jede Seite, jeden Backlink und jede Relation in einer Datenbank — als interaktiven 3D-Wissensgraphen dar. So kannst du beobachten, wie das Wiki, das dein LLM aufbaut, tatsächlich Gestalt annimmt. Agenten können dieselbe Struktur auch programmatisch über die IVGraph LLM API abfragen.
FAQ
Was ist ein LLM-Wiki, einfach erklärt?
Eine Wissensdatenbank, die deine KI für dich aufbaut und pflegt. Du lieferst ihr Quellen und Fragen; sie schreibt, verknüpft und aktualisiert die Seiten. Einmal kompiliert, laufend aktuell gehalten — das Gegenteil davon, bei jeder Anfrage die Originaldateien erneut zu durchsuchen.
Wo finde ich Karpathys LLM-Wiki auf GitHub?
Es ist ein Gist, kein Repository: llm-wiki.md, veröffentlicht am 4. April 2026. Dass es nichts zu installieren gibt, ist Absicht — du fügst die Idee in deinen eigenen Agenten ein und entwickelst gemeinsam mit ihm deine Version.
LLM-Wiki oder Second Brain — was brauche ich?
Die beiden sind keine Konkurrenten: Ein Second Brain ist die Praxis; ein LLM-Wiki ist das, was daraus wird, wenn das LLM die Pflege übernimmt. Wenn du bereits Notizen führst, ist ein Agent, der sie pflegt, der nächste Schritt — wie sich die Rollen verteilen, siehst du in der Tabelle oben.
Brauche ich dafür Obsidian?
Nein — jeder Speicher, den das LLM lesen und beschreiben kann, funktioniert. Lokale Markdown-Dateien sind die schlankste Option; Notion über MCP liegt nahe, wenn dein Wissen bereits dort liegt (und bietet dir zusätzlich Datenbanken und Zusammenarbeit).