 IVGraph
GraphRAG é uma técnica de geração aumentada por recuperação que usa um grafo de conhecimento de entidades e relações para encontrar contexto para um LLM. Vale a pena testar essa abordagem quando uma resposta depende de fatos interligados ou de padrões em uma coleção — não como escolha automática quando você só precisa do parágrafo certo. O RAG vetorial continua sendo um ponto de partida sensato, e combinar as duas abordagens costuma ser a arquitetura mais útil a explorar.
A resposta curta: a similaridade encontra trechos; os grafos conectam fatos
A busca vetorial pergunta: Quais trechos têm um significado semelhante ao desta pergunta? A busca em grafo acrescenta outra pergunta: O que está conectado àquilo de que trata esta pergunta?
Imagine um espaço de trabalho de um projeto. Um único guia operacional pode responder à pergunta “Como fazemos a implantação do serviço?”. Já “Qual lançamento depende do serviço sob responsabilidade da equipe que está cuidando deste incidente?” exige seguir as conexões entre um incidente, uma equipe, um serviço e um lançamento.
Essa é a diferença prática entre RAG baseado em grafos e RAG vetorial. Não se trata de “recuperação inteligente versus recuperação burra”. Trata-se de escolher qual estrutura ajuda você a reunir as evidências necessárias.
RAG em um parágrafo — e onde a busca vetorial deixa a desejar
A geração aumentada por recuperação busca informações relevantes e as fornece como contexto a um LLM antes que o modelo responda. O RAG vetorial clássico divide documentos em trechos, codifica esses trechos como representações numéricas e os recupera pela similaridade vetorial com a pergunta. O modelo que gera a resposta então trabalha a partir do texto selecionado. A comparação da Meilisearch descreve a distinção fundamental: recuperação baseada em similaridade versus recuperação por meio de entidades conectadas.
Para uma pergunta como “O que nossa política de reembolso diz sobre cancelamentos?”, encontrar o trecho relevante da política pode ser suficiente. Você não precisa modelar cada cliente, política e produto como um nó para testar esse fluxo de trabalho.
As limitações ficam mais interessantes quando o contexto necessário está distribuído:
- Perguntas de múltiplas etapas: a resposta exige percorrer várias relações, não localizar um único trecho correspondente.
- Perguntas globais: “Quais temas se repetem nas retrospectivas dos nossos projetos?” é uma pergunta sobre o conjunto, não apenas sobre as correspondências mais próximas.
- Fatos dispersos: páginas separadas contêm partes diferentes da resposta, e algumas dessas partes podem não se parecer com a pergunta original.
No exemplo do incidente, uma página de lançamento pode nunca mencionar o incidente. Recuperar trechos com formulações semelhantes à da pergunta não é a mesma operação que seguir uma dependência documentada até esse lançamento.
Isso não significa que a busca vetorial não possa fornecer a resposta. Significa que você deve testar se ela recupera todas as informações necessárias, em vez de avaliá-la pela aparente relevância do primeiro resultado.
Como o Microsoft GraphRAG funciona, passo a passo
Microsoft GraphRAG é um sistema RAG de código aberto baseado em grafos. Seu fluxo de extração, identificação de comunidades e geração de resumos é uma referência útil para entender essa abordagem. Divida o trabalho em duas etapas: preparar a coleção e responder a perguntas com base nela.
Indexação: transforme texto em contexto conectado
- Extrair entidades. Um LLM identifica os elementos abordados no material de origem. Em uma coleção hipotética de engenharia, esses elementos podem incluir serviços, equipes, projetos e incidentes.
- Extrair relações. O LLM identifica conexões entre essas entidades. Por exemplo, um documento pode dizer que uma determinada equipe é responsável por um serviço.
- Construir o grafo. As entidades se tornam nós e as relações se tornam links, oferecendo uma representação conectada do material para a recuperação de informações.
- Agrupar entidades em comunidades. O sistema organiza o grafo em grupos conectados, em vez de tratar cada entidade isoladamente.
- Escrever resumos das comunidades. Os resumos gerados oferecem uma visão geral desses grupos para a posterior recuperação de informações e elaboração de respostas.
A mudança importante é que o sistema prepara mais do que trechos que podem ser pesquisados. Ele também prepara uma representação dos assuntos abordados nesses trechos, de como esses assuntos se conectam e do que os grupos conectados contêm.
Consultas: perguntas locais versus perguntas globais
A busca local é centrada em entidades. Pense: “O que está conectado ao serviço de cobrança?” O contexto relevante é organizado em torno de uma entidade específica e de suas relações.
A busca global abrange todo o conjunto de dados. Pense: “Quais problemas recorrentes de coordenação aparecem nesses projetos?” Os resumos das comunidades fornecem material para uma síntese mais ampla, em vez de depender apenas de trechos semelhantes à pergunta.
A documentação do GraphRAG da Microsoft separa indexação, métodos de consulta e ajuste de prompts. Para uma avaliação inicial, a distinção útil é simples: você está investigando algo específico ou pedindo uma visão geral da coleção?
Não confunda “local” com “roda no meu notebook”. Aqui, o termo descreve o escopo da busca. E não presuma que toda consulta ao grafo precisa de resumos de comunidades: seguir relações explícitas entre páginas é um fluxo de recuperação de informações no grafo com escopo mais restrito.
RAG com grafos vs. RAG vetorial: comparação prática
A coluna sobre grafos abaixo inclui a abordagem de extração e resumo da Microsoft. Um fluxo de trabalho criado a partir de links existentes pode dispensar a extração desses links, portanto sua configuração não é idêntica.
| Dimensão | RAG vetorial | RAG baseado em grafos |
|---|---|---|
| Modelo de dados | Trechos de texto representados por embeddings. | Entidades ou páginas conectadas por relacionamentos; o Microsoft GraphRAG também cria resumos de comunidades. |
| Trabalho e custo de indexação | Preparar trechos e gerar embeddings. | Preparar a estrutura do grafo; prever os custos de extração e geração de resumos por LLM se o pipeline utilizar esses recursos. |
| Perguntas para testar primeiro | Perguntas que podem ser respondidas com um trecho relevante ou um pequeno conjunto de trechos. | Perguntas que envolvem fatos conectados; síntese de todo o conjunto de dados quando há resumos de comunidades disponíveis. |
| Explicabilidade | Examinar os trechos recuperados e suas fontes. | Examinar as fontes recuperadas e os caminhos de relacionamentos; um caminho visível ainda precisa de evidências que o sustentem. |
| Atualização e manutenção | Planejar como as alterações no texto serão refletidas nos trechos e nos embeddings. | Planejar também como as alterações afetam os relacionamentos e quaisquer resumos gerados. |
| Ferramentas ou componentes típicos | Um modelo de embeddings, um índice vetorial, um repositório de fontes e um LLM para gerar respostas. | Uma representação em grafo e uma lógica de recuperação; o Microsoft GraphRAG é uma implementação de código aberto a ser avaliada. |
| Falhas às quais ficar atento | Resultados que parecem relevantes, mas omitem um fato necessário. | Relacionamentos ausentes ou enganosos, ou resumos que omitem detalhes necessários. |
Minha regra inicial: se as evidências cabem em um trecho, teste primeiro a recuperação de trechos. Se as evidências formam uma cadeia, teste a recuperação dessa cadeia. Se a pergunta diz respeito à coleção, teste uma abordagem no nível da coleção.
Quando usar cada um — e quando combiná-los
Comece com RAG vetorial para respostas na forma de trechos de texto
Políticas, instruções e explicações são pontos de partida úteis quando a resposta esperada está em um texto identificável. Estabeleça uma referência inicial antes de introduzir outra representação da mesma coleção.
Pergunte-se se a falha ocorreu na recuperação das informações ou na geração da resposta. Se as evidências corretas já estavam presentes, adicionar um grafo pode não resolver o problema real.
Teste a busca no grafo para obter respostas estruturadas por relações
Use perguntas que realmente dependam de conexões: quais projetos dependem de um serviço, quais decisões estão ligadas a um requisito ou quais notas de pesquisa sustentam um argumento. Esses são casos propostos para avaliação, não promessas de maior precisão.
Verifique se seus dados contêm essas relações. Um grafo não consegue seguir uma aresta útil que não esteja presente na estrutura de origem nem seja fornecida pelo processo de extração.
Experimente um fluxo de trabalho híbrido antes de substituir tudo
Uma abordagem prática a ser testada combina pontos de entrada semânticos com a expansão do grafo:
- Busque textos ou nós relevantes para a pergunta.
- Siga as relações selecionadas a partir desses pontos de partida.
- Obtenha o conteúdo de origem dos itens conectados.
- Forneça ao modelo que responderá à pergunta as evidências e as referências às fontes.
No exemplo do incidente, a busca poderia encontrar o relatório do incidente. A navegação pelo grafo poderia então seguir os links até o serviço afetado e o lançamento que depende dele. A leitura dessas páginas fornece as evidências concretas para a resposta.
Defina os limites antes de testar: quais tipos de relacionamento são úteis, até onde a navegação pelas conexões deve ir e quanto conteúdo deve ser retornado? “Incluir tudo que está conectado” não é uma estratégia de recuperação de informações; é uma forma de evitar fazer uma seleção.
Quanto custa o GraphRAG na prática
Não há como justificar um preço universal — ou um multiplicador fixo de custo — sem um corpus, a escolha do modelo e a configuração. A pergunta útil para planejar o orçamento é: que trabalho esse pipeline acrescenta?
Para a abordagem de extração e resumo da Microsoft, inclua o trabalho realizado pelo modelo para extrair entidades e relações e gerar resumos de comunidades. Essas são etapas adicionais de preparação, além de um pipeline básico de divisão em blocos e geração de embeddings. Não considere “código aberto” um orçamento para executar esse trabalho.
Para um projeto-piloto, registre os custos separadamente:
- Preparação inicial: geração de embeddings, extração e geração de resumos onde forem usados na sua arquitetura.
- Perguntas: trabalho de recuperação de informações, contexto fornecido ao LLM e geração de respostas.
- Atualizações: trabalho necessário para incorporar às representações que você mantém as alterações feitas nas fontes.
- Operações: armazenamento, depuração e revisão de relações incorretas ou ausentes.
As atualizações merecem um teste próprio. Edite uma afirmação na fonte, execute novamente o fluxo de atualização escolhido e examine a resposta resultante. Confira o conteúdo original, a representação em grafo e qualquer resumo que tenha se baseado na afirmação antiga. Não presuma que uma indexação inicial bem-sucedida comprove que a coleção se mantém atualizada.
Se as suas arestas já existem como links explícitos, você pode evitar a extração por LLM para essas arestas. Isso não elimina a recuperação de conteúdo, a geração de respostas nem a manutenção. Elimina uma etapa específica — não todos os custos associados ao RAG baseado em grafos.
Suas notas já têm uma estrutura de grafo
Um espaço de trabalho interconectado oferece um ponto de partida diferente de uma pasta de documentos desconectados. O Notion já contém arestas explícitas por meio de propriedades de Relação em bancos de dados, menções a páginas e backlinks, e relações entre páginas principais e subpáginas. Os cofres do Obsidian têm wikilinks. Esses links podem se tornar arestas no grafo sem precisar pedir a um LLM que as descubra.
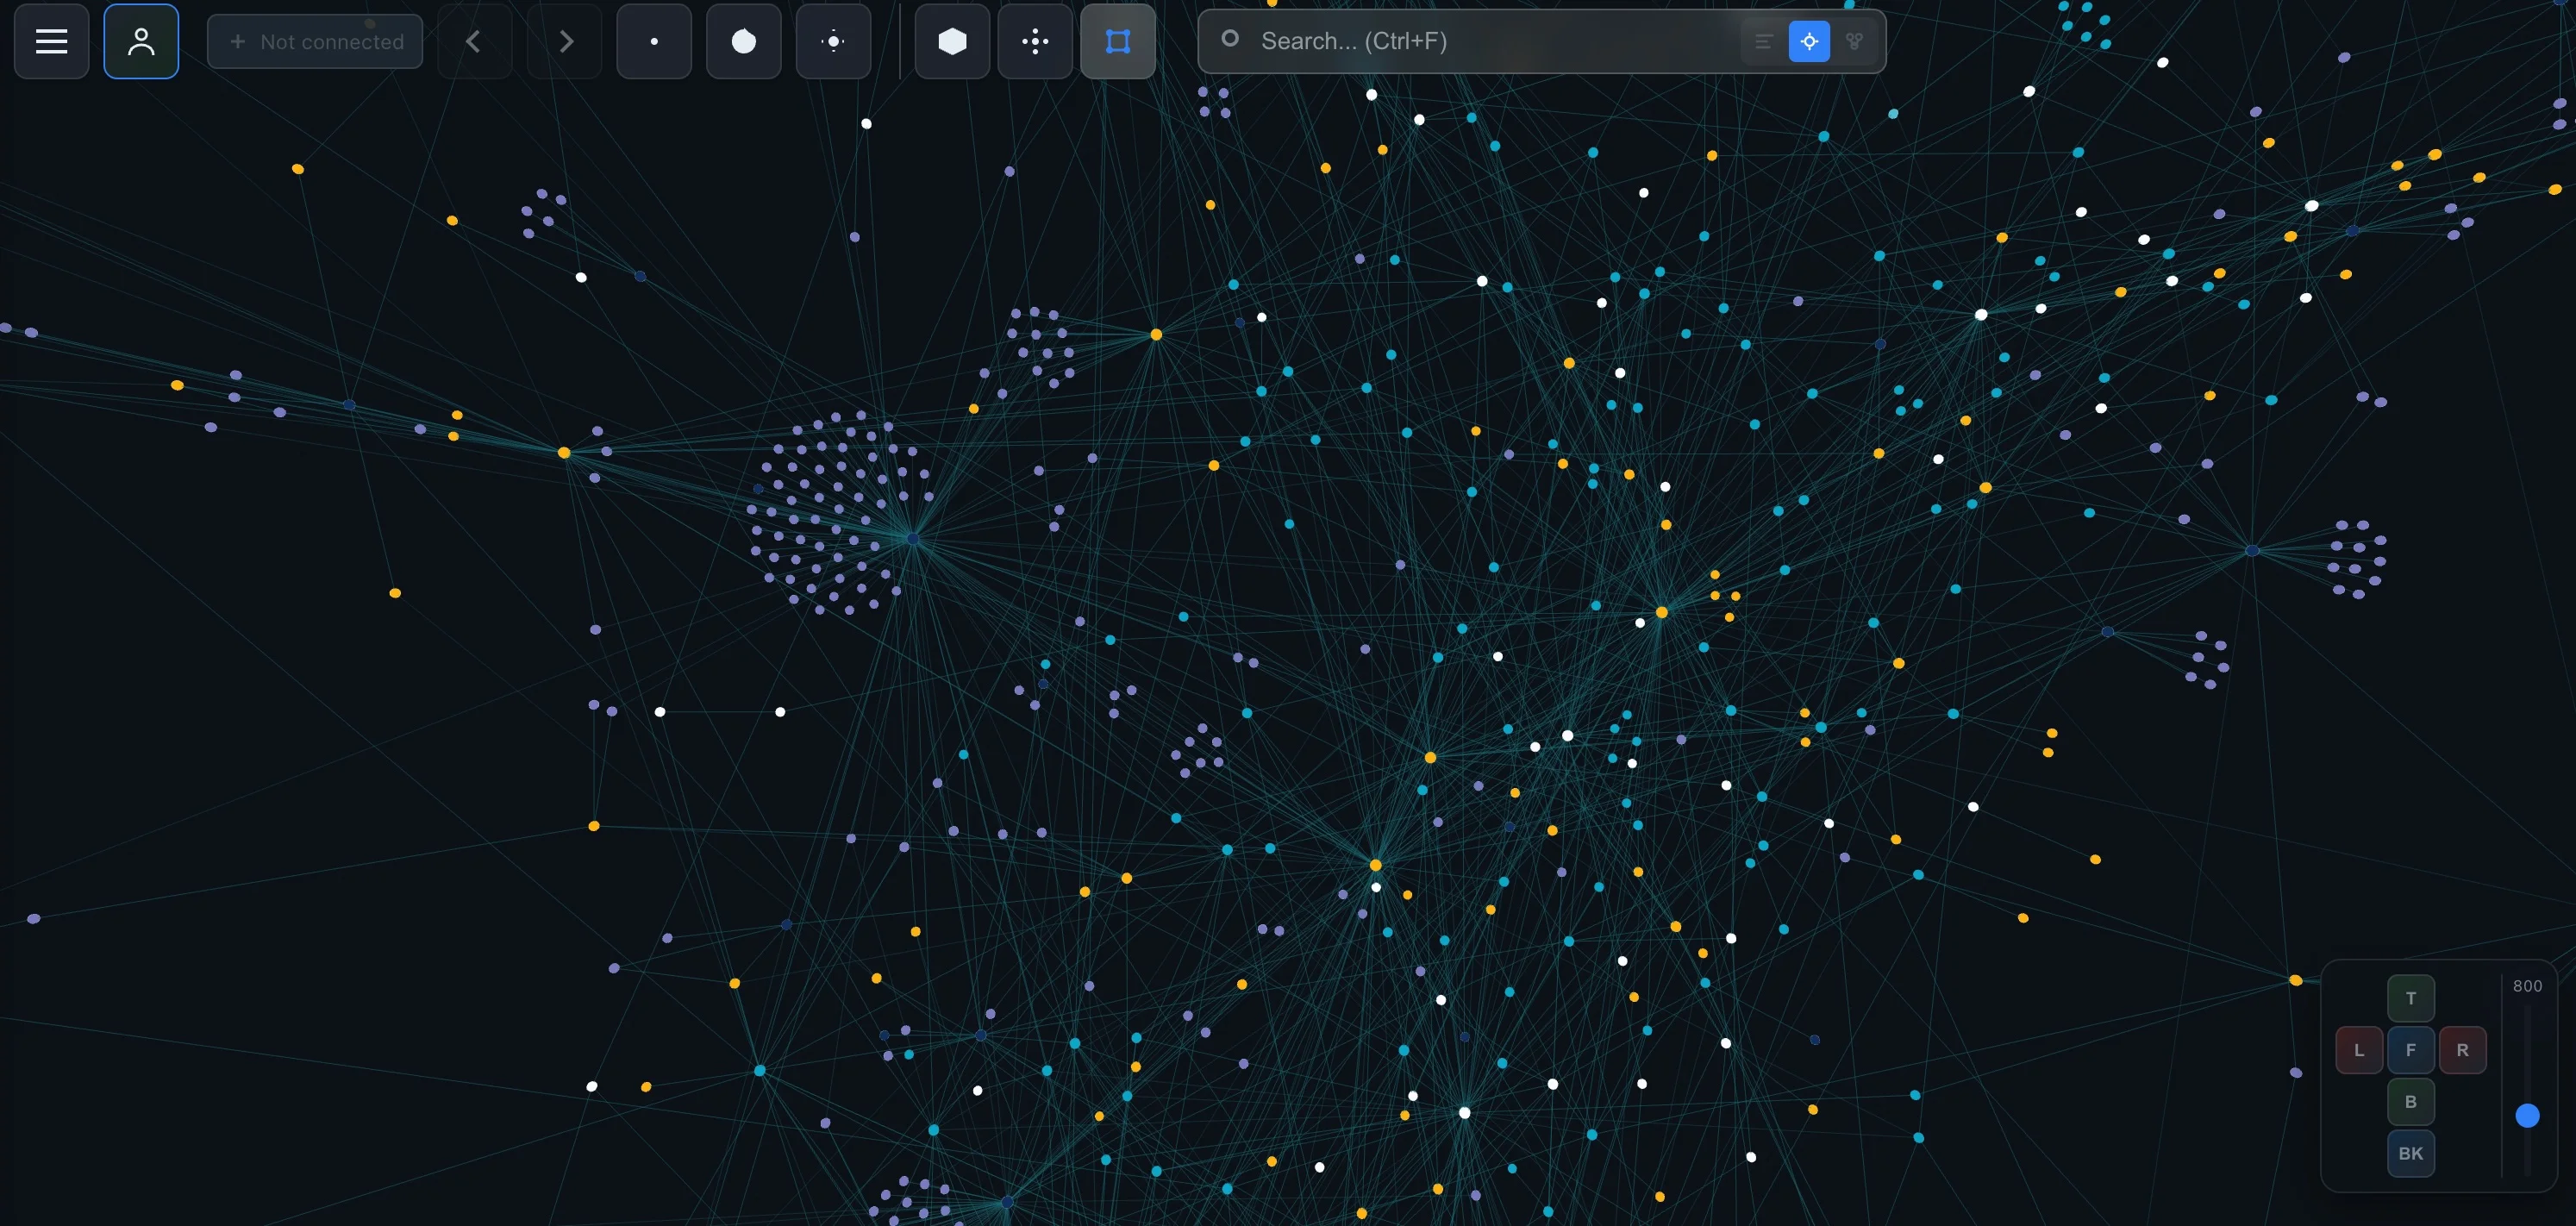
Suponha que seu banco de dados hipotético de Projetos tenha uma Relação com um banco de dados de Serviços, enquanto as notas de incidentes mencionam páginas de serviços. Você já tem um caminho que vai de uma nota de incidente a um serviço e, depois, aos projetos relacionados. Nosso guia sobre Relações entre bancos de dados no Notion aborda os links explícitos; o guia sobre o grafo de conhecimento do Notion, mais abrangente, coloca esses links em contexto.
Uma ressalva honesta: um grafo de páginas não é automaticamente um grafo de conhecimento de entidades. Uma página pode abordar várias entidades. Uma menção indica que uma página faz referência a outra, não necessariamente que um serviço depende de outro. Um vínculo entre um elemento pai e um elemento filho expressa hierarquia, não propriedade ou causalidade.
Preserve essa distinção na recuperação de informações. Siga uma menção para encontrar evidências potencialmente úteis e, depois, leia a página antes de afirmar o que a relação significa.
Isso se conecta naturalmente a uma wiki de LLM: pense separadamente nas páginas de origem, nos links entre elas e na interpretação gerada. Manter essas camadas separadas facilita a revisão de uma resposta, em vez de tratar cada conexão gerada como um fato estabelecido.
Dê aos agentes acesso à estrutura e ao conteúdo
O IVGraph cria um grafo a partir de páginas, backlinks, menções e Relações de bancos de dados do Notion. Sua API V1 para LLMs de somente leitura permite que agentes façam buscas, acessem detalhes dos nós e o conteúdo das páginas e percorram o grafo. Juntos, o grafo e a API são suficientes para criar um fluxo de recuperação de informações que leva o grafo em conta, com base em um espaço de trabalho que você já mantém.
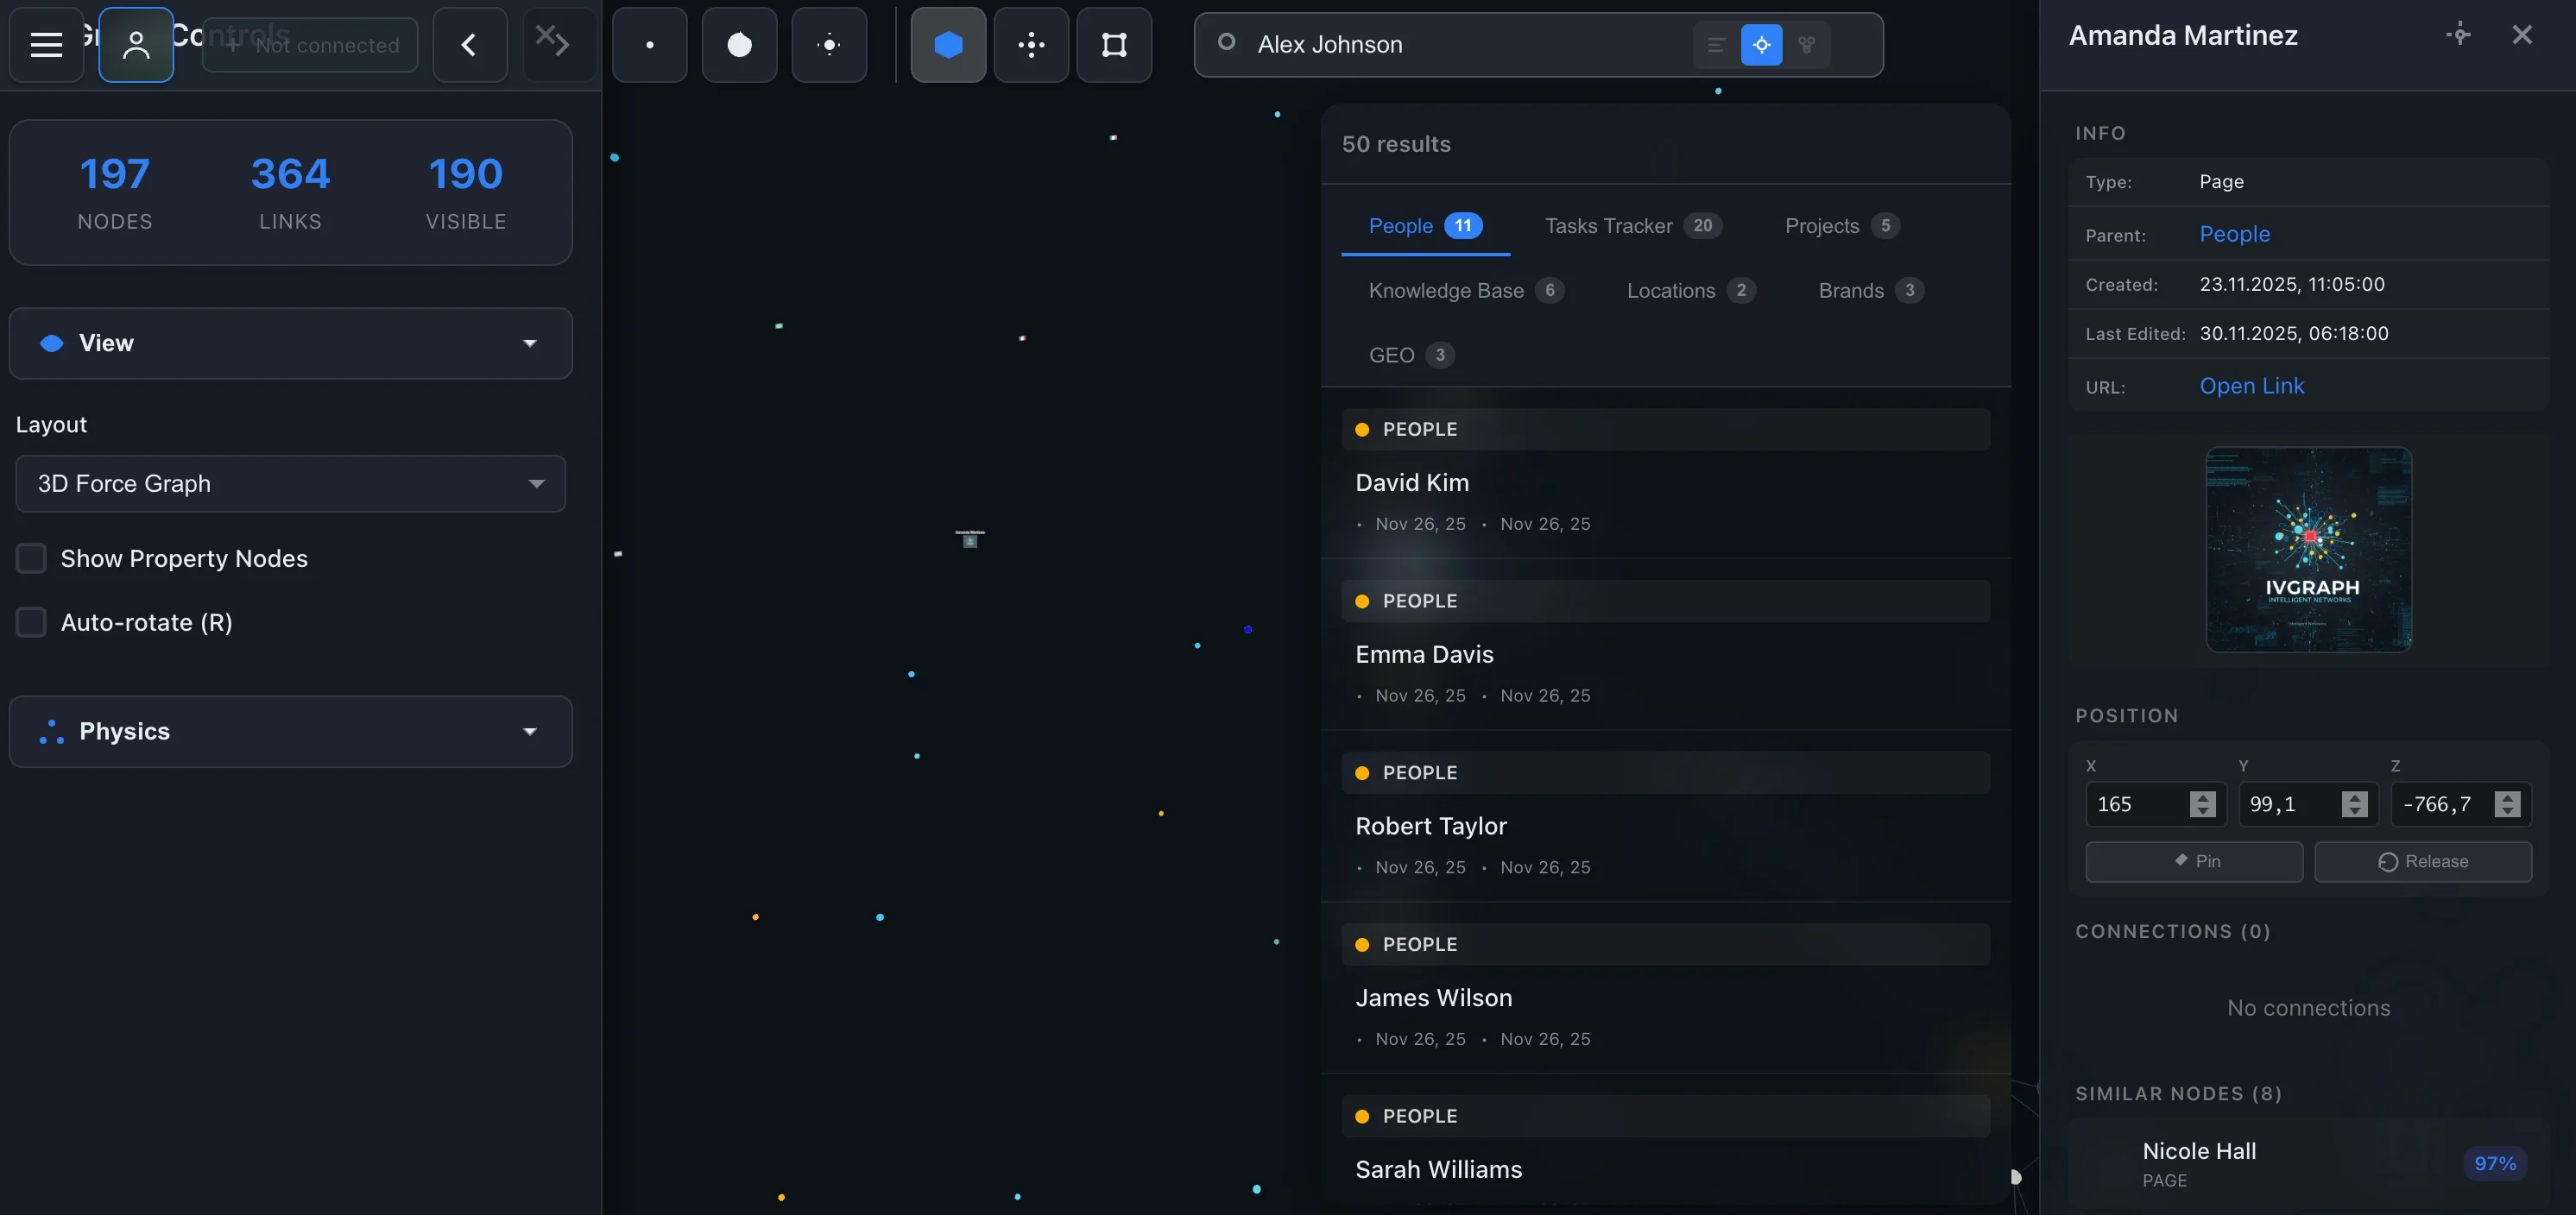
Um fluxo de trabalho simples para testar com um agente é: buscar o projeto, inspecionar seu nó, seguir os links relevantes, obter o conteúdo das páginas conectadas e responder com base nessas evidências. Para um fluxo de trabalho pessoal mais amplo, veja como criar um segundo cérebro com um LLM, Notion e Claude Code.
Não comece extraindo relações que você já mantém de forma explícita. Primeiro, teste se tornar essas relações visíveis resolve o problema de falta de contexto.
Como começar aos poucos
Comece com perguntas, não com uma migração de banco de dados. Use esta lista de verificação para manter o experimento vinculado a falhas reais na recuperação de informações:
- Escolha uma coleção delimitada. Escolha uma área do projeto cujo conteúdo e relações você consiga revisar por conta própria.
- Formule perguntas reais. Inclua consultas diretas, perguntas sobre fatos conectados e perguntas que abrangem toda a coleção, se forem relevantes para o seu trabalho.
- Identifique as evidências necessárias. Anote quais trechos e relações uma resposta correta precisa usar.
- Execute uma busca vetorial como referência. Salve tanto o contexto recuperado quanto a resposta gerada. Identifique as evidências que faltam antes de mudar a arquitetura.
- Faça um inventário das arestas existentes. Separe as relações úteis das menções incidentais e dos vínculos hierárquicos.
- Adicione apenas a capacidade que falta. Teste a travessia do grafo para fatos conectados ou o fluxo de extração e resumo da Microsoft para as perguntas que ele foi projetado para responder.
- Compare e atualize. Revise a cobertura das evidências, as afirmações sem respaldo, o custo e o tempo de resposta. Depois, edite uma fonte e verifique se as informações estão atualizadas.
Mantenha a camada de grafo se ela recuperar o contexto necessário que a abordagem de referência deixa passar, a um custo que você possa suportar. Se as duas abordagens responderem igualmente bem, prefira a que for mais fácil de manter.
Perguntas frequentes
O que é GraphRAG em termos simples?
GraphRAG é uma forma de geração aumentada por recuperação que usa um grafo de conhecimento de entidades e relações para encontrar contexto para um LLM. Em vez de encontrar apenas trechos semelhantes, pode recuperar informações por meio das conexões entre as coisas.
GraphRAG é melhor que RAG vetorial?
Não para todas as perguntas. O RAG vetorial é um bom ponto de partida para encontrar trechos relevantes. Vale a pena testar a recuperação baseada em grafos quando as respostas exigem fatos interligados, enquanto a abordagem da Microsoft baseada em resumos de comunidades também permite responder a perguntas sobre o conjunto de dados inteiro. Compare as duas opções usando suas próprias perguntas e fontes.
O Microsoft GraphRAG é o mesmo que RAG baseado em grafos em geral?
Não. O Microsoft GraphRAG é uma implementação de código aberto que extrai entidades e relações, agrupa esses elementos em comunidades, gera resumos e oferece busca local e global. A recuperação baseada em grafos também pode usar relações existentes sem todo esse fluxo de extração e geração de resumos.
Quanto custa o GraphRAG?
Não há um preço único que sirva de referência sem definir o conjunto de documentos, o modelo e a configuração do pipeline. Inclua no orçamento a extração e a geração de resumos, quando utilizadas, a recuperação de informações e a geração de respostas, o armazenamento e as atualizações. Meça os custos com uma pequena amostra representativa, em vez de presumir um multiplicador fixo em relação ao RAG vetorial.
Posso usar links do Notion para GraphRAG?
Sim. Relações de bancos de dados, menções e backlinks, e páginas-pai e páginas-filhas podem fornecer arestas explícitas para o grafo sem extração por LLM. Você ainda precisa de um fluxo de recuperação que selecione páginas relevantes, leia seu conteúdo e forneça evidências ao modelo que gera a resposta. Um link para uma página, por si só, não explica a relação.