 IVGraph
Les logiciels de graphes de connaissances recouvrent des produits très différents : applications de prise de notes qui visualisent vos liens, bases de données qui répondent à des questions en explorant des millions de relations, outils de bureau pour l’analyse de réseaux, pipelines d’IA qui transforment des documents en graphes et serveurs de mémoire pour les agents d’IA. La bonne question n’est donc pas de savoir quel outil est le meilleur, mais quelle tâche vous devez accomplir. Ci-dessous, 18 outils sont classés par usage. Leur licence, l’existence d’une option gratuite, leur prix et la nécessité ou non d’écrire du code ont été vérifiés à une même date. Vous trouverez ensuite cinq questions pour faire votre choix et trois façons de tester un outil sur vos propres données.
Cinq tâches qu’un outil de graphe de connaissances peut accomplir
Un graphe de connaissances stocke les éléments sous forme de nœuds et les relations nommées qui les relient sous forme d’arêtes. Les personnes comme les logiciels peuvent ainsi suivre les connexions plutôt que de chercher dans du texte. Notre guide comprend un petit graphe sur lequel vous pouvez cliquer. Les outils se distinguent par la partie du travail qu’ils prennent en charge :
- Cartographiez vos notes. Visualisez les liens que vous créez déjà entre vos notes, vos pages et vos idées : ce qui est central, ce qui est isolé. Obsidian, Logseq, Anytype, InfraNodus, Kumu et IVGraph pour Notion. Voir les outils pour vos notes.
- Stockez et interrogez. Chargez des enregistrements dans une base de données et posez des questions qui nécessitent de parcourir plusieurs liens, comme « quels clients ont acheté des produits fabriqués avec les pièces de ce fournisseur ? » Neo4j, Memgraph, FalkorDB, GraphDB, Amazon Neptune. Voir les bases de données orientées graphe.
- Visualisez et analysez. Représentez un réseau dont vous disposez déjà, repérez les groupes et les pôles, mesurez qui occupe une position centrale. Gephi, Cytoscape, yEd, Neo4j Bloom. Voir les outils de visualisation.
- Créez un graphe à partir de textes avec l’IA. Laissez un modèle de langage extraire les entités et les relations de documents. Neo4j LLM Knowledge Graph Builder, Microsoft GraphRAG, LightRAG. Voir les outils de création de graphes par IA.
- Donnez une mémoire à un agent. Dotez un agent IA d’un graphe où il enregistre des faits et les consulte lors de sessions ultérieures. Le serveur de mémoire MCP, Graphiti, mem0. Voir la mémoire des agents.
Leurs fonctions se recoupent : Neo4j stocke des graphes et intègre un explorateur visuel, tandis que LightRAG construit un graphe à partir de texte et vous permet de l’explorer. Choisissez selon votre besoin principal.
Les outils de graphes de connaissances en un coup d’œil
| Outil | Idéal pour | Licence | Offre gratuite | Tarif à partir de | Code requis |
|---|---|---|---|---|---|
| Obsidian | Des notes liées dans des fichiers Markdown locaux | Code source fermé | L’application complète, y compris pour un usage professionnel | Sync 4 $US/mois, facturation annuelle | Non |
| Logseq | Des plans structurés et des journaux quotidiens | Open source (AGPL-3.0) | Tout | — | Non |
| Anytype | Des notes privées sous forme d’objets typés | Code source accessible | Offre gratuite | 4 $US/mois (Plus) | Non |
| InfraNodus | Les thèmes et les lacunes dans les notes et les textes | Code source fermé | 3 graphes | €12/mois, facturation annuelle | Non |
| Kumu | Des cartes de relations à partager | Code source fermé | Projets publics | 9 $US/mois par projet privé | Non |
| IVGraph | Un espace de travail Notion sous forme de graphe 3D | Code source fermé | Jusqu’à 500 nœuds | 5 $US/mois (Plus) | Non |
| Neo4j | Des applications et des analyses sur un graphe à propriétés | Community Edition open source (GPLv3) | Community Edition, AuraDB Free | 0,09 $US par Go-heure (AuraDB Professional) | Oui, Cypher |
| Memgraph | Des données en temps réel et en flux continu | Code source accessible (BSL 1.1) | Community Edition | Sur devis (Enterprise) | Oui, Cypher |
| FalkorDB | Un backend rapide pour GraphRAG et les agents | Code source accessible (SSPL) | Auto-hébergement, offre cloud gratuite | 73 $US/mois (1 Go dans le cloud) | Oui, Cypher |
| GraphDB | Des données RDF, des ontologies et du raisonnement | Code source fermé | GraphDB Free (1 cœur CPU) | Sur devis (Enterprise) | Oui, SPARQL |
| Gephi, Gephi Lite | L’analyse visuelle de réseaux | Open source (GPL-3.0) | Tout | — | Non |
| Cytoscape | Des réseaux aux nombreux attributs | Open source (LGPL-2.1) | Tout | — | Non |
| yEd | Des diagrammes clairs avec disposition automatique | Code source fermé | Tout, y compris pour un usage commercial | — | Non |
| LLM Knowledge Graph Builder | Tester la conversion de texte en graphe sur vos fichiers | Open source (Apache 2.0) | Application hébergée avec AuraDB Free | — | Non |
| Microsoft GraphRAG | Des questions sur un ensemble de documents dans sa globalité | Open source (MIT) | Tout ; vous payez les appels aux modèles | — | Oui, Python |
| LightRAG | GraphRAG avec une interface web | Open source (MIT) | Tout ; vous payez les appels aux modèles | — | Configuration initiale, puis interface web |
| Graphiti | Une mémoire pour agents qui suit les changements au fil du temps | Open source (Apache 2.0) | Tout ; vous faites fonctionner la base de données | — | Oui, Python |
| Serveur de mémoire MCP | Un petit graphe de mémoire local pour Claude | Open source (MIT, migration vers Apache 2.0) | Tout | — | Une commande |
La tendance : les outils de prise de notes coûtent peu et ne nécessitent pas de coder. Les bases de données et les pipelines d’IA sont souvent téléchargeables gratuitement, mais nécessitent d’écrire des requêtes ou du code Python, et vous payez l’hébergement et les appels aux modèles.
Outils open source pour les graphes de connaissances
Ces projets utilisent des licences approuvées par l’Open Source Initiative :
- Notes : Logseq (AGPL-3.0).
- Bases de données : Neo4j Community Edition (GPLv3) et ArcadeDB (Apache 2.0), une base de données multimodèle qui répond aux requêtes SQL, Cypher et Gremlin.
- Visualisation : Gephi et Gephi Lite (GPL-3.0), Cytoscape (LGPL-2.1) et, pour les développeurs, Cytoscape.js et sigma.js (MIT).
- Outils de création basés sur l’IA : Neo4j LLM Knowledge Graph Builder (Apache 2.0), Microsoft GraphRAG et LightRAG (MIT).
- Mémoire des agents : Graphiti (Apache 2.0) et le serveur de mémoire MCP, dont le code est en cours de migration de la licence MIT vers la licence Apache 2.0.
Memgraph et FalkorDB se présentent comme open source, mais utilisent respectivement la Business Source License 1.1 et la Server Side Public License, tandis qu’Anytype utilise sa propre licence Any Source Available License. Vous pouvez lire et exécuter le code ; lisez la licence avant de vous en servir pour créer un service commercial. Autre mise en garde : Kùzu, une base de données graphe embarquée que des listes plus anciennes recommandent encore, a été archivée le 10 octobre 2025, et Graphiti indique désormais que son pilote Kùzu est déprécié. Ne l’utilisez pas pour de nouveaux projets.
Pour vos notes : des outils pour votre graphe de connaissances personnel
Un graphe de connaissances personnel est constitué de vos propres contenus, comme des notes, des personnes, des projets, des sources et des idées, reliés par des liens que vous créez. Pour la plupart des gens, l’application de graphe de connaissances qui convient est l’application de prise de notes qu’ils utilisent déjà, à condition qu’elle puisse afficher ces liens sous forme de graphe. Les applications se distinguent surtout par ce qu’elles considèrent comme un lien.
Vue graphe d’Obsidian
Obsidian conserve les notes sous forme de fichiers Markdown dans un dossier local et intègre une vue graphe : chaque note est un nœud, chaque lien interne une ligne. Le graphe global affiche l’ensemble du coffre. Le graphe local affiche les notes autour de celle que vous lisez, avec un curseur pour régler la profondeur. Les groupes colorent les notes selon des requêtes de recherche comme path:Projects ou tag:#book. L’application est gratuite, y compris pour un usage professionnel ; Sync coûte 4 $US par mois et par utilisateur, avec une facturation annuelle. Notre guide de la vue graphe d’Obsidian explique chaque réglage. Obsidian convient aux personnes qui écrivent seules dans des fichiers locaux.
Logseq
Logseq est un outil gratuit et open source de prise de notes hiérarchiques (AGPL-3.0), organisé autour de journaux quotidiens. Son graphe relie les pages, et non les blocs : si une entrée de journal mentionne deux pages, chacune est reliée à la journée en question, mais pas à l’autre page. Logseq 2.0, qui stocke les notes dans une base de données plutôt que dans des fichiers Markdown, est en bêta ; la version 2.0.2 est sortie le 7 octobre 2026. Pour découvrir d’autres applications de cette catégorie, consultez les alternatives à Obsidian.
Anytype
Anytype conserve vos données sur votre appareil et traite chaque élément comme un objet typé, par exemple une note, une tâche ou une personne. Dans son graphe, chaque objet est un nœud, et les traits proviennent des liens dans le texte, des propriétés qui pointent vers d’autres objets et des rétroliens ; vous pouvez filtrer par type d’objet. Le code est publié sous la licence Any Source Available License. L’offre gratuite comprend 100 MB de stockage distant pour la synchronisation ; Plus coûte 4 $US par mois. Comparaison avec Notion : Anytype vs Notion.
InfraNodus
InfraNodus construit un graphe à partir du texte lui-même plutôt que de vos liens : les concepts qui apparaissent ensemble dans votre texte sont reliés. Il affiche ensuite les groupes thématiques, les concepts qui en assurent la cohésion et les lacunes entre ces groupes, puis son IA suggère des questions de recherche qui pourraient combler une lacune. Il fonctionne avec des textes, des fichiers et des sources web, sous forme de module complémentaire pour Obsidian (InfraNodus AI Graph View) et via un serveur MCP pour les agents. L’offre gratuite comprend 3 graphes ; les offres payantes sont proposées à partir de €12 par mois avec une facturation annuelle et un essai de 14 jours. Il vous aide à voir de quoi parlent vos notes et ce qui leur manque.
Kumu
Kumu est une application web qui permet de créer des cartes de relations à la main ou de les importer depuis une feuille de calcul, puis de les rendre lisibles grâce à des éléments de mise en forme, des filtres et des regroupements. Les projets publics sont gratuits ; un projet privé coûte 9 $US par mois. Kumu convient davantage aux cartes que vous partagez qu’aux notes privées.
IVGraph pour Notion
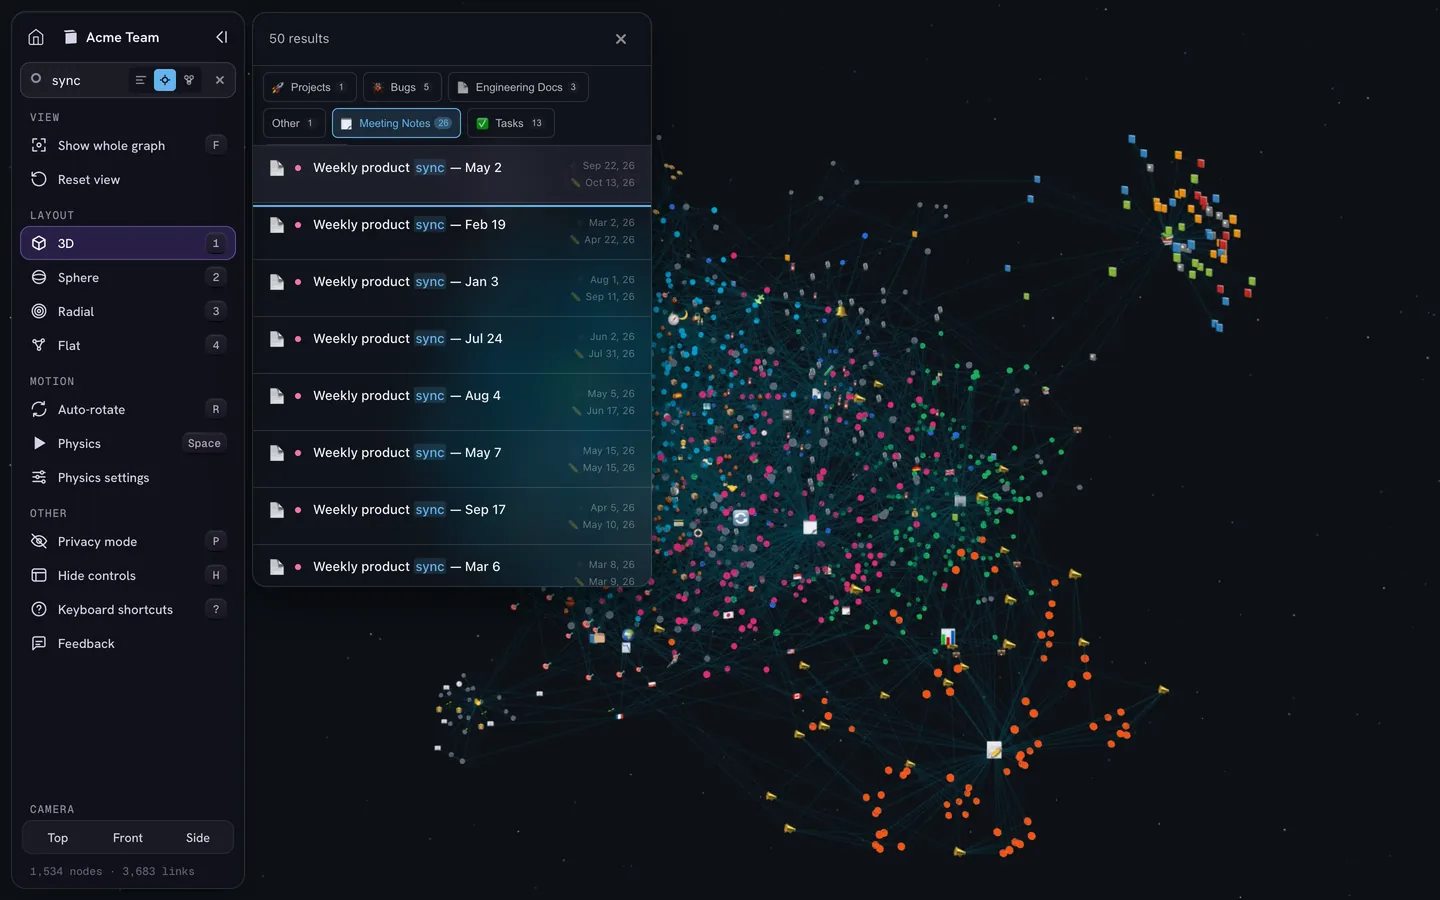
Notion ne propose pas de vue graphe intégrée, et c’est pour combler ce manque que nous avons créé IVGraph. Il s’agit de notre produit : gardez-le à l’esprit en lisant cette présentation. Vous vous connectez avec Notion et accordez un accès en lecture seule. IVGraph représente alors votre espace de travail sous forme de graphe 3D interactif : les pages et les bases de données sont des nœuds, tandis que les mentions, les rétroliens, les propriétés Relation des bases de données et les pages parentes constituent les liens. Vous pouvez passer d’une vue à l’autre — 3D, Sphère, Radiale ou À plat —, rechercher des pages avec des résultats regroupés par base de données, classer les pages par importance avec PageRank, repérer celles vers lesquelles aucun lien ne pointe, et modifier la couleur ou la taille des pages, ou les masquer, à l’aide de règles de style. Avec les forfaits Pro et Max, une API pour les agents IA en lecture seule permet à Claude ou à votre propre script d’effectuer des recherches dans l’espace de travail, de lire les pages et de suivre les liens.
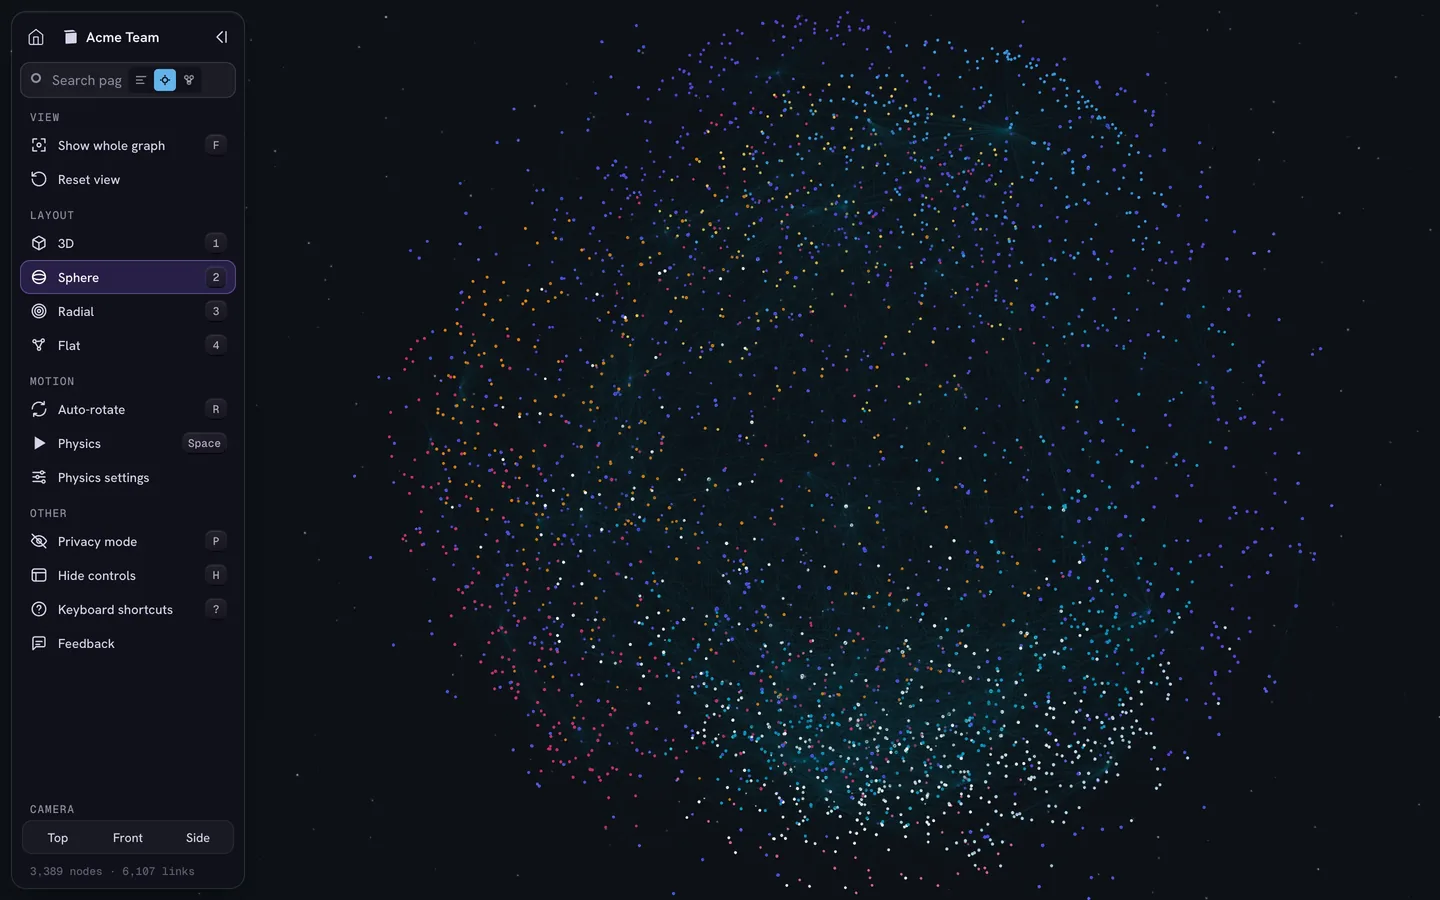
L’application fonctionne uniquement avec Notion ; pour un vault (coffre) Obsidian, notre outil gratuit distinct Obsidian Graph Online génère le graphe dans votre navigateur. IVGraph n’importe ni fichiers CSV ni fichiers RDF, et ce n’est ni une base de données ni un langage de requête. L’offre Free prend en charge jusqu’à 500 nœuds ; Plus coûte 5 $US par mois pour 3 000 nœuds, Pro coûte 10 $US par mois pour 10 000 nœuds et l’accès à l’API, et vous pouvez essayer Pro pendant une semaine pour 1,99 $US. Pour découvrir ce que Notion propose nativement, consultez Notion propose-t-il une vue graphe ?.
Bases de données orientées graphe : stocker et interroger un graphe de connaissances
Une base de données de graphes de connaissances prend tout son sens lorsque vous devez interroger les données, et pas seulement les observer : quels éléments dépendent de ce service, ou quels clients sont liés à un compte signalé par l’intermédiaire d’appareils partagés. Vous modélisez les données sous forme de nœuds et de relations, vous les chargez, puis vous les interrogez dans un langage comme Cypher ou SPARQL. Toutes les solutions présentées ici supposent d’être à l’aise avec les requêtes ou le code.
Neo4j
Neo4j stocke un graphe de propriétés qui s’interroge avec Cypher, un langage que Neo4j décrit comme conforme à GQL. La Community Edition est open source sous licence GPLv3 et peut être exécutée gratuitement sur votre propre serveur. Dans le cloud, AuraDB Free ne nécessite aucun moyen de paiement et limite le nombre de nœuds et de relations ; AuraDB Professional est proposé à partir de 0,09 $US par Go-heure avec un minimum de 1 Go, soit environ 66 $US par mois pour une instance de 1 Go. Bloom et le LLM Knowledge Graph Builder, présentés ci-dessous, sont également des outils de Neo4j.
Memgraph
Memgraph conserve le graphe en mémoire, l’écrit sur disque pour en assurer la persistance et prend également en charge Cypher. La Community Edition gratuite comprend déjà la réplication, la recherche vectorielle, des connecteurs de flux pour Kafka, Pulsar et Redpanda, ainsi que la bibliothèque d’algorithmes de graphes MAGE. Le code est sous licence Business Source License 1.1, et Memgraph Lab est son interface visuelle. Le tarif Enterprise est établi sur devis en fonction de la taille de la mémoire. Memgraph convient aux données qui arrivent en flux et doivent être interrogées immédiatement.
FalkorDB
FalkorDB repose sur Redis et stocke les graphes sous forme de matrices creuses à l’aide de la bibliothèque GraphBLAS ; vous l’interrogez avec openCypher. Il est conçu pour le GraphRAG et la mémoire des agents : il dispose de son propre SDK GraphRAG et fait partie des bases de données prises en charge par Graphiti. Une seule commande Docker lance la base de données sur votre machine, avec une interface accessible dans le navigateur. Le code est sous licence Server Side Public License. L’offre cloud comprend une formule gratuite, et les formules payantes commencent à 73 $US par mois pour 1 GB.
GraphDB
GraphDB est une base de données RDF : les données sont stockées sous forme de triplets sujet–prédicat–objet et interrogées avec SPARQL. La base peut déduire de nouveaux faits à partir d’une ontologie en appliquant les jeux de règles RDFS et OWL 2 RL et QL. GraphDB a été développé par Ontotext ; en 2024, Ontotext et Semantic Web Company ont fusionné pour former Graphwise, qui le commercialise désormais. GraphDB Free fonctionne sur un seul cœur de processeur et, depuis la version 11, nécessite une clé de licence gratuite envoyée par e-mail. Le tarif de l’édition Enterprise est disponible sur demande.
Amazon Neptune et Stardog
Amazon Neptune est une base de données graphe gérée sur AWS qui prend en charge Gremlin, openCypher et SPARQL, et peut donc stocker un graphe de propriétés ou des données RDF. Les nouveaux utilisateurs bénéficient d’un essai gratuit de 30 jours sur une petite instance ; ensuite, la facturation se fait à l’usage. Cette solution convient aux équipes qui utilisent déjà AWS. Stardog, une plateforme d’entreprise fondée sur RDF, propose Stardog Free : une offre autorisée pour un usage commercial mais non open source, renouvelée chaque année, sans haute disponibilité ni sauvegardes.
Graphe de propriétés ou RDF ?
Un graphe de propriétés (Neo4j, Memgraph, FalkorDB) stocke des nœuds et des relations, tous dotés de propriétés. Vous concevez le modèle en fonction de vos propres questions, ce qui convient aux applications et aux backends GraphRAG. RDF (GraphDB, Stardog) stocke des triplets avec des identifiants globaux, ce qui facilite la fusion de données issues de différentes sources et de vocabulaires partagés. Une ontologie permet en outre à la base de données de déduire des faits que vous n’avez pas explicitement renseignés. Vous développez une application ou un backend d’IA ? Commencez par un graphe de propriétés. Vous reliez des données entre équipes ou organisations, ou publiez des données liées ? Tournez-vous vers RDF. Notre guide explique les triplets, schémas et ontologies.
Visualisation d’un graphe de connaissances : explorez et analysez un graphe
Les outils de visualisation partent d’un graphe dont vous disposez déjà, sous forme de fichier, de feuille de calcul répertoriant des liens ou de base de données, et vous aident à en voir la structure : les groupes, les pôles et les nœuds qui relient les groupes entre eux. Certains permettent aussi de le mesurer. Des données de mauvaise qualité restent de mauvaise qualité, même bien présentées.
Gephi et Gephi Lite
Gephi est une application de bureau gratuite et open source (GPL) dédiée à l’analyse visuelle de réseaux. Elle propose des algorithmes de détection de communautés, de centralité et de clustering, des algorithmes de spatialisation comme ForceAtlas2, une vue sous forme de tableur pour modifier les données, ainsi que l’export aux formats PNG, PDF et SVG. La version 0.11, sortie en mai 2026, a apporté une amélioration majeure des performances ; la version 0.11.3 est sortie le 6 septembre 2026. Gephi Lite est la version web allégée : elle fonctionne dans un navigateur, sans rien avoir à installer, et repose sur la bibliothèque sigma.js.
Cytoscape
Cytoscape est une application de bureau Java open source (LGPL) dédiée à l’analyse de réseaux. Créée en 2003 comme outil d’analyse des réseaux d’interactions biomoléculaires, elle propose aujourd’hui des applications couvrant la bioinformatique, l’analyse des réseaux sociaux et le web sémantique. La version 3.10.5 est sortie le 29 septembre 2026. Le projet apparenté Cytoscape.js (MIT) est une bibliothèque permettant d’intégrer des graphes dans des applications web.
yEd
yEd est un éditeur de diagrammes gratuit pour ordinateur, proposé par yWorks. Il est également gratuit pour un usage commercial, mais n’est pas open source. Son point fort est l’agencement automatique : importez des nœuds et des arêtes depuis une feuille Excel ou un fichier XML, et ses algorithmes agencent les diagrammes, même les plus volumineux. La version actuelle est la 3.25.1, et yEd Live fonctionne dans un navigateur. Utilisez-le pour créer un diagramme clair, pas pour faire de l’analyse.
Neo4j Bloom
Si votre graphe est hébergé dans Neo4j, Bloom permet aux personnes qui n’écrivent pas de requêtes Cypher de l’explorer : effectuer des recherches avec des expressions proches du langage naturel, afficher les nœuds voisins, consulter et modifier les enregistrements. Bloom fait partie de la console Aura, où Neo4j répertorie tous les outils de graphe accessibles sur AuraDB Free, et existe aussi sous forme d’application autonome.
Outils commerciaux pour les graphes de grande taille et les enquêtes
- Graphistry affiche de très grands graphes à l’aide de GPU et s’utilise depuis des notebooks Python via PyGraphistry. Graphistry Hub propose une offre gratuite ; l’offre Professional coûte 83 $US par mois avec une facturation annuelle, ou 100 $US par mois avec une facturation mensuelle.
- KeyLines et ReGraph de Cambridge Intelligence sont des SDK commerciaux JavaScript et React qui permettent d’intégrer la visualisation de graphes à votre propre produit ; des essais sont disponibles sur demande.
- Linkurious Enterprise s’appuie sur une base de données orientée graphe pour les équipes d’investigation et propose des fonctions de recherche, un outil de création de requêtes sans code et des fonctions de collaboration. L’édition cloud coûte 490 € par utilisateur et par mois après un essai de 30 jours.
Pour les développeurs : bibliothèques de visualisation de graphes
Pour intégrer un graphe dans votre propre application, utilisez une bibliothèque plutôt qu’une application :
- Cytoscape.js (MIT) : théorie des graphes et visualisation réunies dans une seule bibliothèque, avec de nombreuses extensions d’agencement.
- sigma.js (MIT) : rendu WebGL pour des graphes comptant des milliers de nœuds et d’arêtes, désormais en version 4.
- D3 (ISC) : des composants de bas niveau, dont une simulation de forces, pour des représentations entièrement sur mesure.
- 3d-force-graph (MIT) : un graphe 3D à placement par forces basé sur Three.js et WebGL. La vue 3D d’IVGraph repose sur cette bibliothèque.
Créez un graphe de connaissances à partir de texte grâce à l’IA
Un outil de création de graphes de connaissances lit des documents et demande à un modèle de langage d’en extraire les entités, comme les personnes, les produits et les concepts, ainsi que les relations entre elles. Le résultat est stocké sous forme de graphe que vous pouvez interroger ou fournir à un chatbot. Considérez ce résultat comme une ébauche : les modèles fusionnent des éléments différents qui portent le même nom, passent à côté de certaines relations et désignent une même relation de plusieurs façons. Vérifiez manuellement un échantillon avant de vous y fier. Pour savoir dans quels cas la recherche dans un graphe surpasse la recherche vectorielle classique, consultez notre guide pour comprendre GraphRAG.
Générateur de graphes de connaissances de Neo4j basé sur les LLM
Le LLM Knowledge Graph Builder permet de tester rapidement cette idée sur vos propres fichiers. Cette application en ligne de Neo4j Labs fonctionne ainsi : connectez une base de données Neo4j, ajoutez des PDF, des documents, des pages web ou des transcriptions de vidéos YouTube, puis choisissez un modèle. Elle construit alors deux couches. L’une contient vos documents découpés en fragments, avec leurs représentations vectorielles ; l’autre contient les entités et leurs relations, toutes reliées à leur fragment d’origine. Vous pouvez ensuite dialoguer avec le résultat et l’ouvrir dans Bloom. Neo4j précise que l’outil fonctionne le mieux avec de longs textes en anglais, moins bien avec les feuilles de calcul, les images et les diapositives, et mieux lorsque vous définissez les types de nœuds et de relations. Le code est sous licence Apache 2.0, la version 0.8.7 est sortie en juillet 2026 et Docker Compose permet de l’exécuter en local.
Microsoft GraphRAG
Microsoft GraphRAG (MIT ; version 3.3.0 du 8 octobre 2026) est un pipeline Python qui extrait les entités et les relations, les regroupe en communautés et rédige des synthèses pour répondre à des questions portant aussi bien sur l’ensemble d’une collection que sur des entités précises. Son README avertit que l’indexation peut coûter cher et recommande d’adapter les prompts à vos données. Il précise également que ce code est une démonstration, et non un produit officiellement pris en charge par Microsoft. Commencez par un petit échantillon et surveillez les coûts d’utilisation du modèle.
LightRAG
LightRAG (MIT ; version 1.5.7 du 2 septembre 2026) est un projet de recherche, présenté à EMNLP 2025, qui crée un index sous forme de graphe à partir de vos documents pour la recherche d’informations. Il comprend un serveur et une interface web pour ajouter des documents, poser des questions et parcourir le graphe, et peut stocker les données dans Neo4j, PostgreSQL, MongoDB ou OpenSearch. Choisissez-le si vous souhaitez utiliser GraphRAG avec une interface prête à l’emploi.
Graphify est un graphe de code, pas un outil pour Notion. Si vous avez cherché une alternative à Graphify en pensant trouver un graphe pour Notion : en 2026, les résultats de recherche pour ce nom concernent Graphify, une compétence open source (Apache 2.0) pour Claude Code, Cursor, Codex et Gemini CLI. Cet outil transforme une base de code, avec sa documentation, ses schémas SQL et ses PDF, en un graphe de connaissances que l’agent de programmation peut interroger.
Une mémoire en graphe pour les agents IA
Un agent IA oublie tout d’une session à l’autre, à moins qu’un dispositif ne conserve ce qu’il a appris. La mémoire en graphe stocke ces acquis sous forme d’entités et de relations : l’agent peut ainsi rechercher une personne et suivre les liens vers ses projets et ses décisions, plutôt que de relire d’anciennes conversations. Trois options couvrent la plupart des configurations. Notre guide de la mémoire de Claude Code explique la place de chacune aux côtés de CLAUDE.md.
Le serveur de mémoire MCP
Le serveur de mémoire du projet Model Context Protocol (@modelcontextprotocol/server-memory, version 2.0.0 du 19 octobre 2026) conserve un petit graphe de connaissances dans un fichier local : des entités dotées d’un nom, d’un type et d’observations, ainsi que des relations orientées nommées à la voix active, comme works_at. Claude ou tout autre client MCP y lit et y écrit à l’aide de neuf outils, de create_entities à search_nodes. La recherche porte sur les mots, pas sur le sens. Gratuit, il s’exécute sur votre ordinateur et convient mieux à un assistant utilisé par une seule personne qu’à une équipe.
Graphiti
Graphiti (Apache 2.0 ; version 0.31.2 du 20 octobre 2026) construit un graphe temporel : chaque fait possède une période de validité. Ainsi, lorsqu’un changement survient, l’ancien fait est marqué comme non valide au lieu d’être supprimé, et vous pouvez interroger le graphe pour savoir ce qui était vrai à un instant donné. Chaque fait renvoie au message, au document ou à l’enregistrement dont il est issu. Graphiti nécessite une base de données orientée graphe (Neo4j, FalkorDB ou Amazon Neptune) et un modèle prenant en charge les sorties structurées ; OpenAI est utilisé par défaut. Le dépôt comprend un serveur MCP de référence, dont le README précise qu’il ne dispose d’aucun mécanisme d’authentification : ne l’exposez donc pas à des réseaux non fiables. Zep, l’entreprise à l’origine de Graphiti, commercialise un service géré destiné aux entreprises et reposant sur Graphiti.
mem0
mem0 (Apache 2.0) est une couche de mémoire pour les agents : il extrait des conversations de brèves informations à mémoriser et récupère ensuite celles qui sont pertinentes. Sa mémoire en graphe, qui relie les informations mémorisées par l’intermédiaire des personnes, des lieux et des concepts qu’elles mentionnent, fonctionne sur la plateforme hébergée Mem0 Platform et figure dans l’offre Custom sur sa page des tarifs. L’offre gratuite comprend 10 000 ajouts et 1 000 récupérations par mois pendant les 30 premiers jours, puis 50 000 et 10 000 avec votre propre clé d’accès au modèle.
Si les connaissances dont votre agent a besoin se trouvent déjà dans Notion, vous n’avez peut-être pas du tout besoin d’une mémoire distincte. L’API en lecture seule d’IVGraph, disponible avec les offres Pro et Max, permet à un agent d’effectuer des recherches dans un espace de travail, de lire une page au format Markdown et de suivre ses liens.
Comment choisir en cinq questions
Chaque réponse renvoie à une section ci-dessus.
- Quelle est la nature de vos données ? Des notes que vous rédigez : une application de prise de notes avec un graphe (notes). Des documents que vous avez rassemblés : un outil de création assisté par IA (IA). Des enregistrements issus de feuilles de calcul ou de systèmes : une base de données orientée graphe (bases de données).
- Vous voulez visualiser ou interroger ? Pour repérer des groupes, des nœuds centraux et des nœuds orphelins, il vous faut une application de prise de notes ou un outil de visualisation. Pour demander « qui est relié à qui, et par quoi ? », il vous faut une base de données et un langage de requête.
- En solo ou en équipe ? En solo : Obsidian, Logseq, Anytype ou Gephi. En équipe : Kumu pour des cartes partagées, ou une base de données hébergée comme AuraDB ou Neptune, avec Bloom ou Linkurious comme interface.
- Dans le cloud ou sur votre ordinateur ? Sur votre ordinateur : Obsidian, Logseq, Anytype, Gephi, Cytoscape, yEd, Neo4j Community Edition, FalkorDB dans Docker et le serveur de mémoire MCP. Dans le cloud : InfraNodus, Kumu, IVGraph, AuraDB, Neptune et Mem0 Platform. Tout outil qui envoie du texte à un fournisseur de modèles lui transmet aussi vos données.
- Comptez-vous écrire du code ? Non : les applications de prise de notes, InfraNodus, Kumu, IVGraph, Gephi, yEd et le LLM Knowledge Graph Builder. Un peu : le serveur de mémoire MCP et LightRAG. Oui : les bases de données, GraphRAG et Graphiti.
En général, deux ou trois outils restent en lice après ces questions. Testez-les sur un petit échantillon réel, par exemple un projet ou cinquante documents, et gardez celui qui répond le plus vite aux questions que vous vous posez vraiment.
Essayez un graphe de connaissances avec vos propres données en 10 minutes
Trois courts parcours, un pour chaque type de données. Tous les trois sont gratuits au départ.
Les notes dans Obsidian
- Ouvrez votre coffre et cliquez sur Open graph view (Ouvrir la vue graphe) dans le ruban, ou lancez Graph view: Open graph view (Vue graphe : Ouvrir la vue graphe) depuis la palette de commandes.
- Ouvrez une note que vous connaissez bien, lancez Open local graph (Ouvrir le graphe local) et réglez la profondeur sur 2.
- Dans les paramètres du graphe, activez Orphans (Orphelines) et observez les notes qui flottent seules. Chacune représente un lien que vous n’avez jamais créé.
Un espace de travail Notion dans IVGraph
- Cliquez sur Se connecter avec Notion sur ivgraph.com et autorisez l’accès dans la fenêtre de Notion.
- Attendez la fin de la première synchronisation. Comptez environ deux minutes pour un petit espace de travail.
- Ouvrez le graphe, recherchez un projet pour voir tout ce qui y est lié, puis essayez la disposition en sphère.
Documents dans Neo4j
- Créez une instance AuraDB Free sur console.neo4j.io et téléchargez son fichier d’identifiants. Aucun moyen de paiement n’est nécessaire.
- Ouvrez LLM Knowledge Graph Builder et déposez le fichier d’identifiants dans sa boîte de dialogue de connexion.
- Ajoutez deux ou trois PDF ou un lien vers une page web, choisissez un modèle et générez le graphe. Posez ensuite une question dans le chat et vérifiez quels extraits ont été utilisés pour formuler la réponse.
Quelle que soit l’approche choisie, évaluez le résultat à partir d’une question que vous vous posez réellement. Si le graphe vous permet d’y répondre plus vite qu’une recherche, continuez. Sinon, le problème vient généralement de liens manquants dans vos données, et non de l’outil.
FAQ
Quel est le meilleur logiciel de graphes de connaissances ?
Aucun n’est le meilleur dans tous les cas ; tout dépend de l’usage. Pour vos propres notes, utilisez Obsidian, Logseq ou Anytype, ou IVGraph si vos notes sont dans Notion. Pour stocker et interroger un graphe, utilisez une base de données orientée graphe comme Neo4j, qui propose une offre cloud gratuite et une Community Edition gratuite, ou GraphDB pour les données RDF. Pour l’analyse visuelle, utilisez Gephi ou Cytoscape. Pour créer un graphe à partir de documents à l’aide de l’IA, essayez LLM Knowledge Graph Builder de Neo4j, Microsoft GraphRAG ou LightRAG. Pour la mémoire des agents, utilisez le serveur de mémoire MCP ou Graphiti.
Existe-t-il des outils de graphe de connaissances gratuits ou open source ?
Oui. Outils open source : Logseq, Neo4j Community Edition, ArcadeDB, Gephi et Gephi Lite, Cytoscape, Neo4j LLM Knowledge Graph Builder, Microsoft GraphRAG, LightRAG, Graphiti et le serveur de mémoire MCP. Gratuits, mais pas open source : Obsidian, yEd, GraphDB Free, Stardog Free, Neo4j AuraDB Free et IVGraph jusqu’à 500 nœuds. Memgraph, FalkorDB et Anytype publient leur code sous des licences donnant accès au code source, mais qui en restreignent certains usages commerciaux.
Quel outil utiliser pour créer un graphe de connaissances personnel ?
Commencez par une application de prise de notes qui relie les notes entre elles et représente ces liens sous forme de graphe : Obsidian, Logseq ou Anytype. Si vos notes sont dans Notion, IVGraph affiche votre espace de travail sous forme de graphe 3D de pages, de mentions et de propriétés Relation des bases de données. Pour analyser le texte lui-même et en repérer les thèmes et les lacunes, ajoutez InfraNodus. Les notes personnelles nécessitent rarement une base de données orientée graphe.
Quelle est la différence entre un outil de graphe de connaissances et une base de données graphe ?
Une base de données graphe est un type d’outil de graphe de connaissances : elle stocke des nœuds et des relations et répond à des requêtes écrites dans des langages comme Cypher ou SPARQL. Les outils de graphe de connaissances comprennent aussi les applications de prise de notes qui représentent vos liens, les outils de visualisation comme Gephi, les outils de création de graphes par IA qui extraient un graphe à partir d’un texte et les serveurs de mémoire pour les agents IA. De nombreux projets en combinent plusieurs.